什么是混合检索?语义理解与关键词匹配的平衡之道
在构建 RAG(检索增强生成)系统时,开发者常面临一个典型痛点:当用户询问包含特定错误码、型号或专业术语的问题时,纯向量检索往往返回一堆语义相近但缺乏关键细节的文档,反而漏掉了真正包含该错误码的记录。这并非模型能力不足,而是检索策略过于单一所致。
混合检索(Hybrid Search)正是为了解决这一“单腿走路”的困境而生的。它结合了向量检索的语义理解能力与关键词检索的精确匹配能力,旨在更稳定地召回相关文档。
为什么单一检索方式存在局限?
要理解混合检索的价值,首先需要明确向量检索和关键词检索各自的短板。
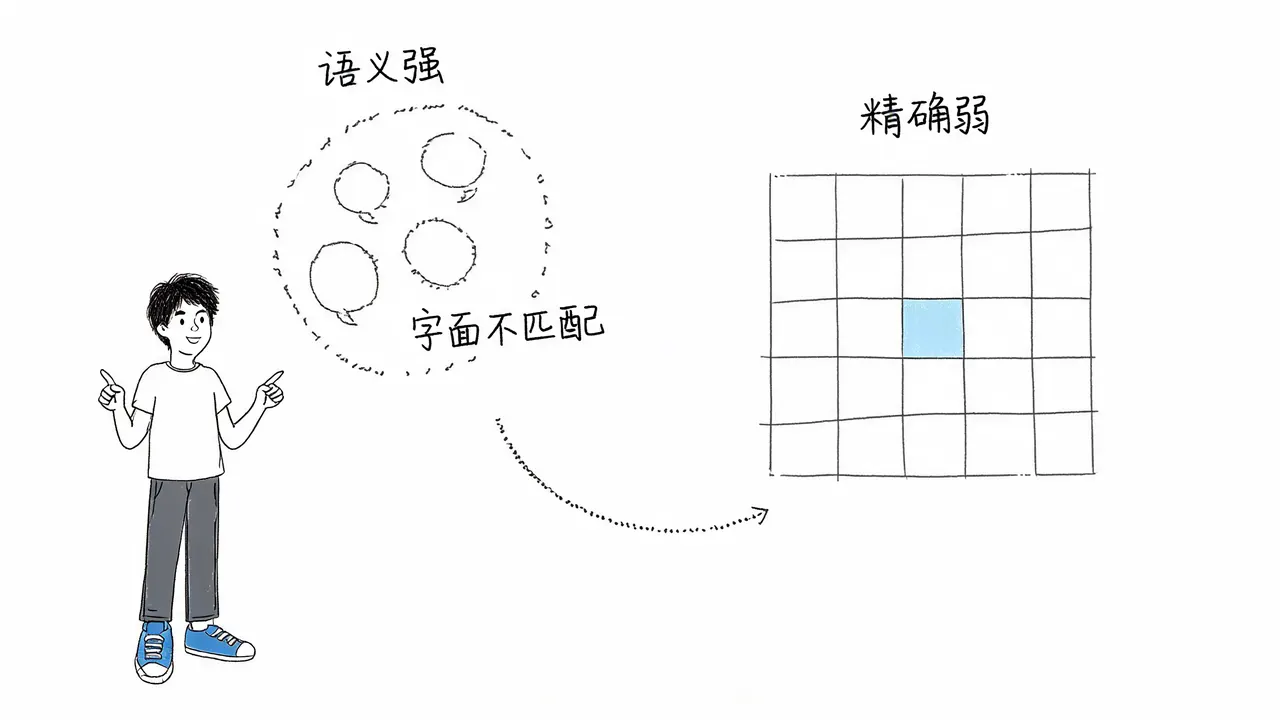
向量检索:语义强,精确弱
向量检索通过将问题和文档转化为向量,比对语义距离。它的强项在于处理模糊表达、概念相近或同义改写的场景。然而,对于编号、人名、型号等“语义稀薄”的内容,向量检索往往难以精准命中。因为这些内容的语义特征不明显,仅靠相似度计算容易遗漏关键信息。
关键词检索:精确强,语义弱
关键词检索(如基于倒排索引和 BM25 算法)依靠词面匹配,能够精确命中字面内容。但它缺乏语义理解能力。例如,用户询问“交通补贴”,而文档中写的是“差旅费用”,关键词检索可能因为字面不匹配而返回零结果。
混合检索的核心定义与流程
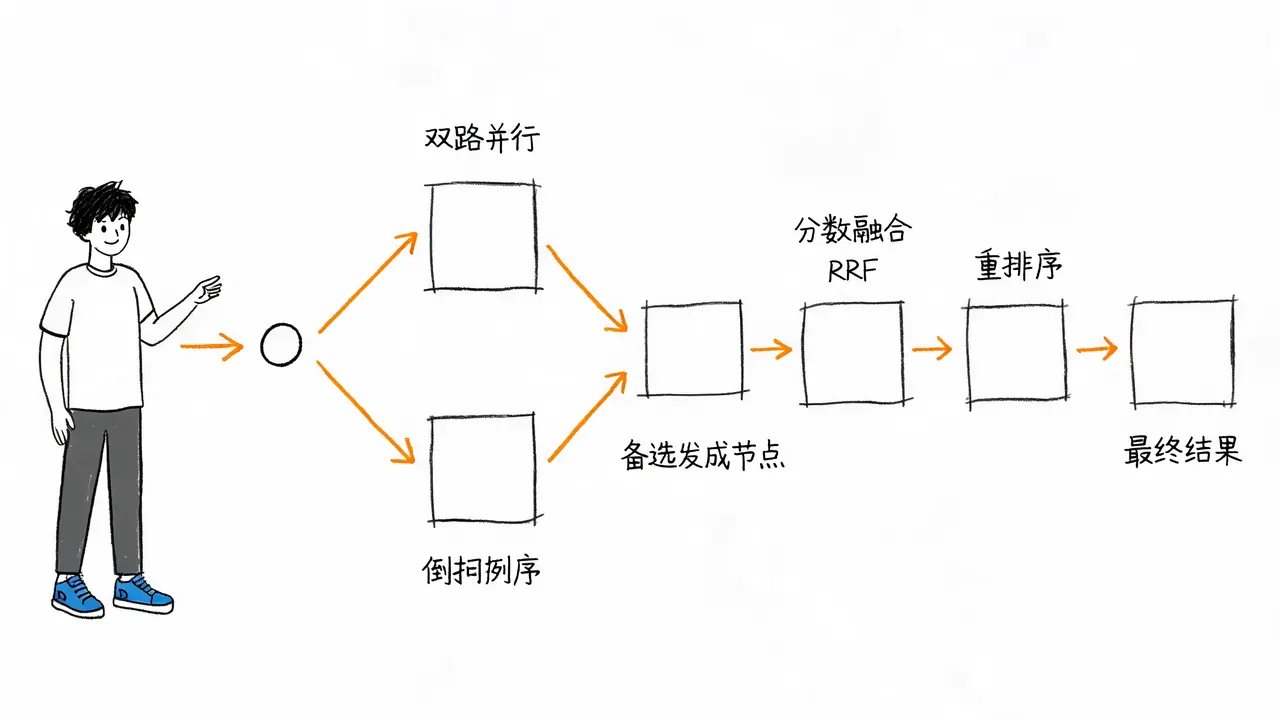
混合检索的本质是双路召回 + 融合排序。它不是简单的“查两遍”,而是一个包含并行检索、候选生成、分数融合与重排的完整流水线。
1. 双路并行检索
用户问题进入系统后,会被复制成两份查询:
- 向量路:发送给向量数据库,负责语义召回。
- 关键词路:发送给倒排索引库,负责精确命中。 这两步是同时进行的,旨在互补:向量库捞回意思相关的文档,关键词库捞回字面命中的文档。
2. 候选生成
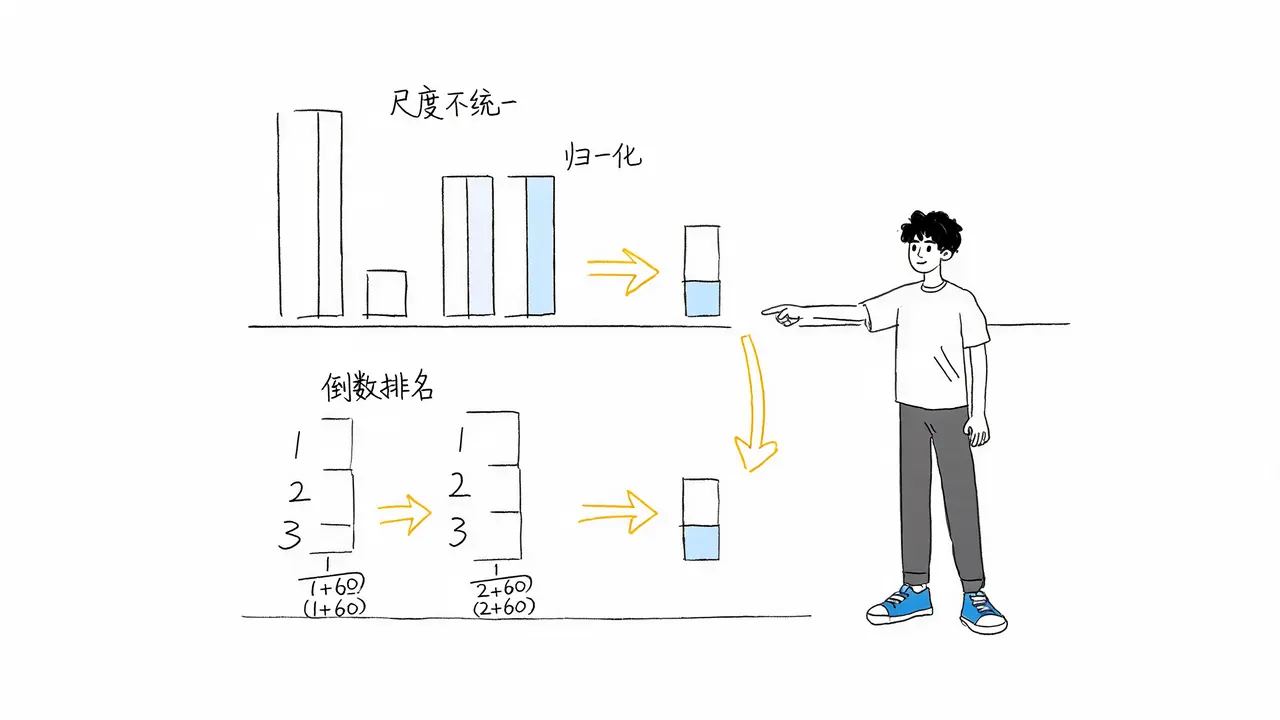
两路检索各自返回一批候选片段。此时,候选集可能包含重复数据,且两路的得分尺度完全不同(向量得分通常是 0-1 之间的相似度,而 BM25 分数范围不同)。
3. 分数融合与重排(核心难点)
这是混合检索中最容易被忽略但最关键的技术环节。直接将两路得分相加是无效的,因为尺度不统一。工程上通常采用以下策略:
- 归一化加权:先对分数进行归一化处理,再根据权重进行加权求和。
- 倒数排名融合(RRF):只看排名位次,避开分数尺度不统一的问题,是一种稳健的融合方法。
- 重排序模型(Reranker):将候选文档交给专门的重排序模型进行重新打分,进一步提升排序精度。
混合检索解决了什么问题?
通过对比可以发现,混合检索显著提升了召回的稳定性:
| 检索方式 | 优势 | 劣势 | 典型场景表现 |
|---|---|---|---|
| 单走向量 | 理解同义词、模糊表达 | 漏掉术语、编号、精确字面 | 问“交通补贴”,可能召回“差旅费用”相关文档,但漏掉含“交通补贴”字样的精确条款。 |
| 单走关键词 | 精确命中字面、术语 | 无法理解同义改写、语义变化 | 问“交通补贴”,若文档写“差旅费”,则可能无结果。 |
| 混合检索 | 互补性强,召回率更稳 | 需调优权重和融合策略 | 向量召回“差旅费用管理办法”,关键词精确命中“交通补贴”,两者结合提供完整证据。 |
在技术文档场景中,函数名、错误码、版本号等必须一字不差的内容,混合检索能确保既不漏掉语义相关的背景知识,也不丢失精确的技术细节。
落地混合检索的关键挑战
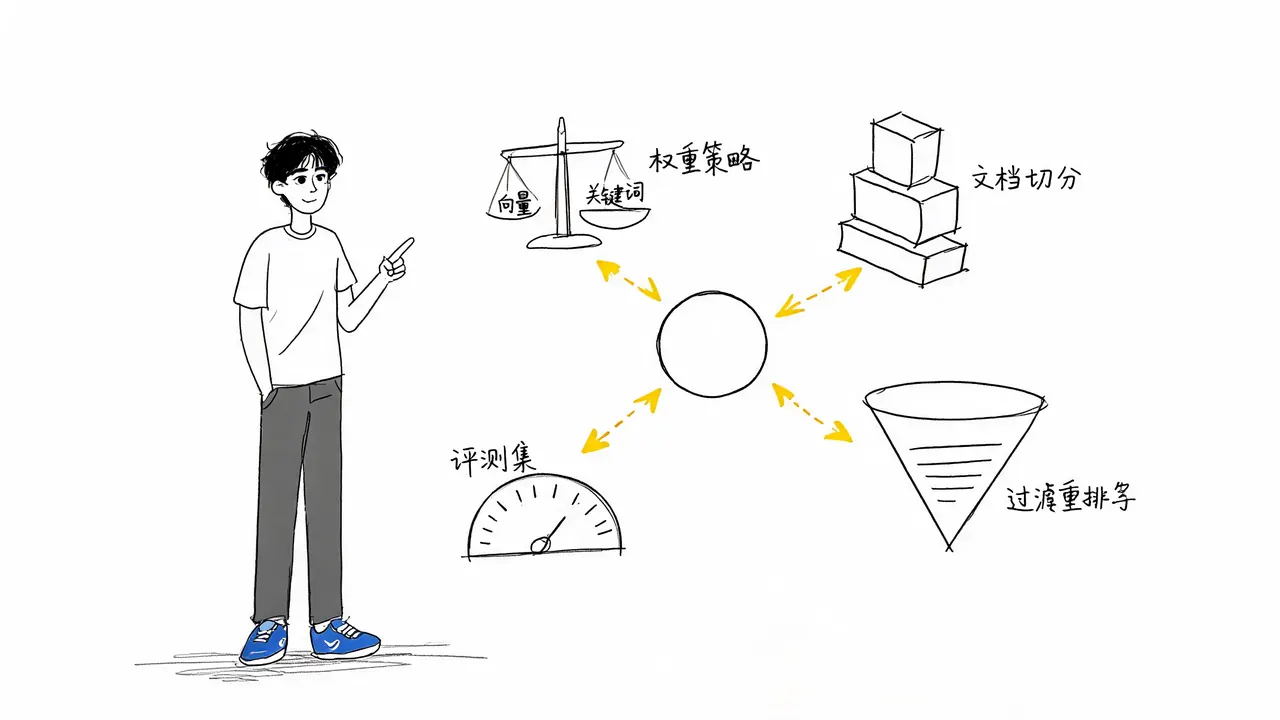
混合检索并非“打开即变强”的开关,其效果高度依赖以下四个工程细节:
- 权重策略:如果权重设置不当,关键词检索的噪音可能会挤掉高质量的结果。需要根据业务场景动态调整向量与关键词的权重比例。
- 文档切分(Chunking):切分是地基。如果文档切分质量差,双路检索都会失效。合理的切分粒度直接影响召回精度。
- 重排序机制:引入 Reranker 是提升系统上线效果的重要选项,但会增加计算成本,需权衡性能与效果。
- 评测集构建:没有评测集,调参就是盲目尝试。必须建立严谨的评测指标,结合具体语料进行验证,才能确保混合检索真正提升了召回鲁棒性。
面试与实战总结
在技术面试或项目复盘中,可以从以下四点阐述混合检索:
- 定义:混合检索是 RAG 检索层的双路召回策略,同时使用向量检索和关键词检索,并进行融合排序。
- 原理:向量负责语义理解(同义改写、模糊表达),关键词负责精确匹配(术语、编号、字面命中),两者互补。
- 流程:并行检索 -> 合并去重 -> 分数融合(如 RRF 或加权) -> 重排序(可选) -> 送入 LLM。
- 边界与调优:强调其对文档切分、索引质量、权重分配和评测指标的依赖。能具体说明使用的融合算法(如 RRF)和评测集构建方法,是体现落地经验的关键。
核心结论:好的检索既要听懂意思,也不能丢掉字面证据。向量负责理解语义,关键词负责精确匹配,最终通过融合排序将最相关的证据送到模型面前,从而提升 RAG 系统的整体可靠性。