大模型 PDF 解析乱套?RAG 文档处理指南:如何保住结构与证据链
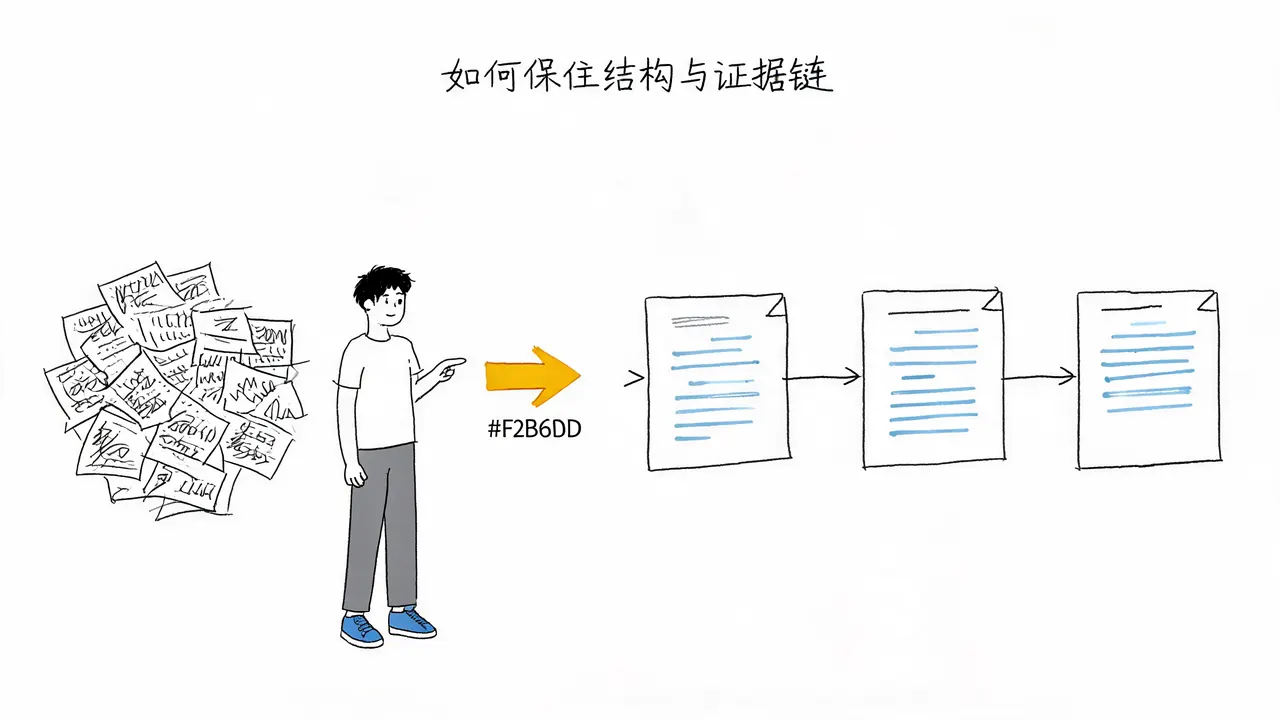
在企业级知识库构建或财报分析场景中,一个常见的痛点是:PDF 文档中的原始数据明明准确无误,但经过 RAG(检索增强生成)系统的解析、切块和检索后,表头丢失、图片消失,生成的答案甚至无法回溯到原始出处。
做 PDF 的大模型问答,最难的根本不是提取文字,而是如何确保文档的结构和证据链条在整条链路中保持保真。如果文档被简单切碎,大模型往往无法区分某句“利润增长 3%"是来自哪家公司、哪一年的财报,也无法判断这是正文中的客套话还是核心表格中的关键数据。
本文旨在从工程痛点出发,拆解背后的处理逻辑,探讨如何在工程上保住这些关键信息。
核心误区:保留“身份信息”而非仅提取文字
文档处理的核心指标,并非看文字识别(OCR)抽出了多少个字,而是看是否保留了内容的身份信息。
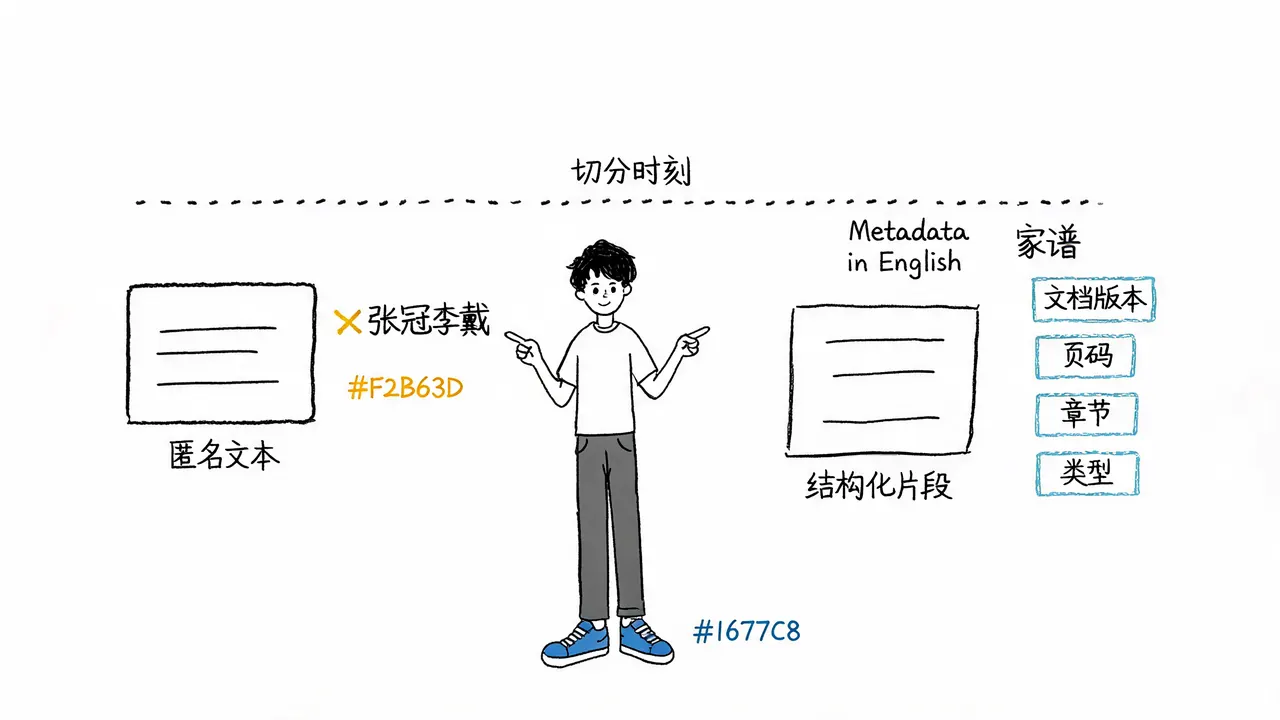
最常见的错误做法是:拿到文档后,直接按固定字数切碎,然后扔进向量数据库。这种将文档磨成“匿名文本”的做法后果致命。当系统检索回一句“利润增长 3%"时,大模型缺乏上下文,不知道其来源文档、版本、页码、章节,也不知道它是正文还是表格数据。
正确的做法是: 每个文本片段从切分的那一刻起,就必须带上完整的“家谱”(Metadata)。片段需要明确知道:
- 来自哪一份文档的哪个版本;
- 位于第几页、属于哪一章节;
- 内容类型是正文、表格还是图片。
只有携带这些结构标签,大模型在拼凑答案时才不会张冠李戴。
工程落地第一步:文档分流
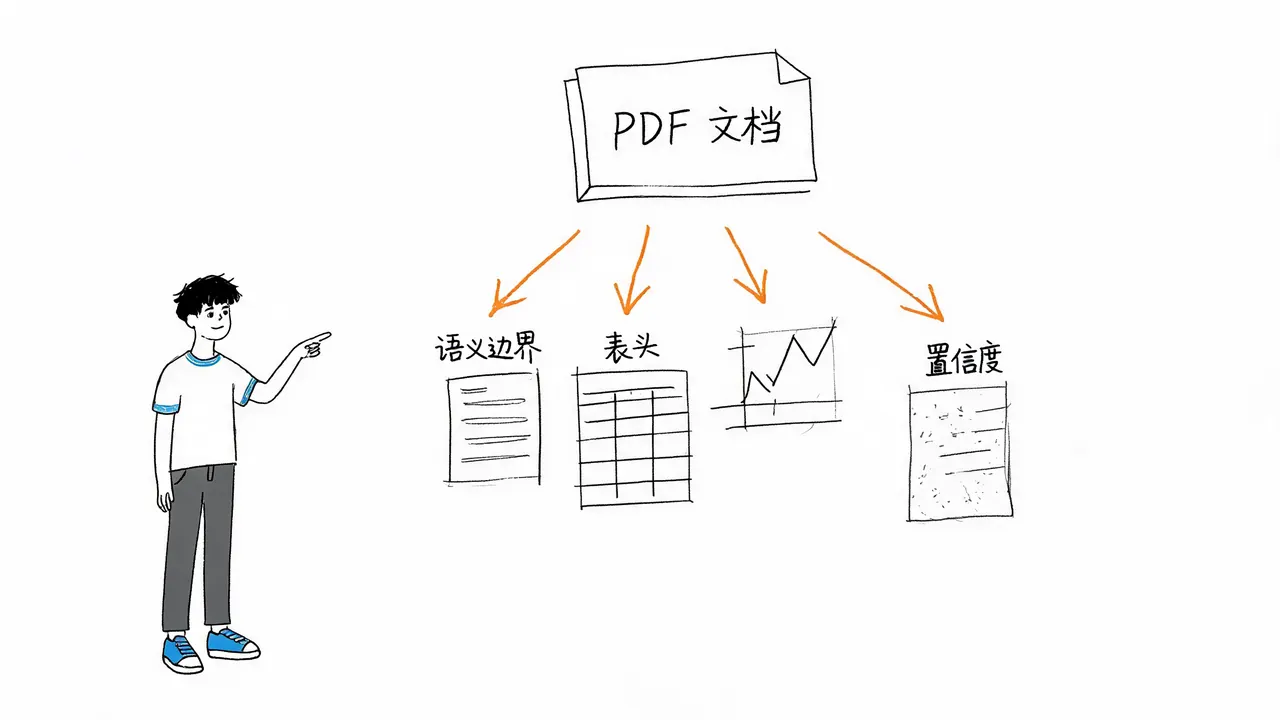
在具体的工程落地中,第一步是做好分流。原生 PDF、扫描件以及图文混排的复杂版面,绝不能套用同一套逻辑硬解。分流之后,针对不同内容类型采取不同的处理策略:
1. 普通正文:按语义边界切分
对于普通正文,应按照标题和段落的语义边界进行切分。
- 保持完整性:确保一句话或一个段落的完整性,避免在半句话处强行切断。
- 避免碎片化:硬切断会破坏语义连贯性,影响后续检索的准确性。
2. 表格:保留结构与对应关系
表格是 RAG 中最让人头疼的部分。
- 保留表头:必须提取并保留表头信息。
- 维持行列对应:确保行列数据的对应关系不被破坏。
- 处理跨页表格:专门处理跨页的序表,合并碎片化的表格数据。
- 后果警示:如果表格的网格结构被破坏,里面的数字对大模型来说就成了一堆毫无意义的乱码。
3. 图表:保留引用与关键数值
遇到图表时,处理策略包括:
- 保存元数据:保留图表标题、图例以及图表中的关键数值。
- 保留原图引用:必须在原始数据中保留原图的引用链接,以便后续视觉模型或人工复核。
4. 扫描件 OCR:记录置信度与坐标
如果使用 OCR 技术提取扫描件,必须记录每个字符的置信度和其在页面上的具体坐标。
- 低置信度处理:如果某区域置信度特别低,说明机器识别困难。
- 正确做法:将该原图区域直接交给视觉大模型(VLM)解析,或标记出来让人工复核。
- 禁止行为:不能让错误的识别结果悄悄混入知识库,这会污染整个检索系统。
答案生成:有理有据的可追溯性
最终生成答案时,系统必须做到“有理有据”。
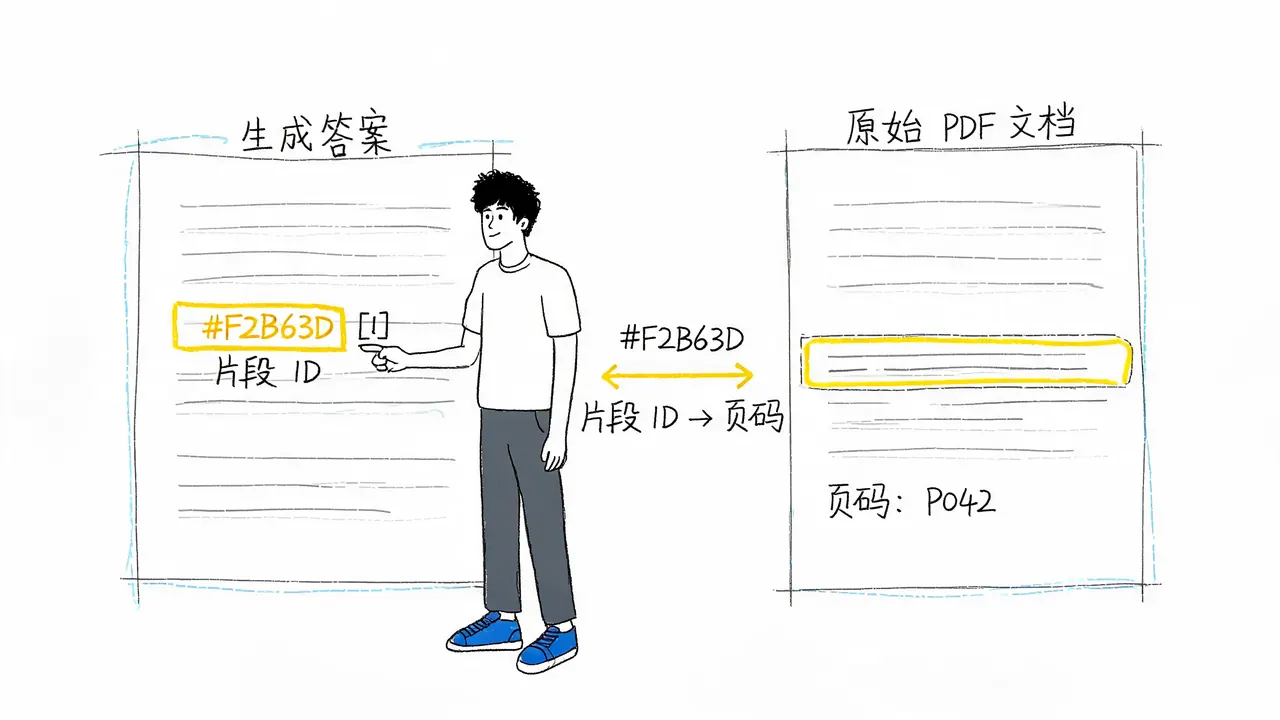
- 精确绑定:系统得出的每一个关键结论,都必须在底层精确绑定对应的片段 ID 和页码。
- 精准跳转:当用户点击答案后的引用序号时,系统应直接跳转到原始文档的对应页码,并精准高亮出对应的段落或表格区域。
- 避免体验断层:不能只是打开几十页文档的首页让用户自行翻找,这种体验对于企业级应用是不可接受的。
故障排查:分离评测解析、召回与生成
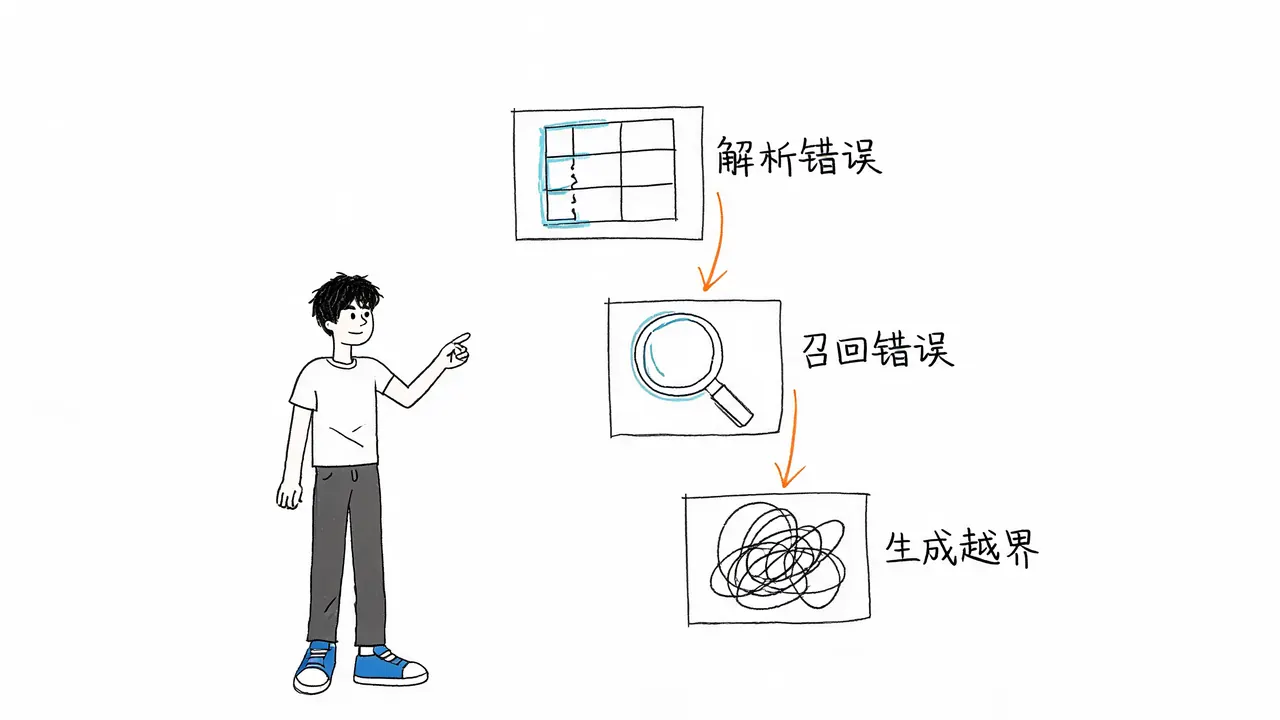
一旦整个问答系统出现问题,必须分开做评测,以定位缺陷根源。只有将以下三类错误分开评估,才能知道该安排哪个模块的工程师去修复:
- 解析错误:版面解析是否把表格拆坏了?结构信息是否丢失?
- 召回错误:向量检索是否根本没有找到那句话?
- 生成越界:大模型是否自己胡编乱造,超出了文档边界?
结语:保住证据的血缘关系
PDF RAG 真正要保住的,是证据的血缘关系。
从最初的版面解析,到中间的切片检索,再到最终大模型的生成,文档的结构、出处和版本信息必须一路同行,缺一不可。只有建立起完整的证据链,大模型才能从“看似聪明”的幻觉生成,转变为“有据可依”的企业级智能助手。