

最新亮点
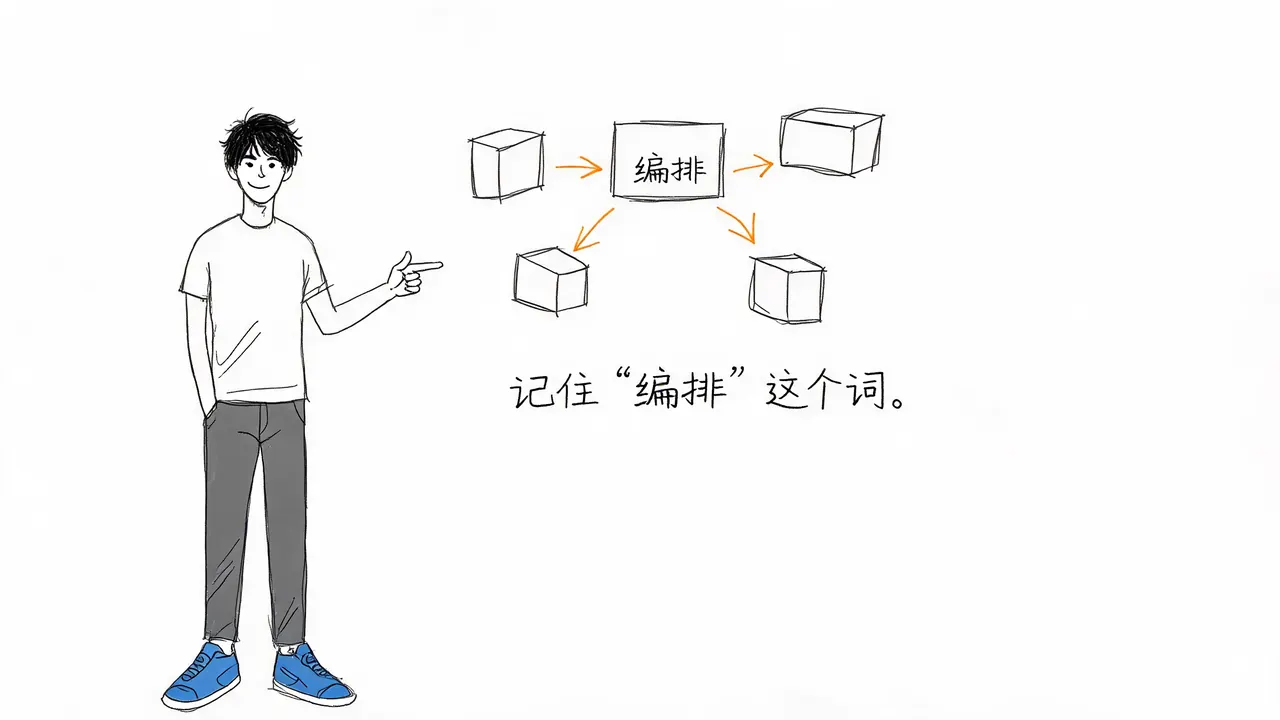
什么是多智能体?核心在于分工与编排,而非数量堆叠
多智能体并非简单的多AI群聊,而是通过编排机制让不同角色、工具和权限的Agent协作。本文解析其工程定义、四种常见架构、潜在代价及适用边界,帮助厘清“分工明确”与“盲目堆叠”的区别。
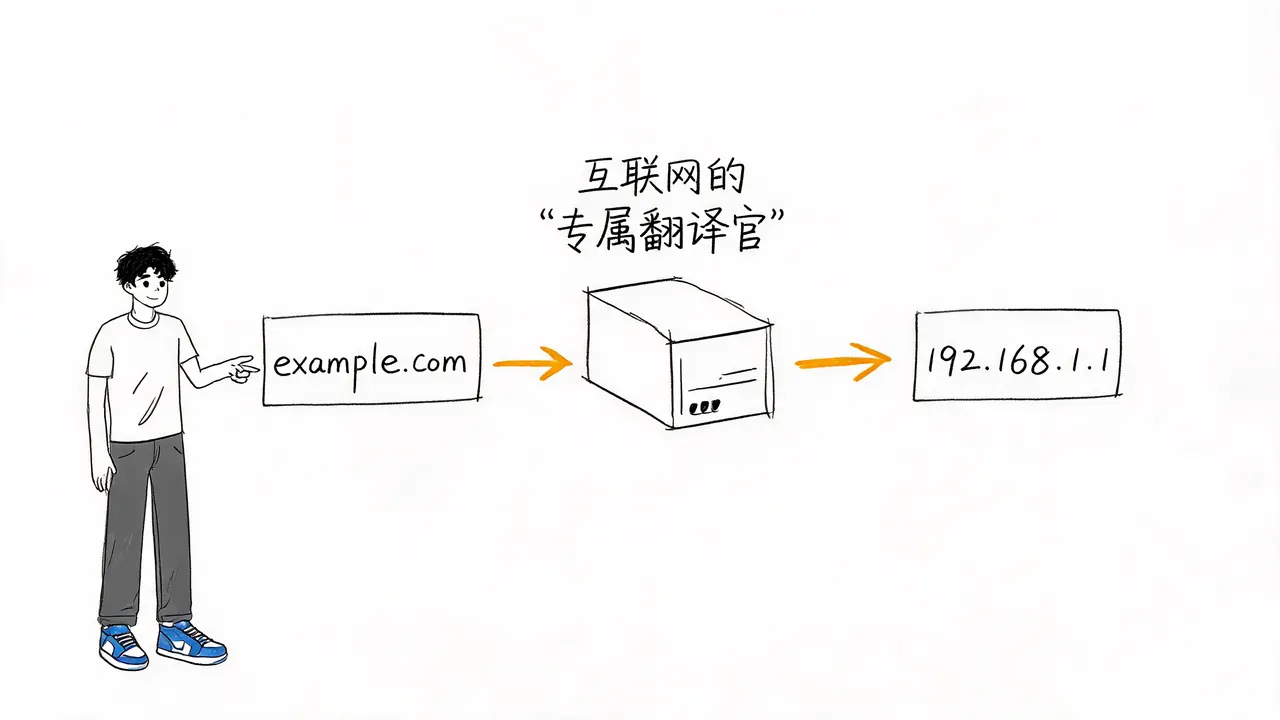
DNS 域名系统详解:互联网背后的翻译官与导航员
深入解析 DNS 域名系统的工作原理,探讨其如何通过四层查询逻辑将人类易记的域名转换为机器可识别的 IP 地址,并阐述其在降低上网门槛、统一标准及优化访问速度方面的核心价值。
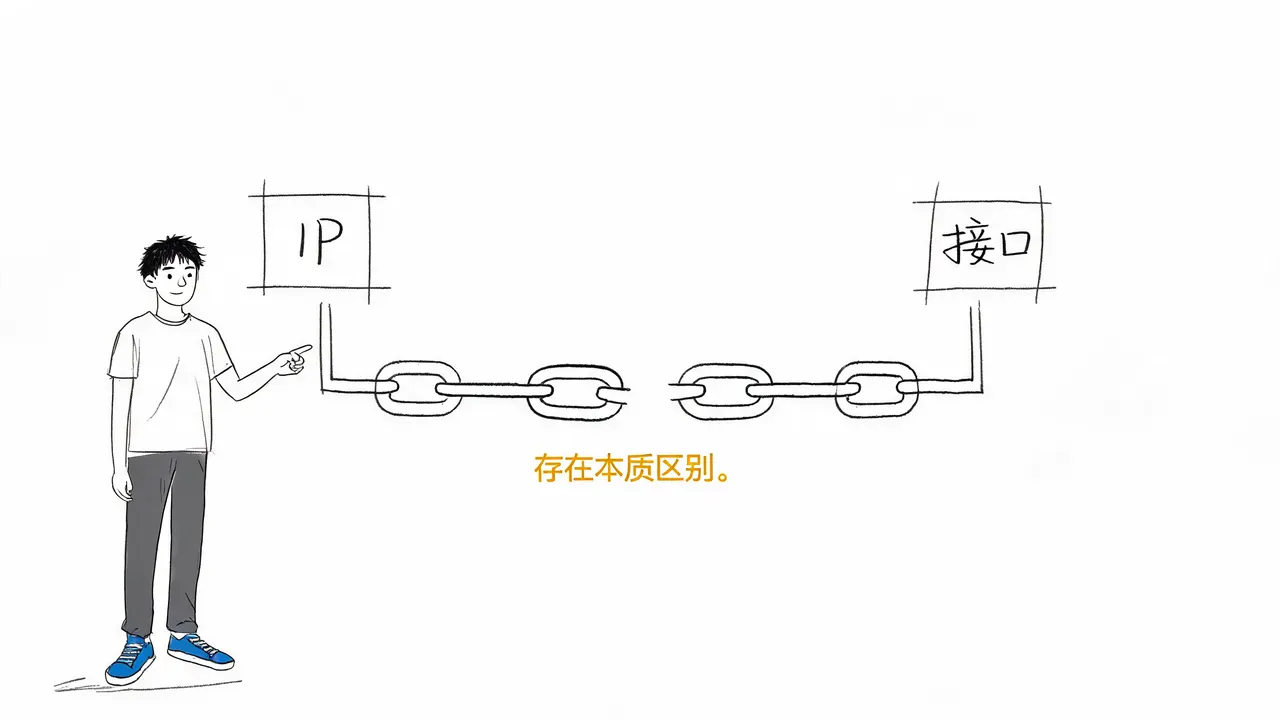
静态路由配置误区:下一跳 IP 与出接口的本质区别
深入解析静态路由中“下一跳 IP”与“出接口”两种配置方式的差异。通过剖析路由器的递归查询机制,明确点对点链路与多路访问链路的配置规范,并提供路由故障排查的优先顺序建议。
最新文章
查看全部文章
为什么异步不用一直等?理解事件循环与主线程的协作机制
本文通过餐厅点餐的类比,深入解析异步编程的核心逻辑。澄清异步并非无需等待或多线程并行,而是将等待过程交给事件循环处理,从而释放主线程执行其他任务,帮助开发者准确区分同步阻塞与异步非阻塞的本质差异。
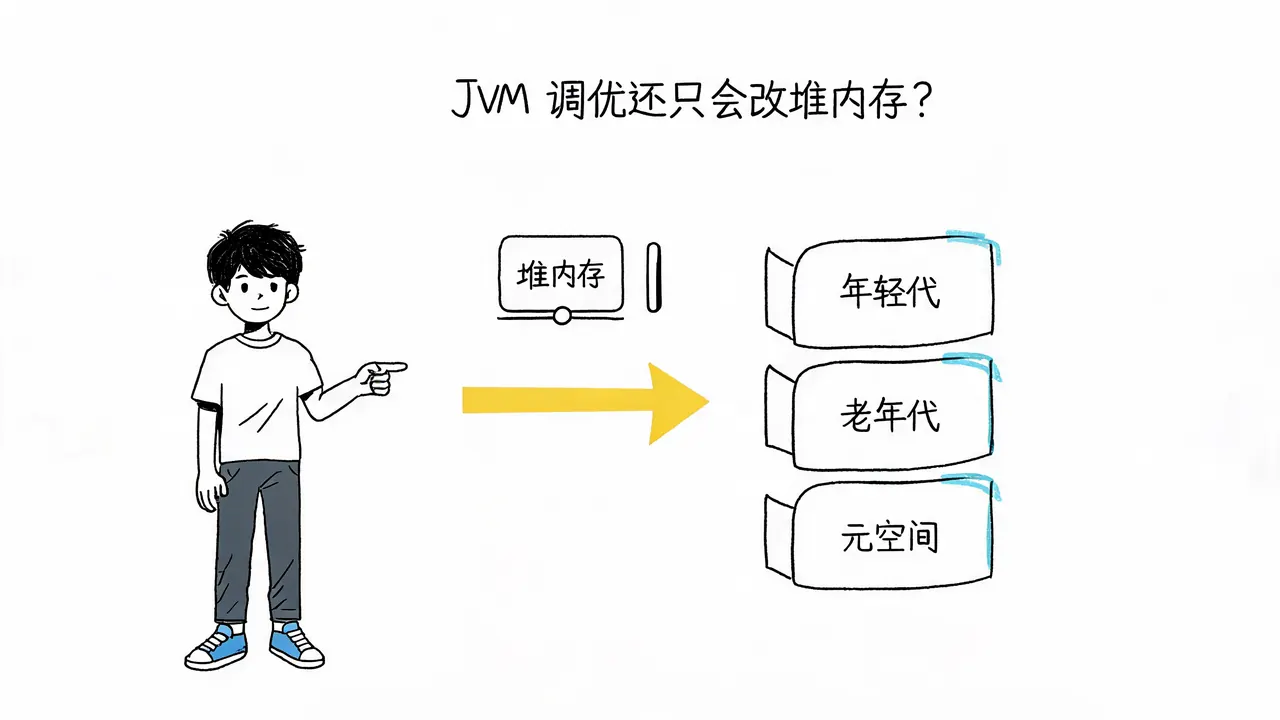
面试官:JVM 调优还只会改堆内存?
本文通过一个真实的面试案例,剖析了将 JVM 调优简单等同于“加大堆内存”的常见误区。文章深入阐述了从问题定位、代码优化到回收器选择的系统化调优思路,帮助开发者掌握大厂面试官看重的底层原理与工程化思维。
OpenClaw 的启示:需求真实存在,但产品尚未完成
OpenClaw 的爆火揭示了 AI Agent 领域的核心矛盾:用户强烈的需求与产品高门槛、低可靠性之间的冲突。本文深入剖析其暴露的七大难题,特别是权限管理与审核机制缺失,并探讨商业产品如何通过完善工程化设计来填补这一空白,最终证明安全与可靠性必须依靠产品设计而非用户热情。
分布式定时任务可靠性设计:从脑裂防护到故障转移的完整方案
本文深入解析分布式定时任务在集群脑裂、节点宕机、任务重叠及积压等场景下的可靠性设计。通过调度层仲裁、执行层幂等、超时检测及分级隔离策略,构建生产级的高可用定时任务体系,帮助后端工程师应对复杂生产环境挑战。
基金小白进阶指南:六步法独立筛选优质基金
本文提供了一套完整的基金筛选六步法,从自我认知、方向选择、指数对比、基本面体检、费率比较到仓位管理与定期复盘,帮助投资者建立独立判断能力,摆脱盲目跟风,通过提升认知和保持耐心实现长期稳健收益。
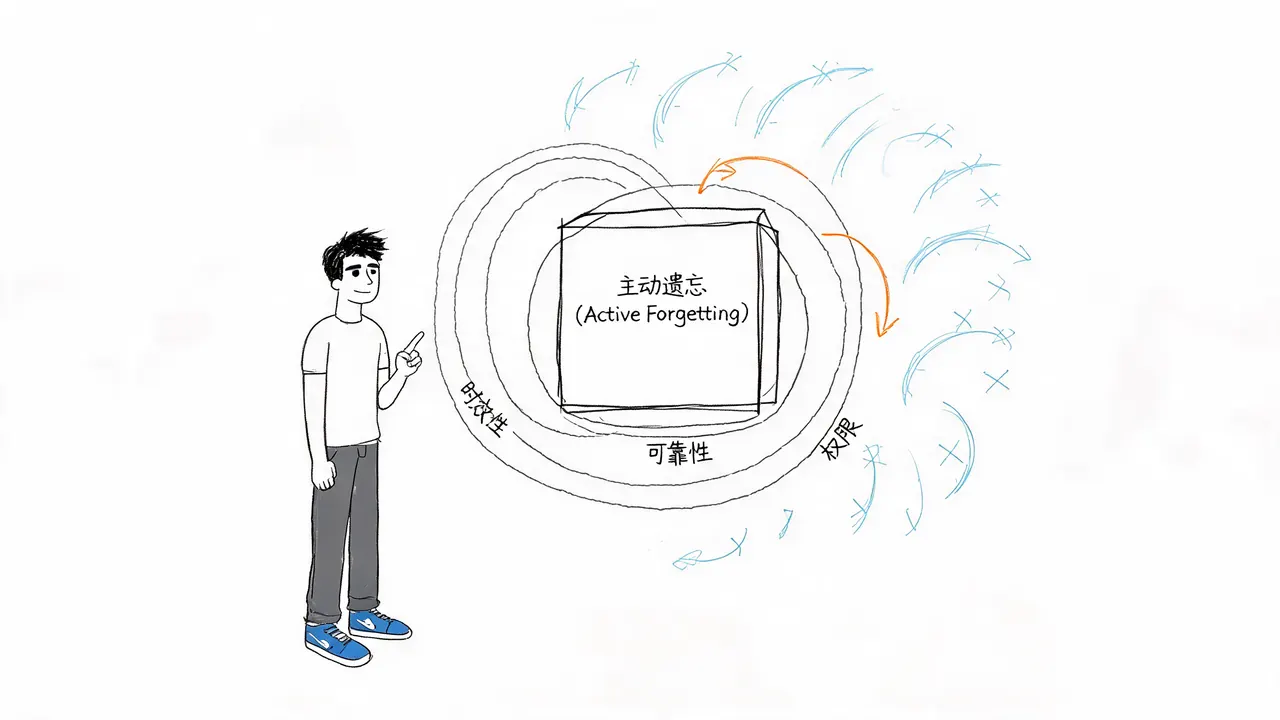
智能体记忆系统:为何 AI 需要主动遗忘与降权?
在 AI 智能体应用中,直接调用最相似的历史记忆并不总是正确的。旧方案可能已过期或权限变更,盲目复用会导致错误结果。本文探讨智能体记忆系统中“主动遗忘”的必要性,包括记忆失效、降权策略及合规审计的处理方法,旨在构建精准、高效且安全的记忆检索机制。
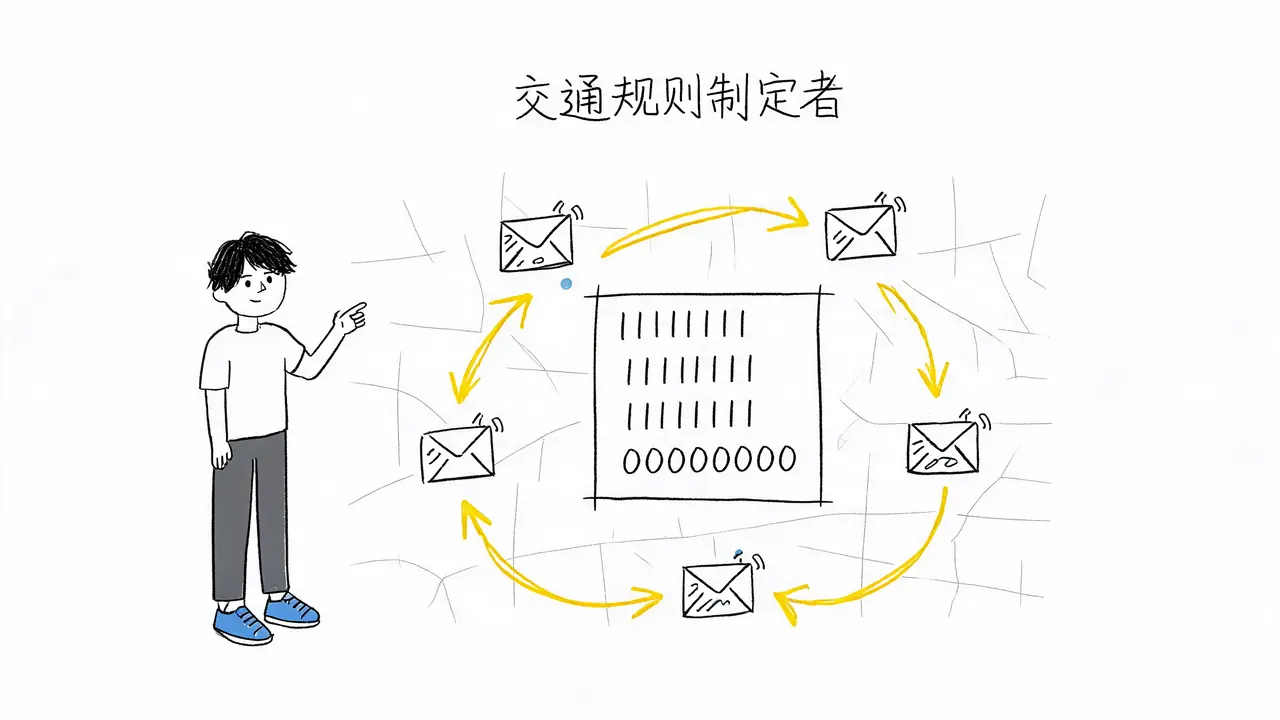
什么是子网掩码?解析网络与主机的边界划分机制
子网掩码是区分IP地址中网络部分与主机部分的关键参数。本文深入解析其32位二进制结构、逻辑与运算原理、子网划分作用及CIDR表示法,帮助理解数据包路由决策机制。
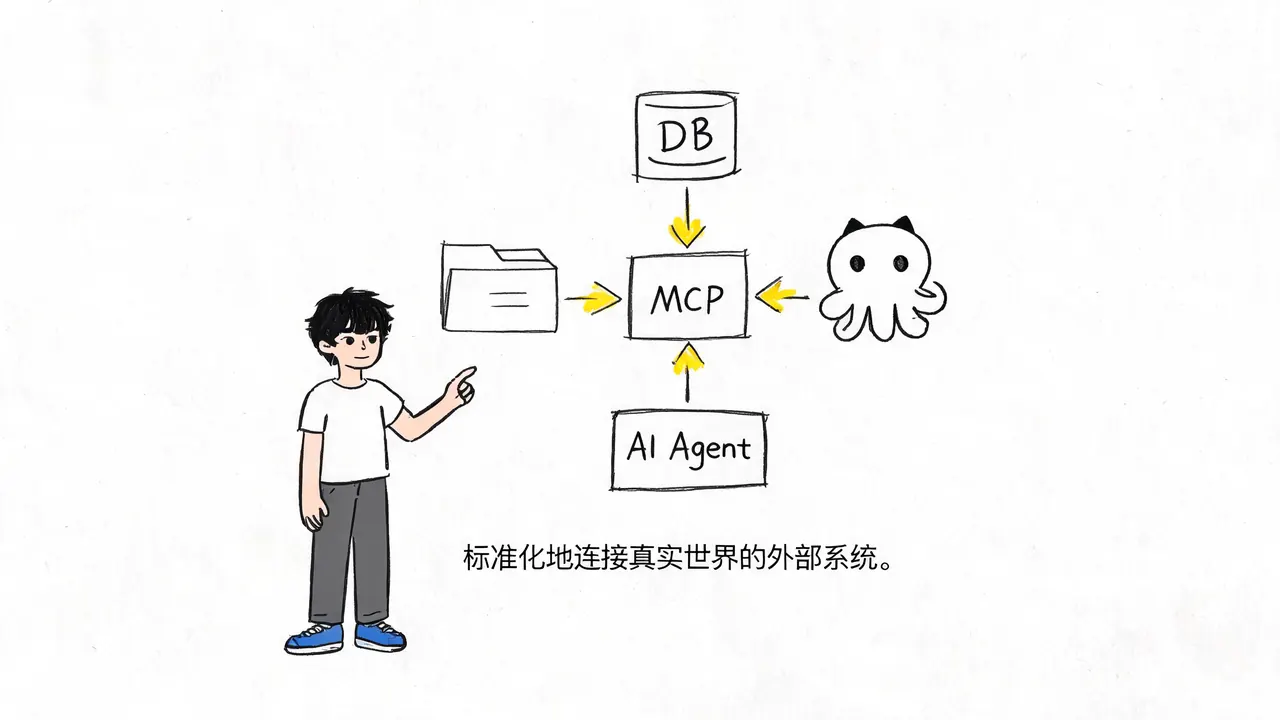
MCP 协议深度解析:Agent 连接真实系统的标准层
本文深入解析 MCP(Model Context Protocol)协议,阐述其如何通过 Host、Client、Server 三层架构解决 AI Agent 连接外部系统的碎片化问题,并明确其作为连接层而非安全或业务闭环层的边界。
数据库连接池耗尽排查与线上连接泄漏兜底策略
深入解析数据库连接池耗尽的排查思路与连接泄漏的兜底方案。从连接池方案对比、风险量化分析到架构落地规范,帮助后端工程师构建高可用的数据库资源防护体系,避免全链路雪崩。
大模型的能力不是写出来的,而是试出来的:从炼金术到实验科学
传统软件依赖代码断言与证明,而大模型的能力无法被推导,只能被测量。本文通过对比蒸汽机与热力学、化学与数学,揭示大模型研发本质上是实验科学,其核心壁垒在于团队积累的“手感经验”而非单一理论突破。
RAG 答不准?可能是文本切分(Chunking)做错了
当 RAG 系统回答不准确时,问题往往不出在模型或向量库,而在于文档切分(Chunking)。本文深入解析文本切分的定义、常见策略、权衡机制及工程实践,帮助你构建高质量的检索地基。
大模型研发的核心竞争力:从智力依赖到实验频率的范式转移
本文探讨大模型研发中“炉次”(有效实验回合数)的核心地位。分析为何智力仅是入场券,算力本质是购买实验机会,以及规模法则如何锁定竞争格局,揭示算力真正拖慢的是人才厚度而非模型分数。