为什么 Transformer 改变了整个 AI?
很多人误以为当前 AI 的爆发式进步,源于科学家写出了更复杂的代码,或是单纯依赖显卡算力的提升。事实上,真正引爆大模型时代的核心驱动力,是一种名为 Transformer 的神经网络架构。
Transformer 本质上是一种处理文字、图像等连续信息的架构。它之所以能改变世界,是因为它彻底颠覆了 AI “阅读”和“思考”的方式。本文将深入解析 Transformer 如何解决传统 AI 的痛点,实现海量数据的并行处理,以及它目前面临的物理边界。
`` 是摘要与正文的分隔标记,请保留。传统 AI 的痛点:排队传话的困境
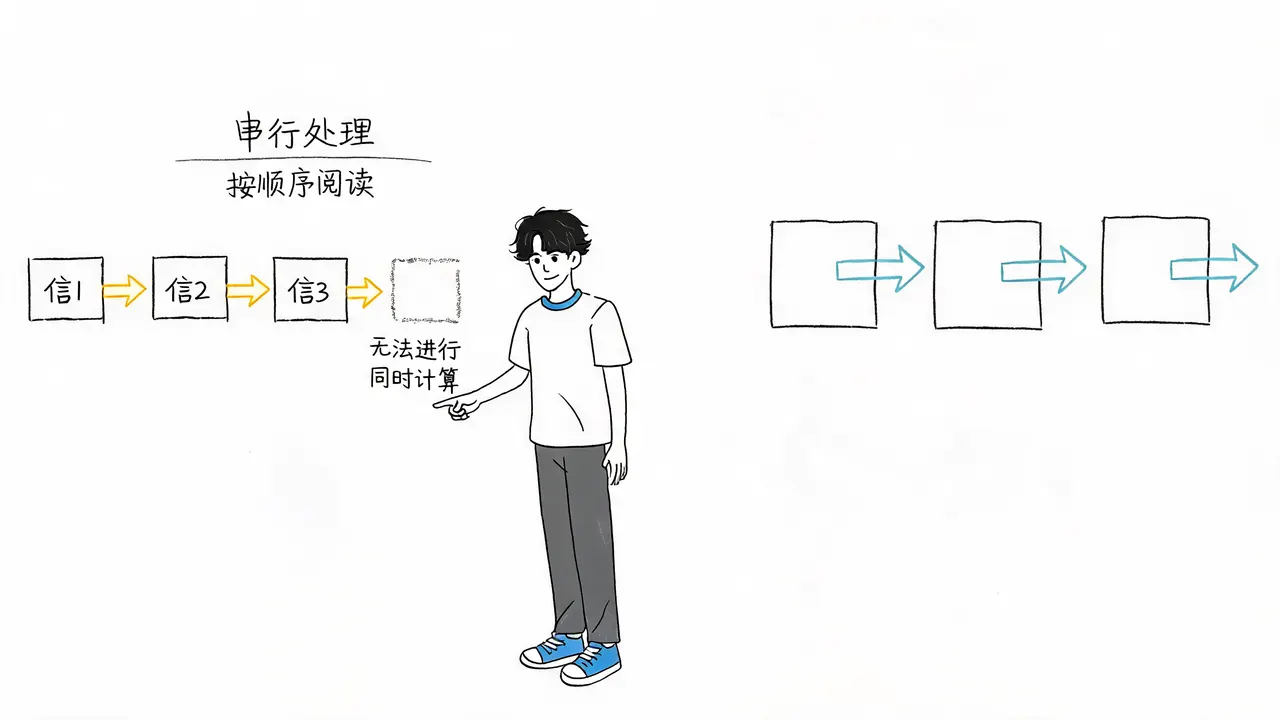
在 Transformer 出现之前,AI 处理语言主要依赖 循环神经网络(RNN)。我们可以将 RNN 的工作方式想象成“排队传话”:
- 串行处理:AI 必须一个字、一个词地按顺序阅读。看完第一个字,将记忆传递给第二个字,再传递给第三个字。
- 致命缺陷一:速度慢。由于必须排队,前面的信息未处理完,后面的信息只能等待,无法进行同时计算。
- 致命缺陷二:容易遗忘。当句子或文本特别长时,传到后面的信息往往会覆盖前面的细节。导致 AI 读到句尾时,已经忘记了句首在说什么,造成上下文理解的断裂。
这种“流水线工人”式的死记硬背模式,严重限制了 AI 处理长文本和复杂逻辑的能力。
核心突破:自注意力机制与圆桌会议
Transformer 直接掀翻了这种排队模式,引入了一个核心机制——自注意力机制(Self-Attention)。
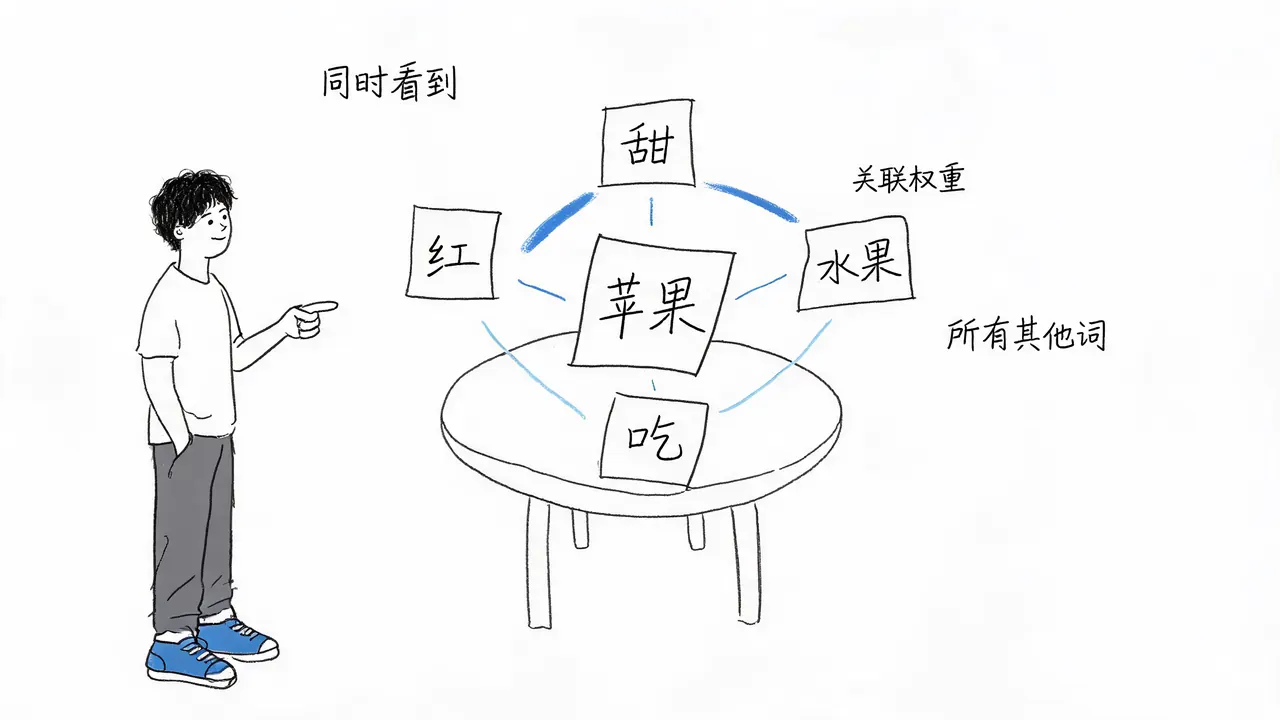
如果说 RNN 是排队传话,那么 Transformer 就像是一场圆桌会议:
- 全局视角:当 AI 阅读一句话时,句子里的每一个词都能同时看到句子里的所有其他词。
- 动态关联:以“苹果”这个词为例,AI 会同时扫描句中的其他词(如“红”、“手机”等),并计算它们之间的关联权重。
- 如果前面出现“字”或“红”,AI 判断这里的“苹果”是水果。
- 如果前面出现“买”或“手机”,AI 判断这是电子产品。
这种机制让 AI 真正理解了上下文语境,无论句子多长,关键信息都不会丢失。每个词都在同时与其他词计算关系,从而实现了语义上的精准捕捉。
效率革命:并行计算与数据涌现
自注意力机制带来的第二个颠覆性优势是并行计算。
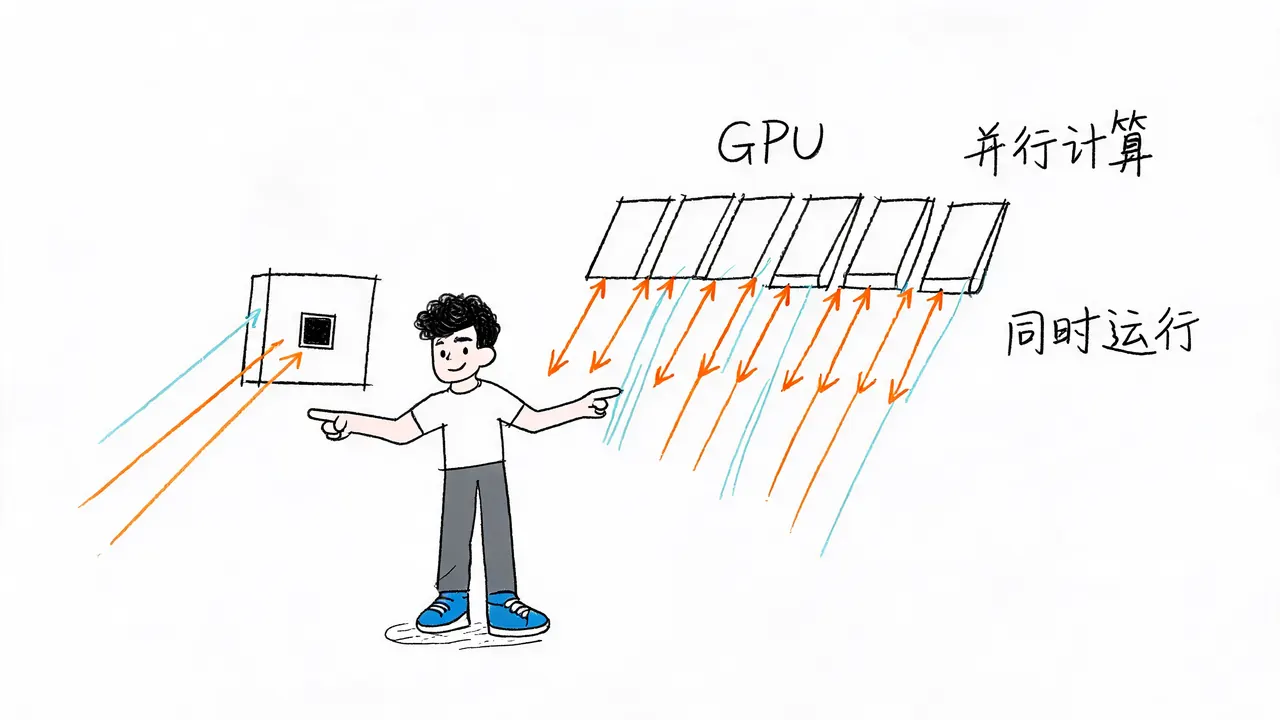
- 从单线程到多线程:传统的排队模式只能单线程工作,而“圆桌会议”允许所有人同时开口。这意味着 Transformer 天然适合在拥有成千上万个核心的 GPU 上同时运行。
- 海量数据训练:计算速度的大幅提升,使得 AI 能在合理时间内“吃下”互联网上几乎所有的文本数据(书籍、代码、对话等)。
- 量变引起质变:当模型看过足够多的数据后,便涌现出了我们看到的逻辑推理和创作能力。
可以说,没有 Transformer 的并行计算能力,就没有今天的大模型时代。
物理边界:上下文窗口与算力成本
尽管 Transformer 强大,但这种“所有人互相看”的机制也有其代价和明确的物理边界。
1. 上下文窗口限制
虽然圆桌会议能同时看全局,但“会议桌”的大小是有限的。如果输入的信息超过了模型设定的窗口长度(例如几十万字的长篇小说),多出来的部分就根本挤不进“会议室”。AI 会对超出部分视而不见,或者开始产生幻觉、胡言乱语。
2. 算力成本暴增
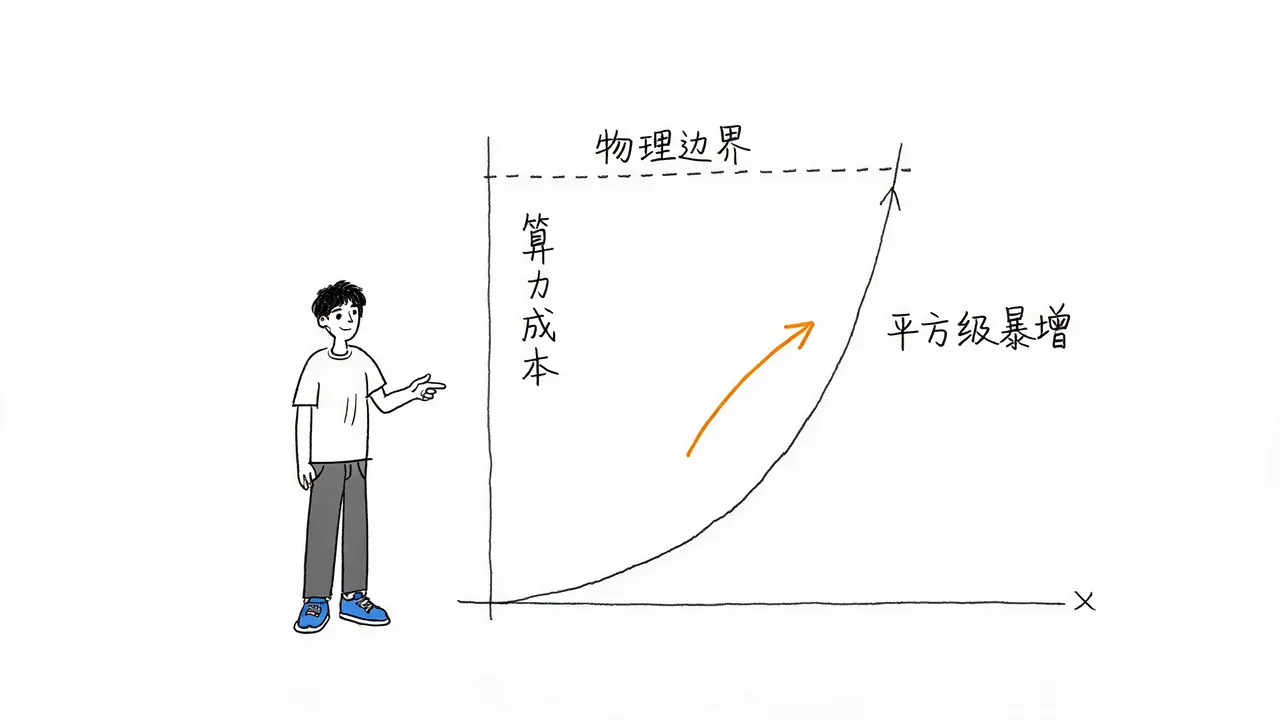
因为每个词都要和所有词计算关系,文本越长,计算量呈平方级暴增。这导致处理超长文本的算力成本极其高昂,成为当前技术演进的主要瓶颈之一。
结语:从流水线工人到超级分析师
Transformer 改变 AI,并不是因为它赋予了机器真正的灵魂,而是它用全局视野和并行计算打破了信息处理的效率瓶颈。
它让 AI 从死记硬背的流水线工人,变成了能同时处理海量信息的超级分析师。看懂了这个底层机制,我们就能明白:未来 AI 的进化方向,依然是在这条打破记忆上限和降低算力成本的道路上继续狂奔。