四年后端经验,被“微服务雪崩防护”问题干沉默了
在微服务架构日益普及的今天,服务治理已成为后端开发的核心能力。然而,许多开发者往往停留在“会用框架”的层面,一旦面对复杂的故障场景,便难以给出系统性的解决方案。
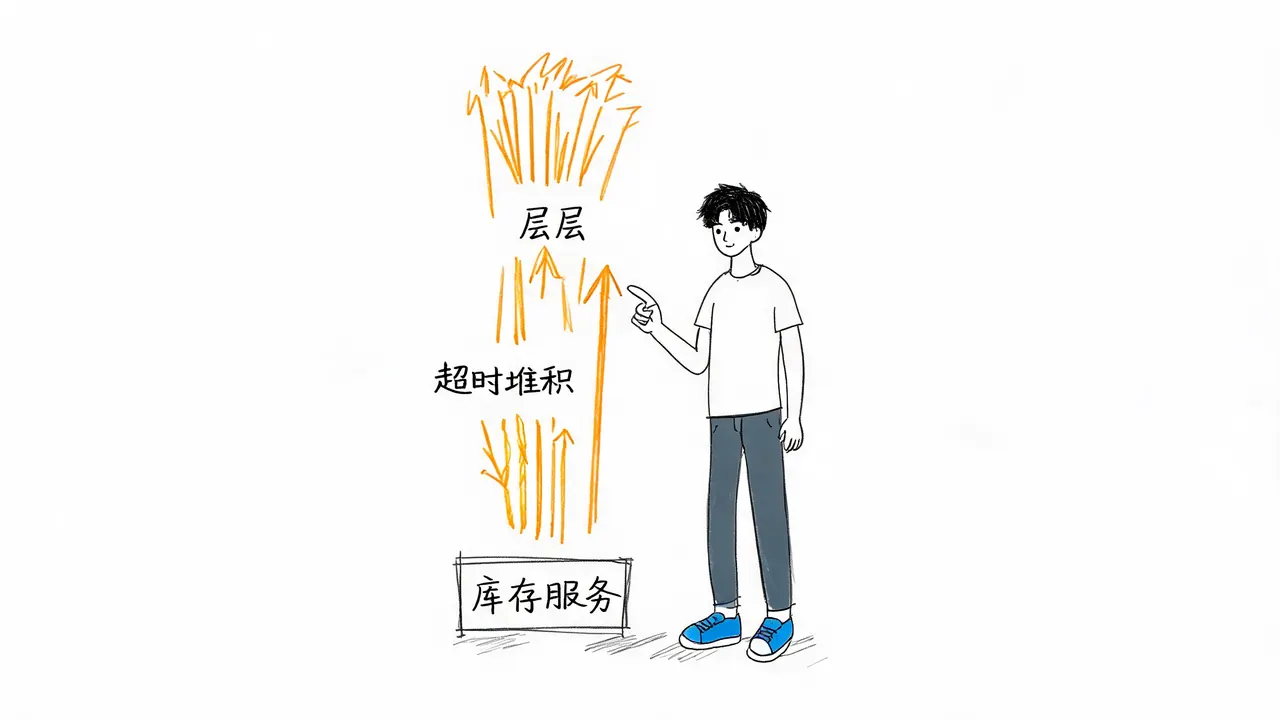
近期,一位拥有四年后端经验的开发者在面试中遭遇了一道关于“微服务雪崩防护”的深度提问。面试官假设底层库存服务突然响应卡死,导致上游订单、支付、网关层层超时堆积,要求候选人阐述如何保证整个链路不被拖垮,且核心交易不中断。
面对这一看似基础实则深奥的问题,该候选人最初回答:“用 Sentinel 配个熔断规则,错误率超过阈值就熔断,返回兜底数据,不行再加点限流。”
然而,面试官并未就此止步,而是通过一系列追问,层层剥开问题的本质:
- 阈值设定的科学性:熔断阈值是拍脑袋设的 50% 吗?设高了雪崩才触发,设低了误杀正常请求,是否有动态校准机制?
- 误伤与抖动的区分:如果下游只是偶尔网络抖动而非真实故障,熔断直接切断所有请求,如何避免误伤?半开状态的探测流量是如何设计的?
- 全链路集联防护:如果调用链有五六层,最底层数据库慢了,层层向上超时,熔断一层层触发,最终导致核心交易链路也被熔断,如何进行分级管控?如何保证越核心的服务越不容易熔断?
- 流量突增与故障的区分:如果不是下游故障,而是上游大促流量突增打满下游连接池,是先限流还是先熔断?如何区分是流量问题还是服务故障?
- 降级逻辑的健壮性:如果不允许使用任何熔断降级框架,纯业务代码层面如何保证降级逻辑出问题时,不会反过来拖垮主业务?
面对这些追问,候选人瞬间慌了,只能回答“把阈值设保守点”或“核心接口不配熔断”,但对于动态阈值校准、全链路集联防护、业务分级降级方案完全没思路。
这正是**“会用熔断组件”与“能设计全链路雪崩防护方案”**的关键分水岭。
雪崩防护设计的三层核心逻辑真正能通过面试的雪崩防护设计,必须吃透以下三层核心逻辑。面试官考察的并非你是否会配置 @SentinelResource 注解,而是你在任何故障场景下,能否做到故障隔离与核心优先。
第一层:明确熔断降级的边界与失效场景
熔断降级的目标不是追求零故障,而是在故障隔离下的有损服务,优先保障核心业务可用。必须覆盖以下失效场景:
- 静态阈值不合理:导致熔断不及时(雪崩后触发)或误杀(正常请求被切断)。
- 服务抖动引发误熔断:短暂的网络波动导致错误率瞬间飙升,触发不必要的熔断。
- 多层调用集联传导:底层故障层层向上,导致全链路雪崩。
- 流量突增与服务故障混淆:无法区分是容量不足还是代码 Bug,导致处置策略错误。
- 降级逻辑自身异常:降级代码执行失败或阻塞,反而拖垮主业务线程。
第二层:核心方案落地,覆盖多种场景
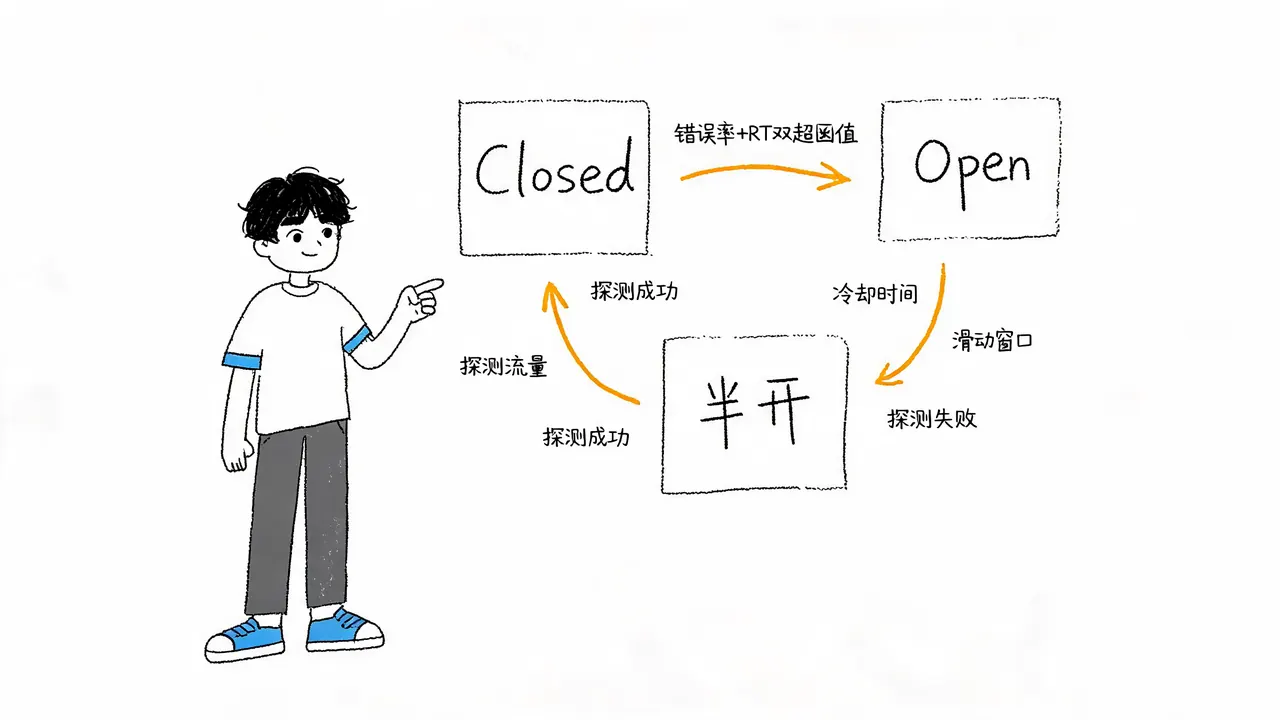
以**“错误率 + 响应时长”双维度熔断**、业务分级降级、半开探测恢复为可靠基线,覆盖全链路场景。
1. 双维度熔断策略
避免单一指标误判,采用滑动窗口统计,同时满足以下两个条件才触发熔断:
- 错误率:统计窗口内异常请求占比超过设定阈值。
- 平均响应时长:统计窗口内平均 RT 超过设定阈值。
这种双指标机制能有效区分“慢”和“错”,减少因单一网络抖动导致的误熔断。
2. 半开状态与探测恢复
熔断触发后,服务进入**半开(Half-Open)**状态:
- 梯度放行:按一定比例(如 10%)放行探测流量。
- 动态决策:根据探测流量的成功率决定是恢复服务(Closed)还是保持熔断(Open)。
- 避免冲击:防止服务刚恢复时因流量过大再次崩溃。
3. 业务分级治理
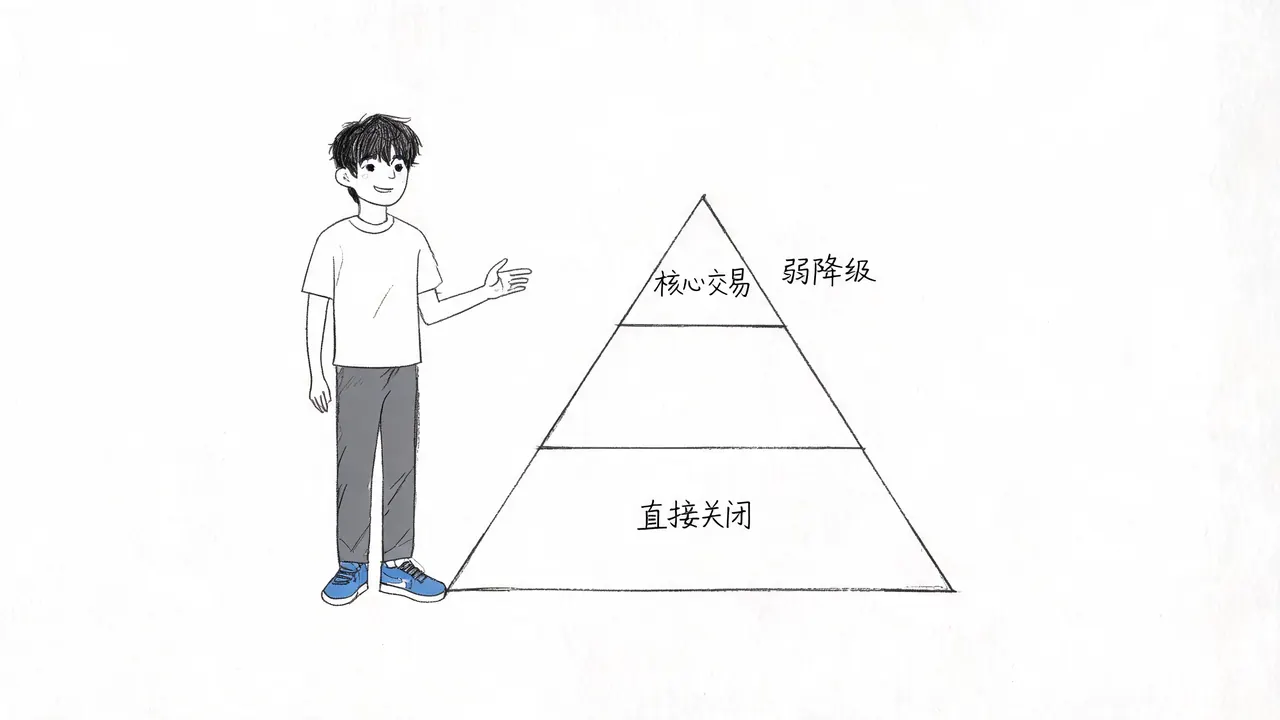
不同业务接口的重要性不同,降级策略应有所区别:
- 核心交易接口(如下单、支付):弱降级。尽量保证可用,仅在极端情况下熔断,且熔断后需有强兜底逻辑。
- 非核心查询接口(如商品详情、历史订单):强降级。快速熔断,返回缓存数据或默认值。
- 边缘运营接口(如数据统计、推荐位):直接关闭。故障时直接返回空或错误码,不占用资源。
4. 流量突增与服务故障的联动处置
- 流量突增场景:优先触发限流。通过 QPS 或并发数限制,保护下游不被打满。
- 服务故障场景:优先触发熔断。快速失败,避免线程堆积。
- 联动机制:两者需协同工作。例如,限流后若错误率依然升高,则触发熔断;熔断恢复后,若流量依然过大,则继续限流。
第三层:生产落地的异常处理细节
在实际生产环境中,细节决定成败。以下是几个关键的工程落地经验:
1. 阈值动态校准
静态阈值往往难以适应业务波动。应基于历史基线数据自动调整熔断阈值:
- 业务高峰期:自动收紧阈值,提高敏感度,快速隔离故障。
- 业务低谷期:自动放宽阈值,避免误杀。
2. 集联熔断防护
防止底层故障层层向上传导,导致全链路雪崩:
- 降级标识传递:上游熔断时,向下传递降级标识。
- 下游优先保障:下游服务收到标识后,优先保障核心接口,非核心接口直接快速失败。
- 核心服务保护:越核心的服务,熔断阈值应越保守,恢复策略应越谨慎。
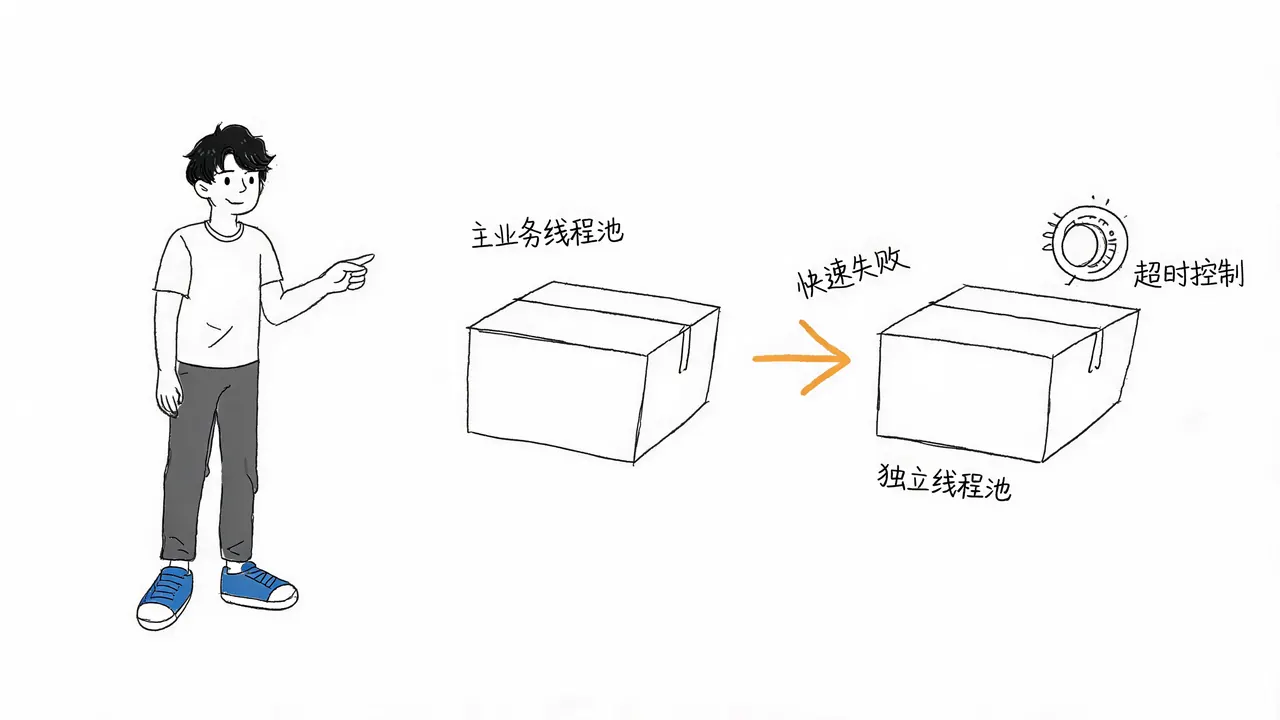
3. 降级逻辑物理隔离
降级逻辑本身也可能出错,必须确保其不影响主业务:
- 独立线程池:降级代码在单独的线程池中执行,与主业务线程池隔离。
- 快速失败:降级逻辑执行失败时,直接丢弃或返回默认值,绝不阻塞主业务线程。
- 超时控制:为降级逻辑设置严格的超时时间,防止长时间占用资源。
4. 热点服务单独配置
避免全局规则“一刀切”:
- 热点参数限流:针对特定热点参数(如热门商品 ID)单独配置限流规则。
- 差异化阈值:不同服务、不同接口根据其重要性和资源消耗,配置不同的熔断和限流阈值。
5. 监控与告警
建立完善的监控体系,实时掌握系统健康状态:
- 关键指标:熔断触发次数、降级请求占比、半开恢复成功率、集联熔断次数。
- 多级告警:设置不同级别的告警阈值,确保故障能被及时发现和处理。
6. 极端降级方案(保命模式)
当全链路故障,常规手段无法控制时,开启保命模式:
- 只保留核心链路:仅保留下单、支付、库存扣减等核心交易链路。
- 关闭非核心功能:关闭所有非核心查询、运营统计、推荐等接口。
- 最大限度保障主流程:确保核心业务可用,牺牲非核心功能以换取系统稳定性。
面试官问雪崩防护,根本不是考你会不会配熔断规则,而是考察以下三点:
- 识别真实生产坑:能否识别阈值误判、集联雪崩、降级逻辑异常等真实生产问题。
- 分级降级思维:是否知道按业务等级进行分级降级,而非一刀切。
- 工程落地经验:是否有动态阈值、半开探测、集联防护、极端保命模式等工程落地经验。
普通后端只会对着框架配规则、加注解,遇到问题只会说“把阈值调高点”。
大厂后端能徒手设计一套包含双维度熔断、分级降级、半开恢复、动态校准、集联防护的完整雪崩防护方案,扛得住服务故障、流量突增、集联传导、全链路压力等各种复杂场景。
这就是专业与业余的区别,也是面试中拉开差距的关键所在。