深度解析 HashMap:从 O(1) 查找原理到 JDK 1.8 结构演进
在高级后端开发面试中,HashMap 是考察 Java 集合框架深度的经典题目。许多候选人往往只能回答出“数组加链表”这一表层结构,却难以解释其为何能在存在哈希冲突的情况下依然保持接近 O(1) 的查找效率。
本文将基于底层实现原理,从哈希寻址机制、JDK 1.8 的结构演进以及生产环境中的性能陷阱三个层面,深度解析 HashMap 的高性能本质。
`` 是摘要与正文的分隔标记,请保留。核心优势:哈希寻址与高效定位
HashMap 的核心优势并非单纯依赖数组的快速访问,而是通过哈希寻址将查找的时间复杂度从线性降低到常数级。
1. 理想状态下的 O(1) 查找
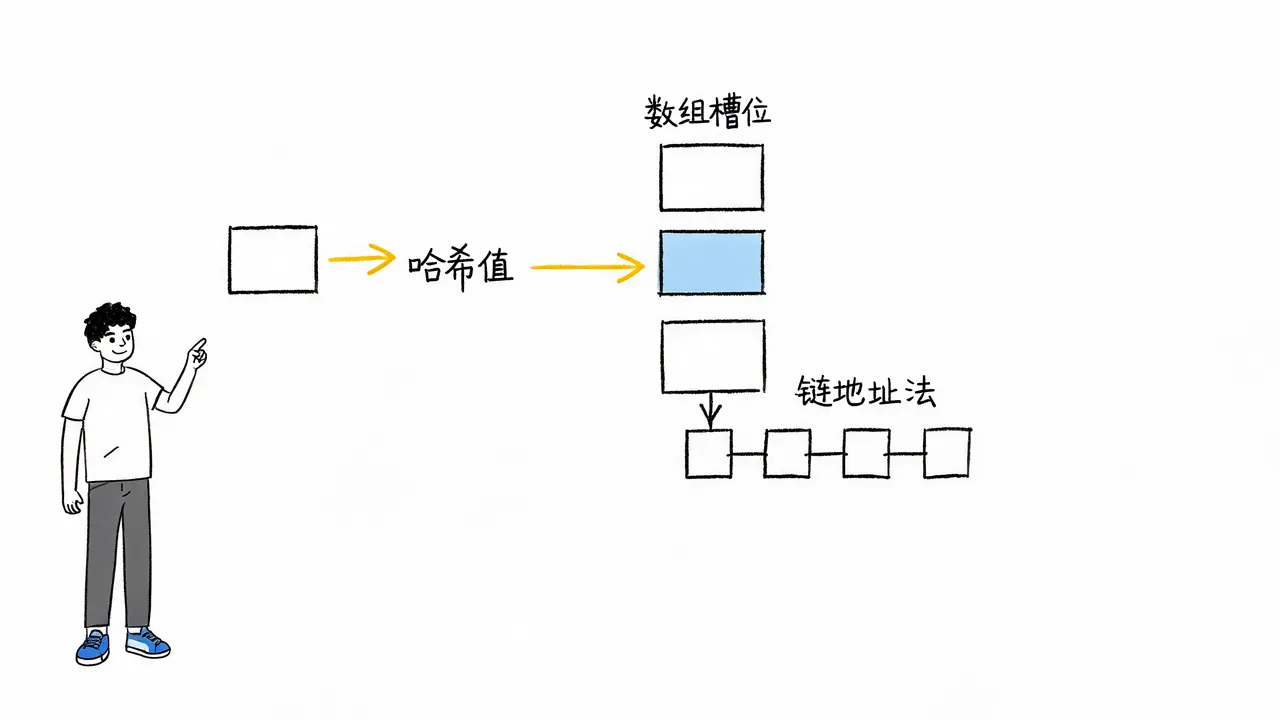
我们常说的 O(1) 查找,是指在理想无冲突情况下的平均复杂度。其本质是利用哈希函数将任意键(Key)映射为数组下标,从而跳过逐一遍历,直接定位存储位置。
2. 链地址法解决冲突
真实场景中哈希冲突不可避免。HashMap 采用链地址法(Separate Chaining)以最低成本解决这一问题:
- 挂载机制:相同哈希值的元素挂载在同一个数组槽位的链表上。
- 查询流程:先通过哈希定位数组位置,再遍历极短的链表。
- 性能表现:在绝大多数正常场景下,链表长度仅为 1 到 2,额外遍历开销可忽略不计。
3. 被忽视的基石:扰动函数与 2 的幂容量
仅理解“数组加链表”是不够的,扰动函数与容量设计才是高效寻址的关键:
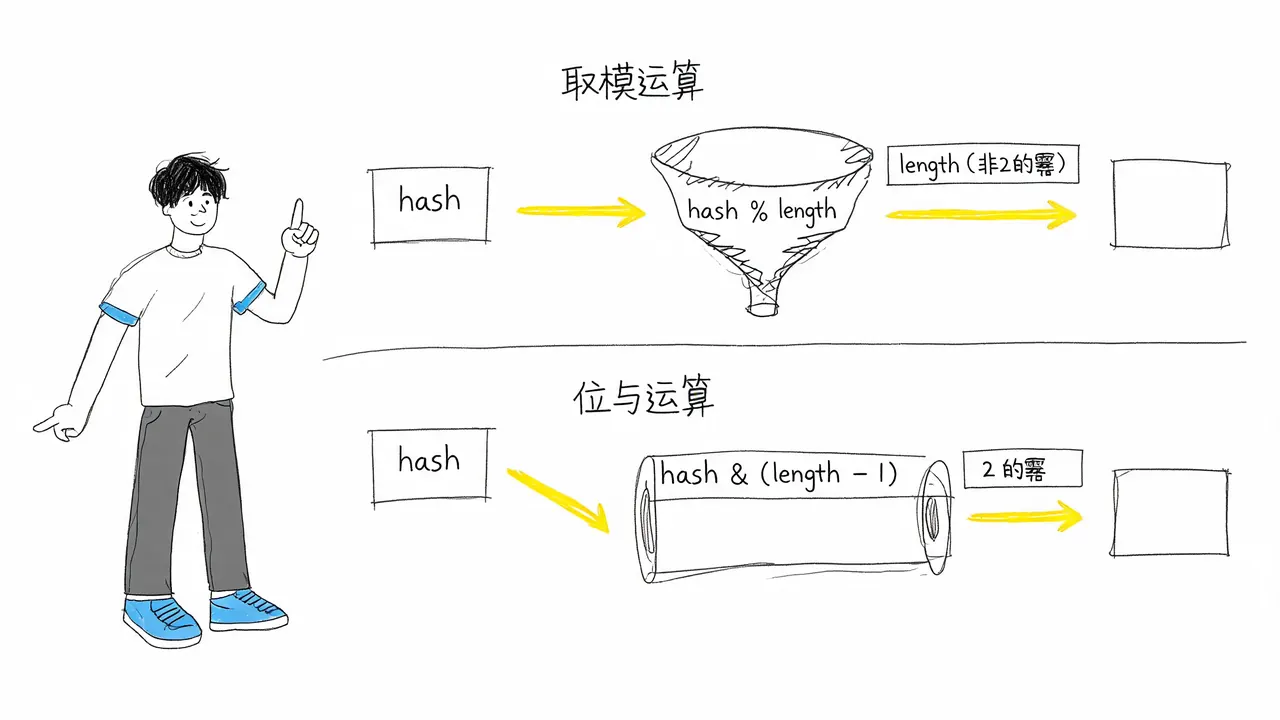
- 扰动函数(Perturbation Function): HashMap 并非直接对哈希值取模,而是通过扰动函数打散哈希值的高位。这一操作大幅降低了不同 Key 映射到同一桶(Bucket)的概率,从而减少碰撞。
- 2 的幂容量(Power of Two Capacity):
HashMap 强制要求数组容量为 2 的幂次方。这使得取模运算(
hash % length)可以替换为位与运算(hash & (length - 1))。位运算的计算速度比取模运算提升一个数量级,这是性能优化的重要细节。
JDK 1.8 结构演进:红黑树引入与扩容优化
JDK 1.8 对 HashMap 进行了重大重构,将纯链表结构升级为链表 + 红黑树的双结构,并优化了扩容机制。这一改动并非为了替代链表,而是为了应对极端场景下的性能瓶颈。
1. 红黑树:极端场景的性能兜底
当哈希冲突严重导致链表过长时,查找性能会退化为 O(N)。在恶意构造哈希碰撞的场景下,甚至可能引发服务拒绝攻击(DoS)。
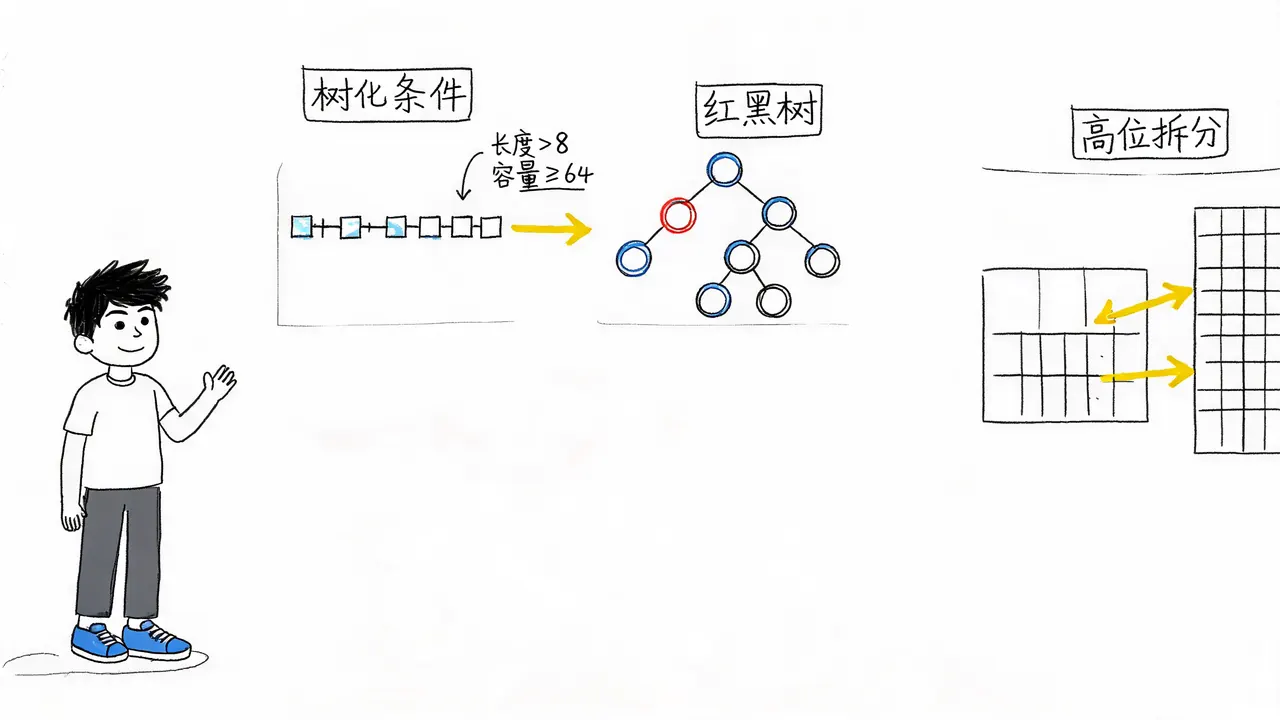
- 树化条件:只有当链表长度超过 8 且数组容量大于等于 64 时,链表才会转换为红黑树。
- 性能收益:树化后,查询复杂度从 O(N) 降低到 O(log N),避免了极端情况下的性能雪崩。
- 工程取舍:HashMap 没有将所有节点都改为红黑树,而是“短链用链表,长链用红黑树”。这种设计平衡了插入/删除的开销(红黑树维护成本高)与查询性能,是经典的工程权衡。
2. 扩容机制重构
JDK 1.8 优化了扩容(Resize)过程:
- 无需重新计算哈希:扩容时,元素不需要重新计算哈希值。
- 高位拆分:直接根据原哈希值的高位(即新增的那一位)判断元素是留在原位置还是移动到原位置 + 旧容量的位置。
- 效率提升:这一机制大幅提升了扩容效率,减少了 CPU 消耗。
生产环境陷阱:参数配置与线程安全
理解底层原理后,还需关注生产环境中真正拖垮 HashMap 的因素。往往不是元素数量,而是不合理的参数配置与错误的使用方式。
1. 常见性能反模式
- 初始容量设置过小:导致频繁扩容,触发多次数组复制和元素迁移。
- 负载因子(Load Factor)过高:默认值为 0.75,若设置过高会导致冲突激增,链表变长,查询变慢。
- Key 对象哈希实现不合理:如果自定义 Key 的
hashCode()方法分布不均,会导致大量碰撞,使 HashMap 退化为链表甚至红黑树,性能指数级下降。 - 循环内反复创建 HashMap:在循环中频繁创建并扩容 HashMap 对象,会造成巨大的 GC 压力。
2. 线程安全:最大的生产隐患
HashMap 不是线程安全的。 在并发场景下使用 HashMap 可能导致严重故障:
- 数据丢失:并发
put操作可能导致覆盖。 - Size 计数错误:并发修改导致
size字段不准确。 - 死循环风险:虽然 JDK 1.8 优化了头插法为尾插法,降低了死循环概率,但并发修改仍可能导致数据不一致或异常。
建议:在并发场景下,应使用 ConcurrentHashMap 或 Collections.synchronizedMap。
3. 内存泄漏风险
- 自定义 Key 未重写
equals和hashCode:导致无法正确移除元素,造成内存泄漏。 - 长生命周期持有大对象:如果 HashMap 生命周期较长,且 Key 或 Value 是大对象,未及时清理会导致 OOM(内存溢出)。
总结:如何回答“HashMap 为什么快”
在面试中,回答 HashMap 的性能问题应涵盖以下三个层次,展现深度理解:
- 核心机制:利用哈希函数实现常数级寻址,配合扰动函数打散高位和2 的幂容量使用位运算,将碰撞概率和计算开销压到最低。
- 结构演进:JDK 1.8 引入红黑树作为极端冲突场景的性能兜底,并优化扩容机制,平衡了插入开销与查询性能。
- 工程实践:认识到性能不仅取决于结构,更取决于合理的初始容量、负载因子配置,以及避免在非线程安全场景下误用。
掌握这些底层细节,不仅能应对面试,更能帮助开发者在实际项目中写出高性能、高可用的代码。