面试官:线程池耗尽怎么救?线上参数怎么设计才不踩坑?
在高级后端开发面试中,一个经典且极具区分度的问题是:“当项目高峰期线程池打满、任务堆积、接口大面积超时,你是如何排查和优化的?”
许多拥有三年经验的开发者往往给出的答案是:“调大核心线程数和最大线程数。”然而,这种回答通常会导致面试失败。面试官会进一步追问:线程数调大后,CPU上下文切换频繁导致吞吐量下降的原因是什么?线程泄漏如何精准定位?流量洪峰下如何快速降级止损?
如果只能依靠重启服务和盲目调大参数来保底,说明候选人缺乏对高并发场景下线程资源风险识别与防御性设计的核心能力。这正是普通后端与高级后端的核心分水岭。
误区:配置参数不等于掌握线程池
很多后端开发者存在一个误区,认为只要能够提交任务、参数配置正确,就算“会用”线程池。然而,单机线程池配置与分布式环境下的资源管控是两个完全不同的技术维度,不能混为一谈。
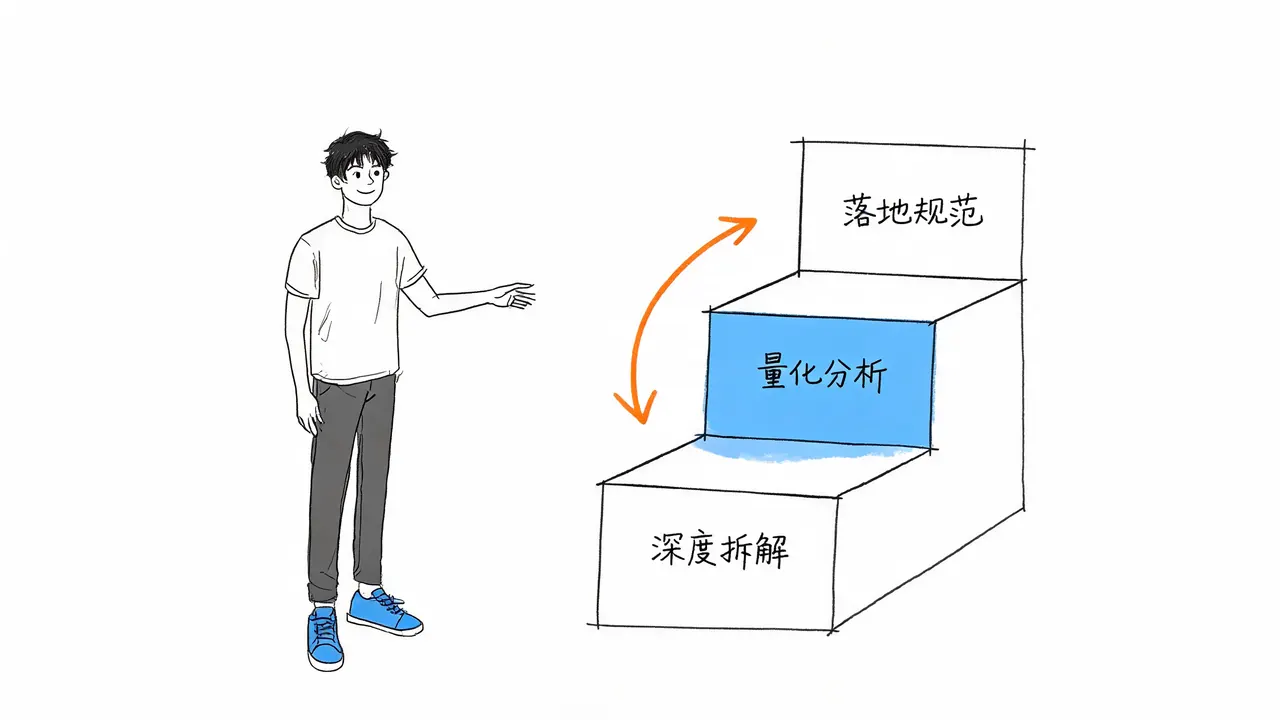
要达到高级后端的要求,工程师必须具备以下三层核心认知:
- 线程池方案的深度拆解与对比
- 线程池风险的量化分析
- 线程池架构的落地规范
第一层:线程池方案的深度拆解与对比
常见的线程池实现包括 ThreadPoolExecutor、ForkJoinPool、ScheduledThreadPool 以及 Executors 提供的默认线程池模式。对这些组件的理解不能停留在背诵阶段,而应深入拆解它们在 CPU 密集型、IO 密集型、定时任务及大任务拆分场景下的优缺点。
重点核查以下方面:
- 参数评估:核心线程数、最大线程数、队列类型、拒绝策略是否基于业务场景进行了压测评估,而非盲目调大。
- 泄漏防护:是否配置了线程泄漏的超时回收机制和空闲线程淘汰机制,以避免线程长期占用不释放。
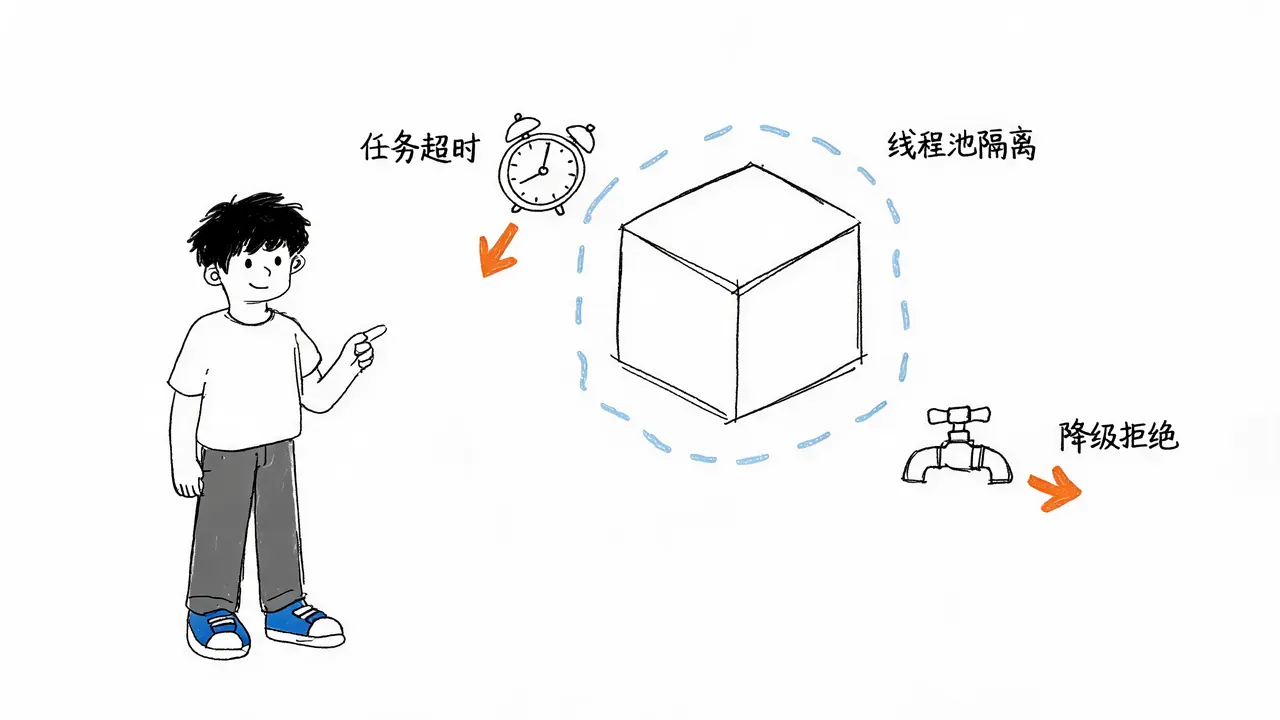
- 慢任务抵御:当慢任务占满线程时,是否结合了“任务超时 + 线程池隔离 + 降级拒绝”的组合方案,以防止单接口拖垮整个线程池。
第二层:线程池风险的量化分析
拒绝凭感觉说“基本够用”,必须通过数据量化风险。重点考察线程池耗尽触发阈值、满持持续时长、线程泄漏概率以及系统抗压极限,并对照核心业务场景逐一核对。
- 降级策略评估:线程池满持后的降级策略是快速失败还是排队等待?雪崩扩散的风险有多高?
- 监控与隔离:是否需要引入 APM(应用性能管理)监控加动态参数调整,或者做业务线程池隔离,以构建更彻底的资源防护?
- 瓶颈定位:监控力度是否能区分慢任务占比和泄漏线程数,从而将资源瓶颈与具体业务接口解耦?
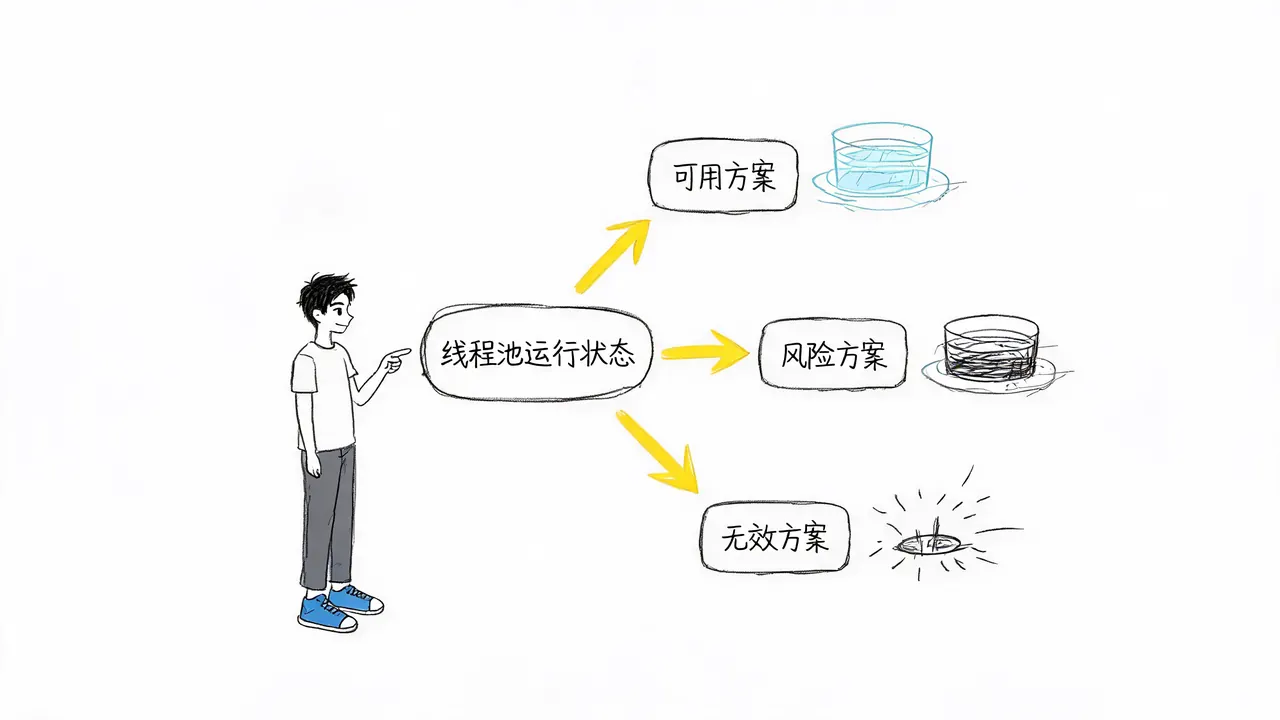
通过量化分析,可以精准区分三类方案:
- 可用方案:低风险稳定运行,靠超时回收机制兜底并持续优化。
- 风险方案:只靠调大线程数,慢任务一出现直接打满池。
- 无效方案:无监控、无降级,一旦故障导致全链路上下游集体雪崩。
第三层:线程池架构的落地规范
建立标准化的线程池配置准入标准,制定严禁使用的配置列表,划定单服务线程数红线和单任务执行时长红线。
- 实时监控与告警:实现线程池水位实时监控与告警,借助 APM 工具批量排查慢任务与线程泄漏。
- 熔断降级预案:建立高峰期线程池熔断降级预案,特别是针对订单支付、库存扣减、用户资产等金融级核心链路。
- 知识沉淀与防御性编码:沉淀团队的线程池事故复盘知识点与防御性编码约束。
- AI 辅助开发规范:形成提示词规范,让 AI 生成的代码从源头上内嵌线程池风险防护。
- 上线红线:禁止将任何无超时配置、无监控告警、无降级策略的线程池代码直接上线。
总结:从配置参数到守护高可用底线
这道面试题的核心,在于从“会配置线程池参数”升级为“能守护线程资源的高可用底线”。
- 普通后端:认为线程数够大、能提交任务就行。
- 高级后端:会从耗尽预防、泄漏风险、业务容忍度、极端故障下的降级保护等维度做全链路设计。
线程池不仅仅是 Java 并发编程的一个工具,更是高可用架构中的关键防线。通过深度的方案拆解、量化的风险分析和严格的落地规范,才能确保系统在流量洪峰下依然稳定运行。
你在工作中使用线程池踩过最大的坑是什么?有没有遇到过线程池耗尽导致服务雪崩的经历?欢迎在评论区交流分享。