RAG 答不准?可能是文本切分(Chunking)做错了
当 RAG(检索增强生成)系统的回答不够准确时,第一反应往往是更换更强的模型或优化向量数据库。然而,很多时候模型本身没有问题,向量数据库也运行正常,真正的瓶颈出现在更早的阶段——文档刚进入系统时被“切坏”了。
文本切分(Chunking)听起来只是预处理中的一个微小环节,但它实际上决定了用户的问题能否找回正确的材料。如果切分不当,上下文被截断,信息丢失,后续检索出来的自然就是残片。本文将深入探讨文本切分的核心逻辑、常见策略以及如何通过工程手段优化这一关键环节。
`` 是摘要与正文的分隔标记,请保留。什么是文本切分?
文本切分(Chunking) 是指将长文档拆分成一个个独立的文本块(Chunk)。
在 RAG 架构中,系统不会将整本文档直接塞给大模型,而是先通过检索找到最相关的几段文本,再将这几段放入上下文窗口生成答案。因此,切分出来的每一个 Chunk 都是将来要被单独检索、单独理解、单独引用的最小单位。
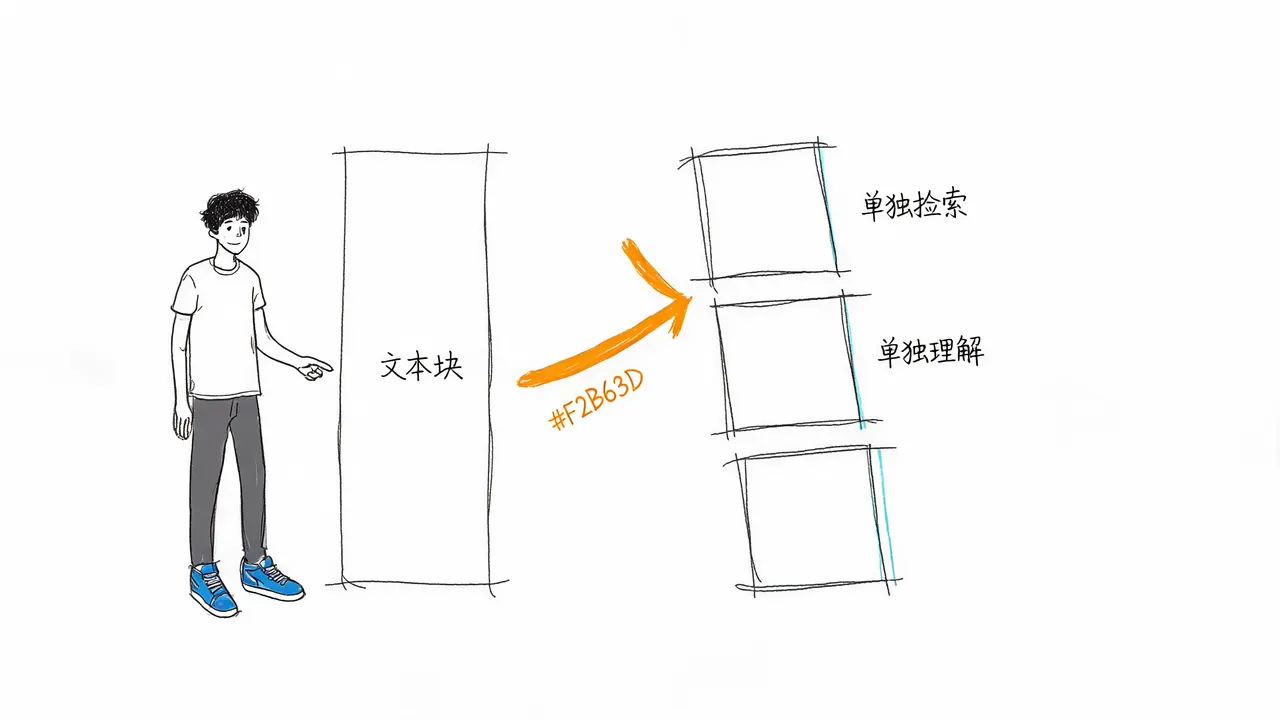
切分的核心目标不是简单地按字数切割,而是保留语义单元。理想的切分应该沿着段落、表格或代码块的边界进行,确保每个块在语义上是完整的。
特别注意:表格和代码块是切分中最容易出错的地方。一旦这些结构化数据被腰斩,剩余部分往往失去意义,导致检索失败。
切分质量如何影响 RAG 效果?
切分策略直接影响 RAG 系统的三个核心环节:
1. 影响 Embedding 表达
每个 Chunk 会被压缩成一个向量。
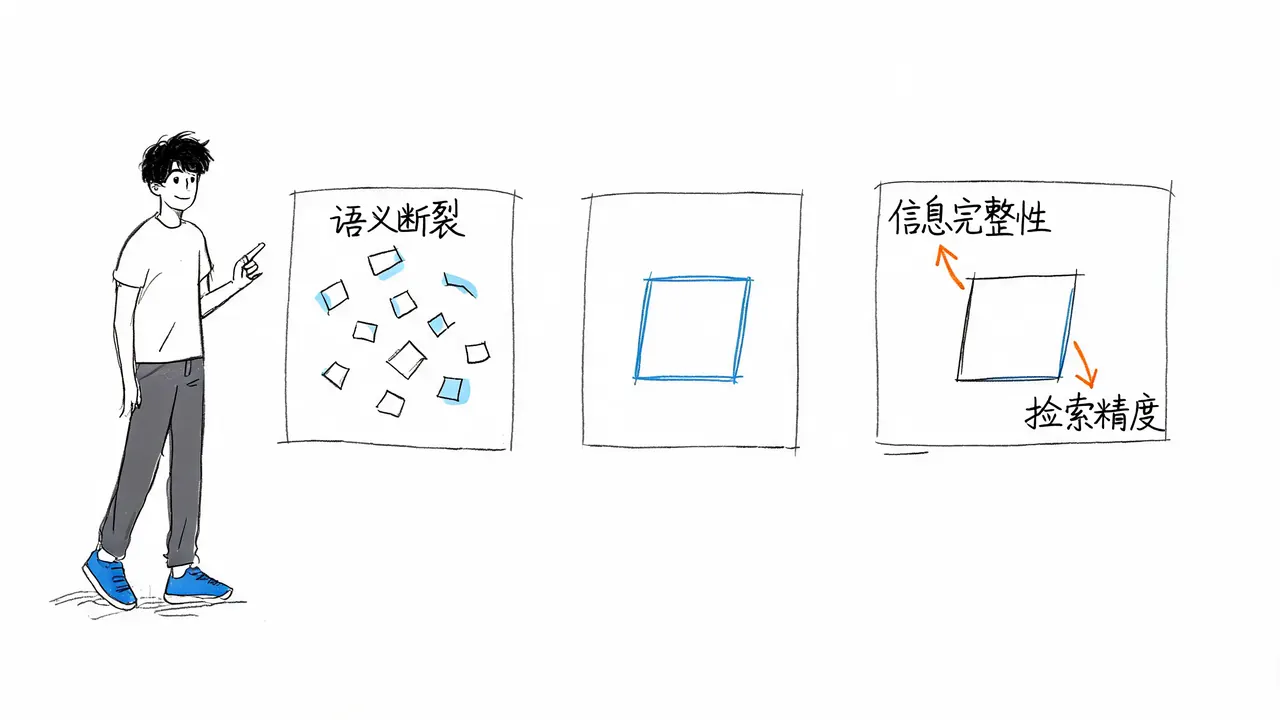
- Chunk 过大:如果一块文本混合了多个主题,生成的向量就是这些主题的平均值,导致语义模糊,谁都不像。
- Chunk 过小:语义断裂,向量无法完整表达原意。
2. 影响检索召回
相似度匹配是拿用户问题与文本块进行对比。
- 如果一个完整的答案被切散在多个块中,每一块单独看都不够相关,结果就是谁都没被召回。
- 切分质量直接决定了检索的召回率。
3. 影响上下文注入
召回的块最终要塞进模型的上下文窗口。
- 块太大:占用窗口空间且携带大量噪声,干扰模型注意力。
- 块太小:缺乏定义、前提或结论,模型只能依靠“脑补”来生成答案,容易产生幻觉。
本质上,Chunking 是一架天平:左边是信息完整性,右边是检索精度。往哪边加码,另一边就会变轻。
五种常见的切分策略
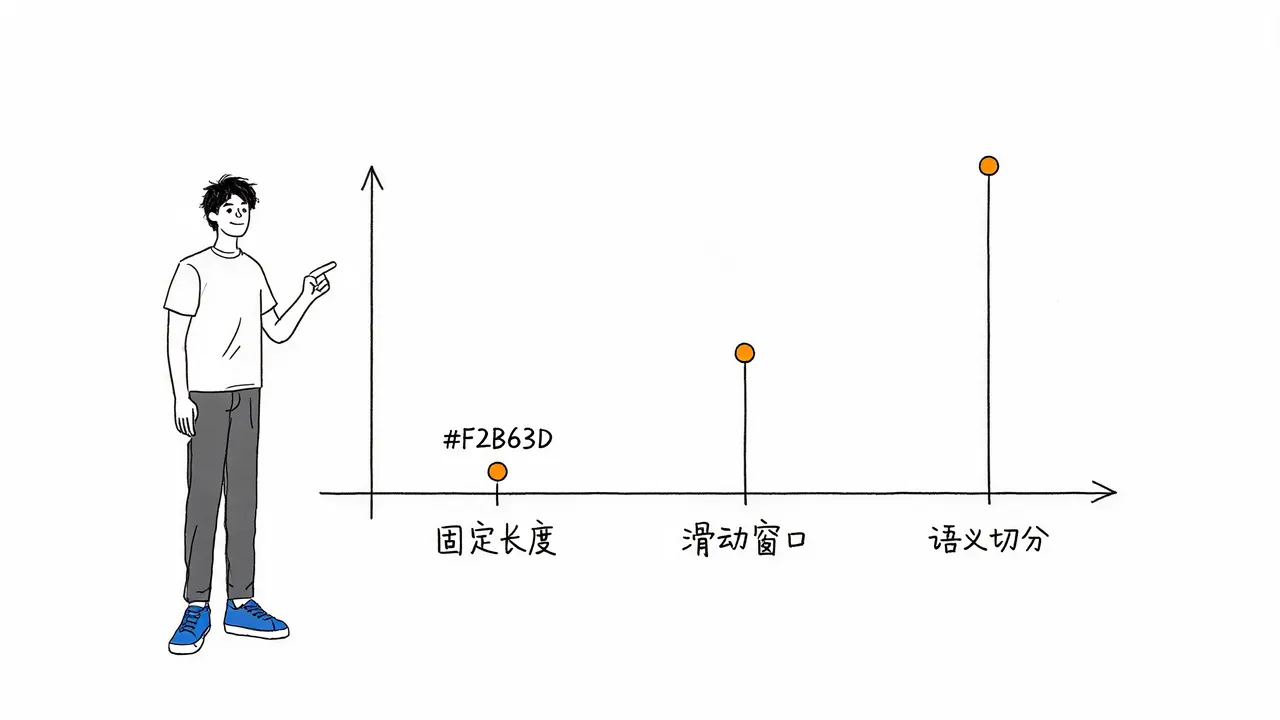
不存在一个对所有业务都最优的固定 Chunk 大小(如 512 或 1024 tokens)。以下是五种常见切分方法的对比:
| 策略 | 描述 | 优点 | 缺点 |
|---|---|---|---|
| 固定长度 | 按 Token 数一刀切 | 工程实现最简单,省事 | 不识别句号和表格,粗糙,易切断语义 |
| 按段落切 | 以段落为边界 | 边界天然,结构保留较好 | 段落长短不一,有的仅三行,有的长达三页 |
| 按标题/章节切 | 依据文档层级结构 | 适合手册、制度、论文;可存储章节路径元数据 | 依赖文档结构清晰 |
| 滑动窗口 | 相邻块之间保留重叠部分 | 解决上下文断裂问题 | 存储和检索存在冗余,同一段内容存两遍 |
| 语义切分 | 按意思的边界下刀 | 最接近人类阅读方式,语义完整 | 实现复杂,成本高,效果依赖数据质量 |
工程实践:如何调优切分参数?
专业做法不是背诵固定的数字,而是用真实的业务问题集去评测。
- 建立评测闭环:使用真实的用户查询集运行系统,观察召回是否命中了该命中的材料。
- 迭代调参:切分参数是调出来的,不是抄出来的。根据召回命中率反馈,回头调整切分策略。
- 保留元数据:在切分时,务必保留标题、页码、章节路径、来源、权限等元数据。这有助于模型在引用时知道出处,也能辅助后续的重排序和过滤。
面试指南:如何回答“文本切分为什么重要”?
如果在面试中被问到这个问题,建议从以下五个层次由下往上构建答案:
- 定义层:Chunking 是将长文档拆分为适合检索和上下文注入的文本块。核心要素包括结构保留、重叠窗口和元数据。
- 机制层:每个块被 Embedding 成向量,后续所有检索都是基于这些块进行相似度匹配。切分出的块就是检索系统能看到的“全部世界”。
- 权衡层:完整性与精度是反向的。太大导致噪声多,太小导致语义断裂。
- 策略层:根据文档类型选择按长度、段落、标题、滑动窗口或语义边界切分,并配合混合检索和向量库使用。
- 工程层:建立评测闭环,用真实查询跑通流程,根据召回命中率调整切分策略,最后才是模型生成答案。
结语
Chunking 是 RAG 检索质量的地基。
地基歪了,上面楼盖得再漂亮,模型也拿不到对的材料。文本切分不仅仅是格式处理,它在决定知识能不能被召回。切分质量就是召回质量。 在优化模型之前,请先检查你的文档切分策略。