大模型研发的核心竞争力:从智力依赖到实验频率的范式转移
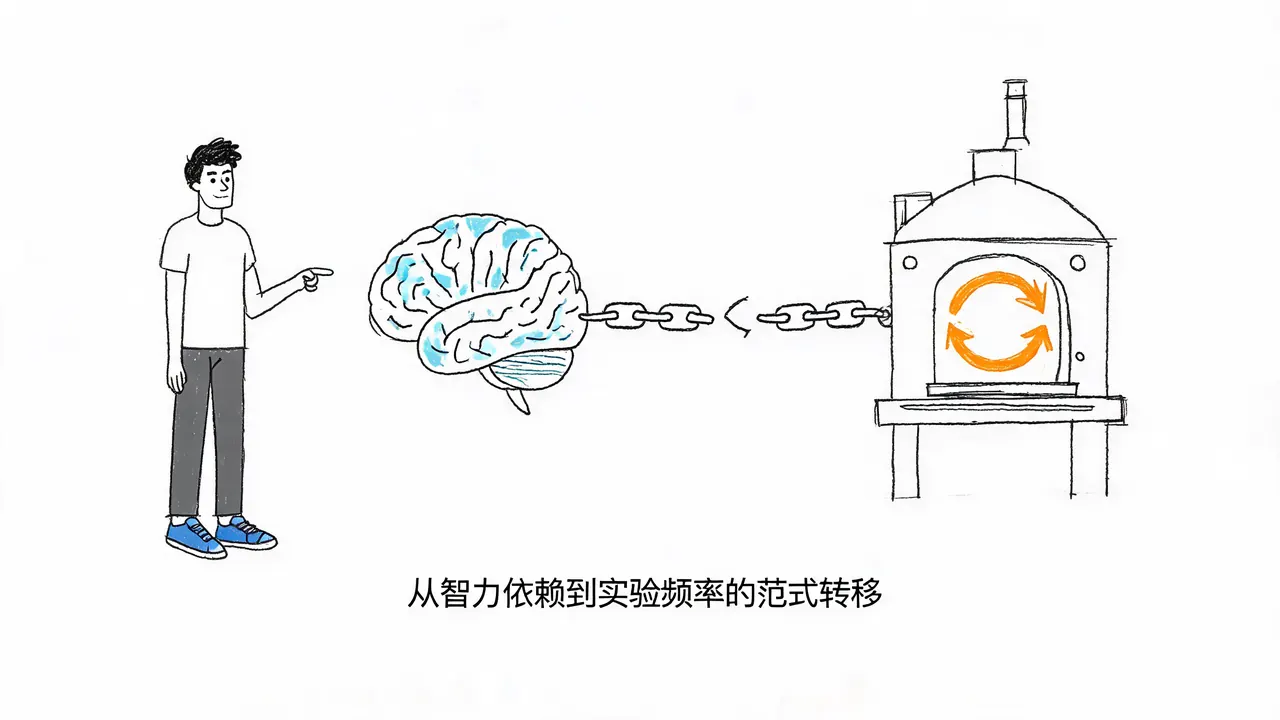
在人工智能领域,尤其是大模型研发中,一个常见的误区是认为顶尖天才的智力是突破的关键。然而,如果将大模型研发视为一种“实验科学”,我们会发现一个反直觉的结论:决定胜负的往往不是谁更聪明,而是谁在单位时间内能完成更多次有效的实验。这种实验频率,我们称之为“炉次”。
`` 是摘要与正文的分隔标记,请保留。智力是入场券,而非变量
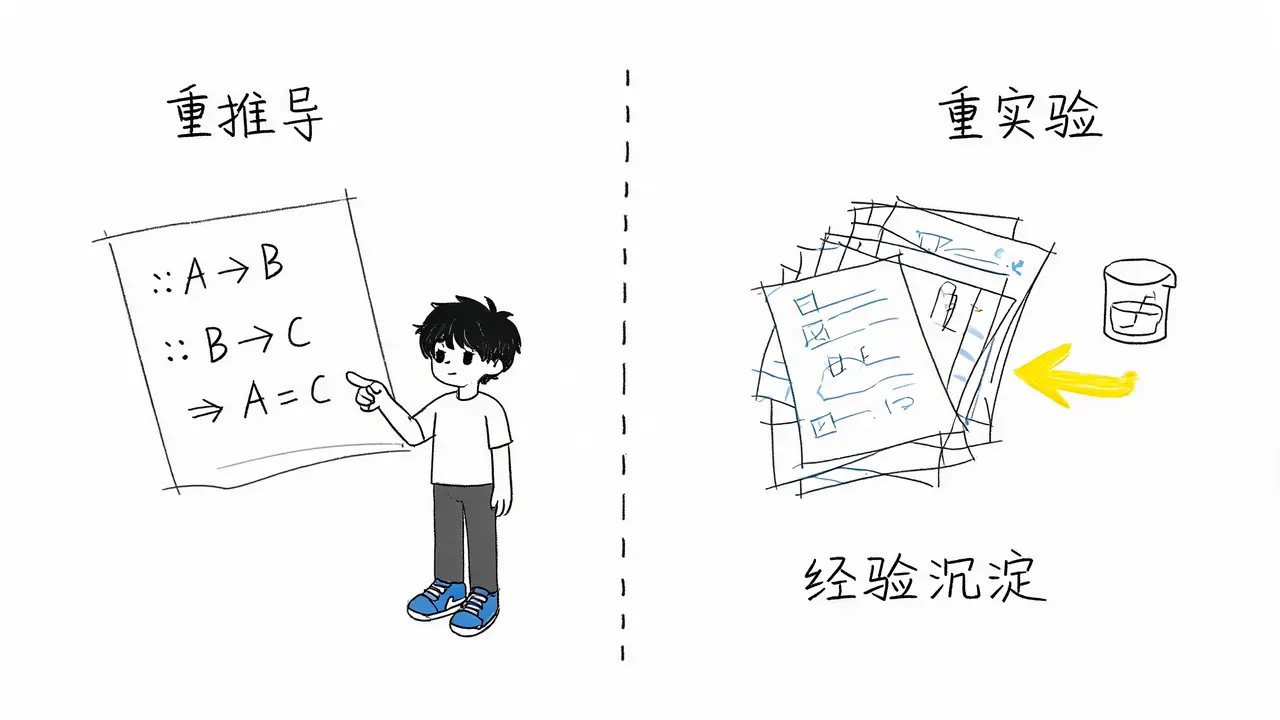
要理解大模型研发的底层逻辑,首先需要区分两类学科:重推导的学科(如数学、理论物理)和重实验的学科(如化学、材料、半导体工艺)。
在重推导学科中,天才的作用至关重要。一个人可能在纸上想明白一个定理,从而改写整个分支。但在重实验学科中,历史上几乎没有人能仅靠单纯的聪明去改写学科。这些领域的突破,几乎全部来自成千上万次实验后的经验沉淀。
大模型研发更接近后者。因此,在实验学科中有一条很少被说破的规律:智力不是变量,它是入场券。
- 入场券属性:能进入这一行的研究人员,智力都足够用。
- 差距来源:真正拉开差距的,是他们在几年里亲手做过多少次实验。
假设两个一样聪明的研究员,一个一年跑 50 次实验,另一个只能跑 10 次。5 年后的差距绝不仅仅是 5 倍,而是经验积累带来的复利效应。
“炉次”:算力的第一性用途
为了量化这种实验频率,我们引入**“炉次”**这一概念。
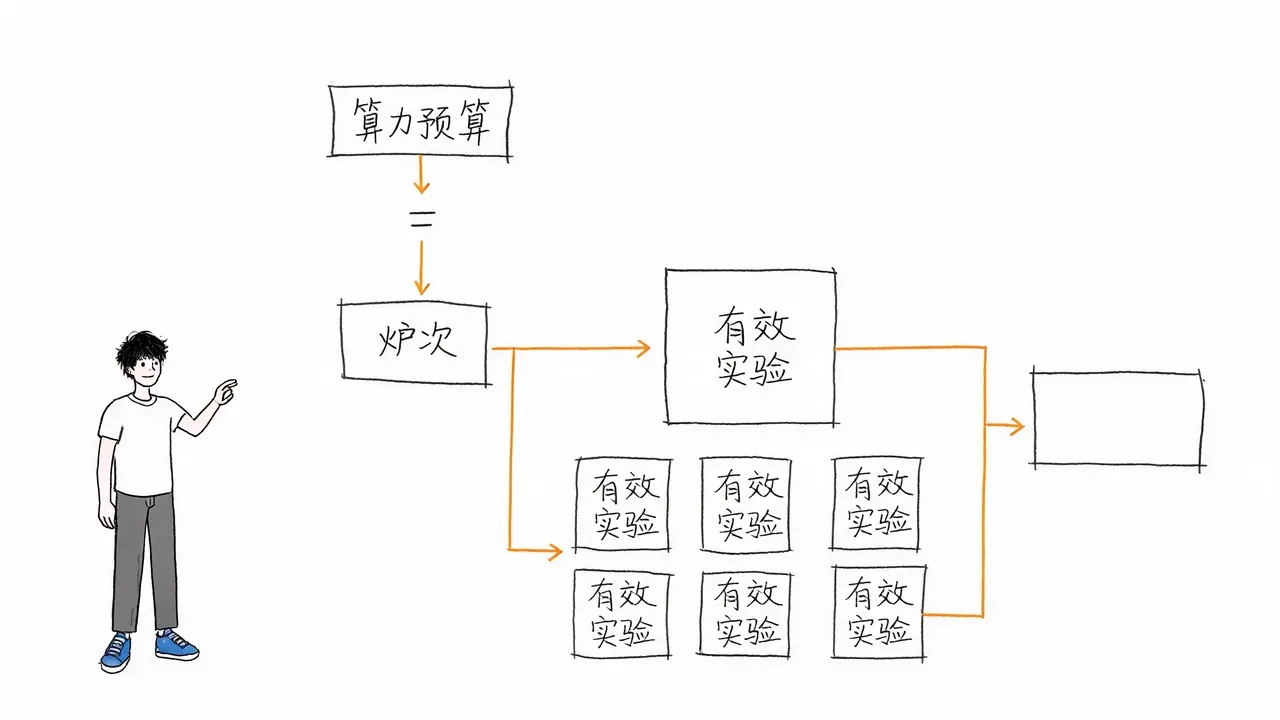
炉次定义为一个团队在单位时间里能完成的有效实验回合数。这个数字直接由年度算力预算决定:
- 前沿预训练:一次完整的训练需要数千张卡运行数月。
- 消融实验:一次小规模实验也需要几十到几百张卡运行几天。
当总预算固定时,年度算力预算除以单次实验成本,即为该团队一年能“开几炉”。
这里有一个容易被忽略的推论:算力的第一性用途,不是直接训练出一个最终模型,而是购买实验回合数。
同样一笔算力,存在两种截然不同的战略选择:
- 策略 A:集中资源跑一次超大规模训练,赌一把大的。
- 策略 B:拆分成三十次小实验,先摸清规律,再决定往哪条路投钱。
残酷之处在于,这个战略选择一年通常只能做一次。如果押错了方向,这一年就过去了。因此,算力的本质是验证想法的速度和承受失败的次数。
规模法则:放大规律而非代替实验
在讨论算力分配时,绕不开“规模法则”(Scaling Laws)。它常被简化为“越大越聪明”,但这是一种粗糙且容易误导的说法。
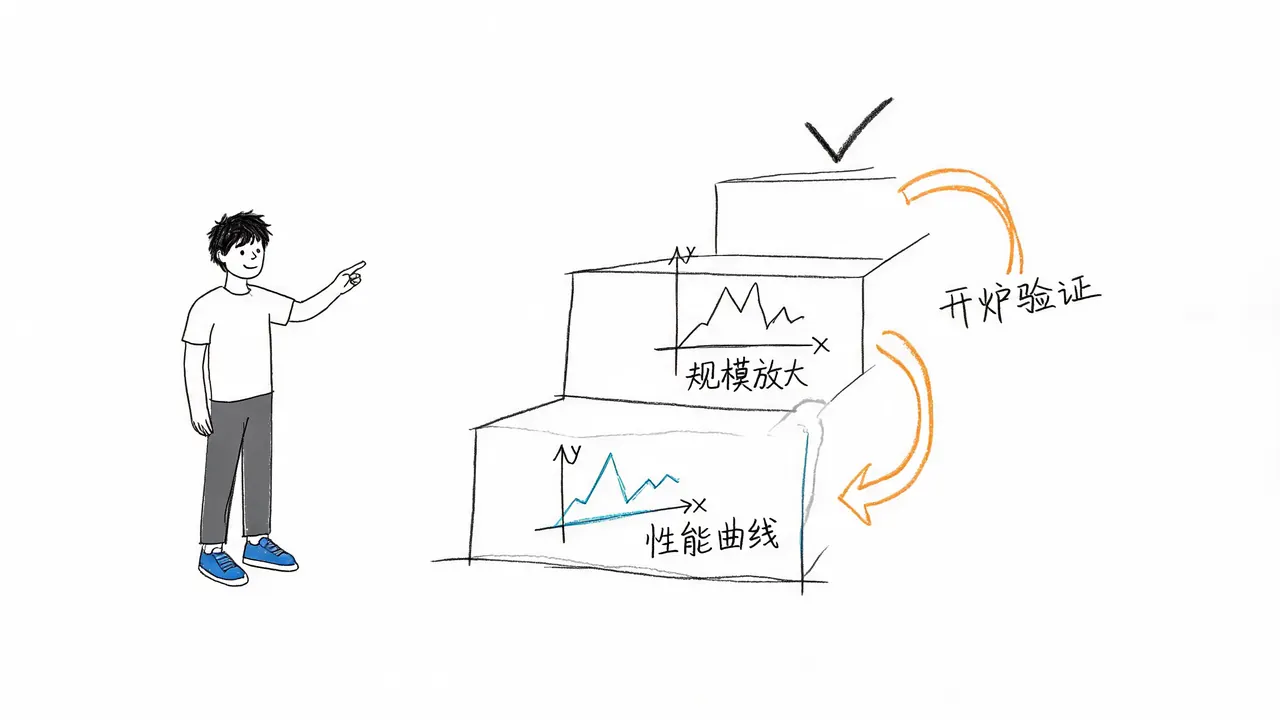
规模法则的真正用法是放大规律:
- 先在小尺度上测出性能曲线。
- 估算规模放大 100 倍后,性能会落在哪里。
- 据此判断这笔算力投资是否值得。
这套做法与化工行业上百年的“小试-中试-放大生产”逻辑一模一样。但在使用规模法则时,必须注意两点:
- 价值在于节省实验,而非代替实验:它让你敢于下注,但下注之后照样得开炉验证。
- 是对数关系,而非指数关系:准确的说法是,投入指数级增长,能力大致对数改善。规模确实是能力的来源,但代价一直在翻倍。
此外,规模法则并非牛顿定律那样的自然定律,而是从大量实验中拟合出的经验曲线。这一行最接近“定律”的东西,本质上还是一份实验记录。
曲线锁定:为什么分数接近不代表差距小?
规模法则带来的收益递减特性,解释了大模型竞争中的两个困惑现象:
- 落后方的追赶:由于曲线越往上越平,落后方即使投入少一大截,落下来的分数可能只有一小截。
- 领先方的困境:领先方要再往前挪一小步,需要投入指数级的算力。
因此,榜单分数接近,不代表算力差距不重要。
- 分数:是对数刻度上的读数。
- 算力:是指数刻度上的投入。
拿分数差去反推算力差,是把两个坐标轴看串了。打个比方,百米短跑从 12 秒跑到 11 秒,认真练几个月即可;但从 10.0 秒跑到 9.9 秒,可能需要举国资源。外行看榜单看到的是 0.1 秒的差距,内行看到的则是那 0.1 秒背后占用的算力、资金和时间。
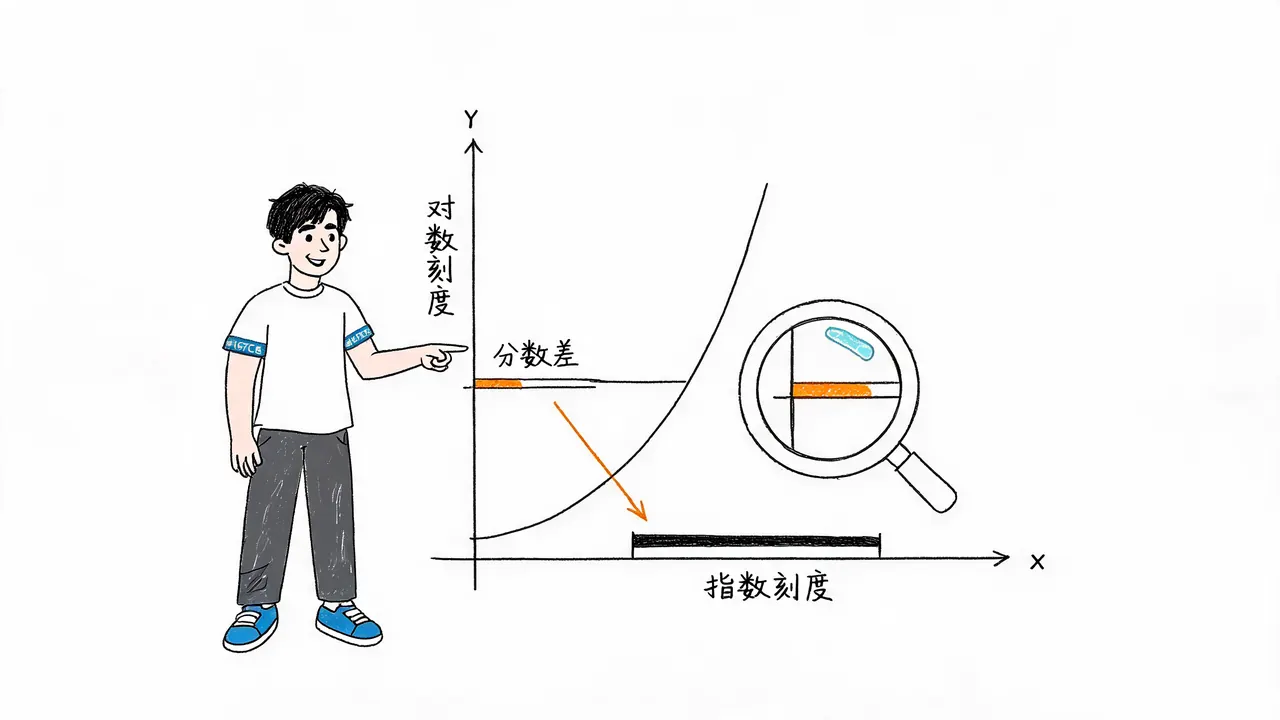
目前,中美顶尖模型在公开榜单上的差距不到三个百分点。但这并不意味着差距很小,而是我们一直在看的“分数刻度”根本就不是差距落下去的地方。
算力真正拖慢的是人,而非模型
算力约束的伤害是延迟显形的。
- 短期影响:今年的榜单名次可以通过工程优化补回来一大截。
- 长期影响:算力约束压低的是五年之后的人才厚度。
一个刚进这行的年轻研究员,一年能亲手参与几次真正的大规模实验,很大程度上决定了他五年后能否成为主力。这一行最值钱的是“手感”和“经验”,而手感只能亲手做出来。做的次数少,手感就长得慢。
芯片可以买,但实验记录不能买。别人踩过的坑,你没踩过,就是没踩过。
虽然这是一个推论而非已被量化验证的结论,但顺着实验学科的性质往下推,它很难不成立:算力买到的不是分数,而是速度和人。
结语
大模型这门手艺的胜负手,从来不在谁更聪明,而在谁一年能开更多炉。
- 炉子就是集群。
- 炉火就是算力。
因此,算力在这一行的真正含义,不是机器有多快,而是你一年能验证多少个想法,能承受多少次失败。
如果炉次决定一切,那么当我们将中美两边的“炉子”摆到一起看时,差的到底是什么?很多人第一反应是差分数,但有一个数字很反常:目前中美顶尖模型在公开榜单上的差距不到三个百分点。
差距真的这么小吗?还是说,我们一直在看的那个刻度,根本就不是差距落下去的地方?
下一集,我们将深入探讨:算力真正拖慢的是人,不是模型。