稀疏架构与算力预算:为何模型参数规模不等于推理能力
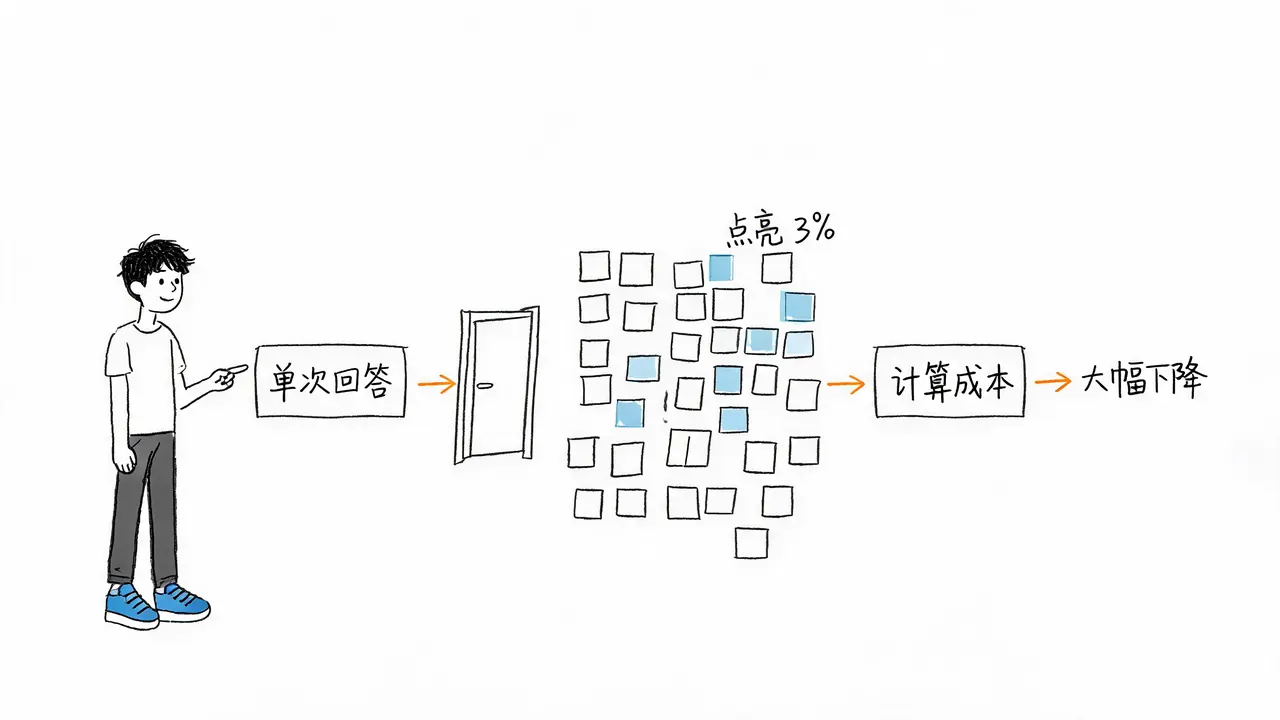
在大型语言模型的竞争中,一个常见的误区是将“总参数规模”直接等同于“模型能力”。然而,随着稀疏架构(Sparse Architecture)的普及,这一等式正在被打破。以 DeepSeek V3 Pro 为例,其官方模型卡显示总参数高达 1.6 万亿,但每次回答仅激活约 490 亿参数,占比仅为 3% 左右。相比之下,同期国内公开的旗舰模型激活规模通常在几十亿到一千亿出头。这种“大模型、小激活”的现象,正是稀疏架构的核心特征:模型整体庞大,但每次推理只调动其中一小部分计算单元。
`` 是摘要与正文的分隔标记,请保留。总参数是库存,激活参数才是用料
理解稀疏架构的关键,在于区分“总参数”与“激活参数”的本质差异。
- 总参数(Total Parameters):相当于药材库的库存总量,或仓库的面积。它代表了模型潜在的知识容量和存储规模。
- 激活参数(Active Parameters):相当于这一次回答真正取用的药材,或这一顿饭实际下的料。它直接决定了当前推理任务的计算量和最终输出质量。
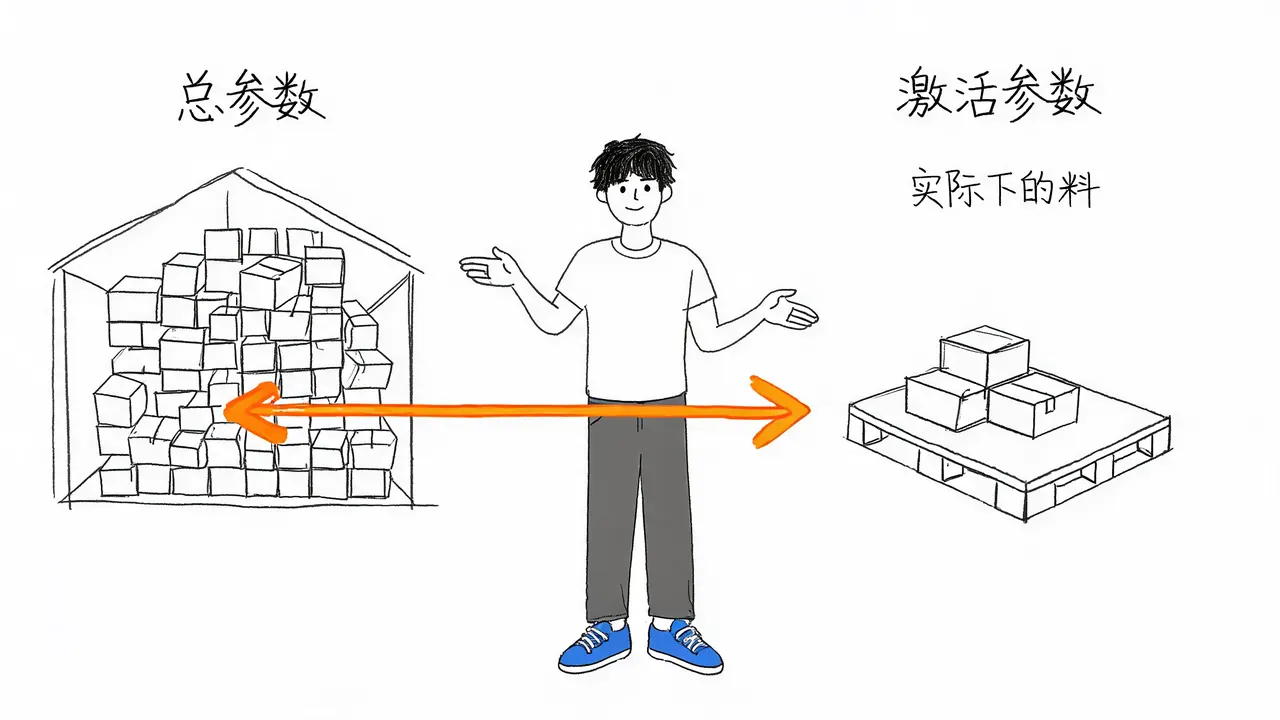
拿总参数比大小,就像拿仓库面积比菜好不好吃,逻辑上是错位的。真正决定回答质量的,是“下了多少料”,即激活参数的规模及其利用效率。
稀疏架构的工程突破与成本逻辑
稀疏架构并非中国团队首创,早在 2017 年就有代表性的稀疏门控专家(MoE)模型研究发表。中国团队在此领域的真正贡献,在于将稀疏架构、低精度训练和通信优化这一整套工程强度推到了极高的水平。
这一技术路线的直接目的是让每一份算力产出更多可用的推理。这纠正了“中国大模型便宜全靠补贴或价格战”的流传说法。虽然定价策略和补贴存在,但根本原因在于单次回答的边际计算成本被实质性压低。
- 成本机制:一次回答仅点亮 3% 的参数,计算成本自然大幅下降。
- 价格本质:低价是成本降低的结果,而非手段。这是被资源约束逼出来的工程真功夫,也是当前中国 AI 领域最被低估的能力之一。
算力预算的三大决定因素
单次回答能投入的计算量,本身就是模型能力的一部分。它由以下三个维度共同决定,三者相乘即为该次回答的“算力预算”:
- 激活参数量:本次回答实际调用的参数规模(下了多少料)。
- 思考长度:模型在给出最终答案前,允许自己进行内部推理的时间或步骤长度(先想多久)。
- 尝试次数:模型是否生成多个候选答案,再从中挑选最优解(试几次)。
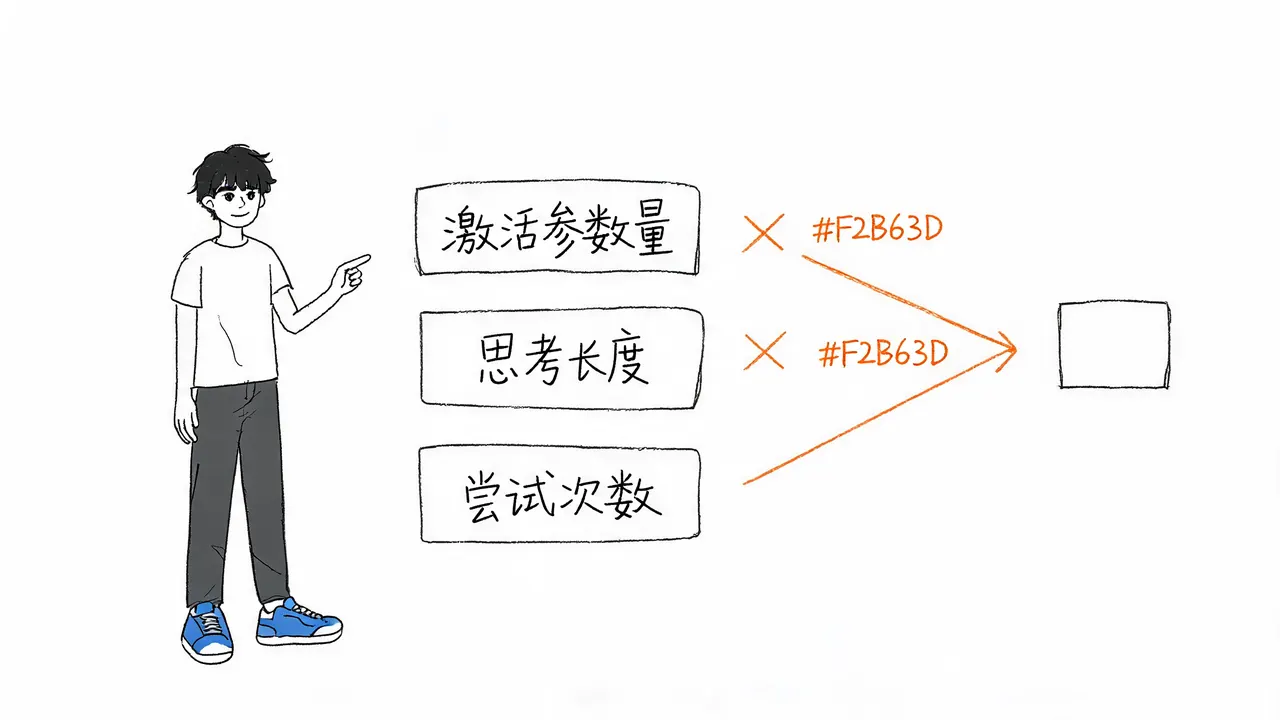
核心逻辑:这三项中任何一项被成本约束压制,答案的质量上限就会被压低。这就是“算得多,所以答得准”的真正机理。
资源宽裕度与推理体验的差异
美国前沿模型(如 B 系列)的具体架构和激活参数从未官方公开,因此无法直接对比其内部结构。但通过定价、响应延迟和默认思考长度等可观测指标,可以推断其资源宽裕度。
- 宽裕方:可以将“多想 30 秒”设为默认选项,因为算力成本相对可控。
- 紧约束方:可能需要将延长思考时间作为付费档位,以控制整体算力支出。
公开研究已证实,推理时计算量与正确率呈正相关。让模型多想一会儿、多试几次,准确率确实会提升。由于思考长度和尝试次数直接消耗推理算力,它们是最受成本约束的变量。因此,中美模型在体验上的差距,可能不在于模型本身的大小,而在于**“谁敢让用户免费多想 30 秒”**这一算力决策。
评测体系的盲区:固定预算 vs 可变预算
一个令人困惑的现象是:尽管算力投入差距显著,但主流公开榜单上的分数差距往往不到 3 个百分点。原因在于当前评测体系的局限性:
- 评测口径:主流榜单大多测试“一次性回答的正确率”,且给予每个模型基本相同的固定算力预算。
- 竞争转移:实际竞争已转移到可变算力预算领域,即模型愿意为单次回答烧掉多少算力。
- 结果偏差:榜单测得出模型“知不知道”,却测不出模型“愿意为一次回答投入多少算力”。这解释了为何榜单分数相近,但在处理复杂任务时体感差异巨大。
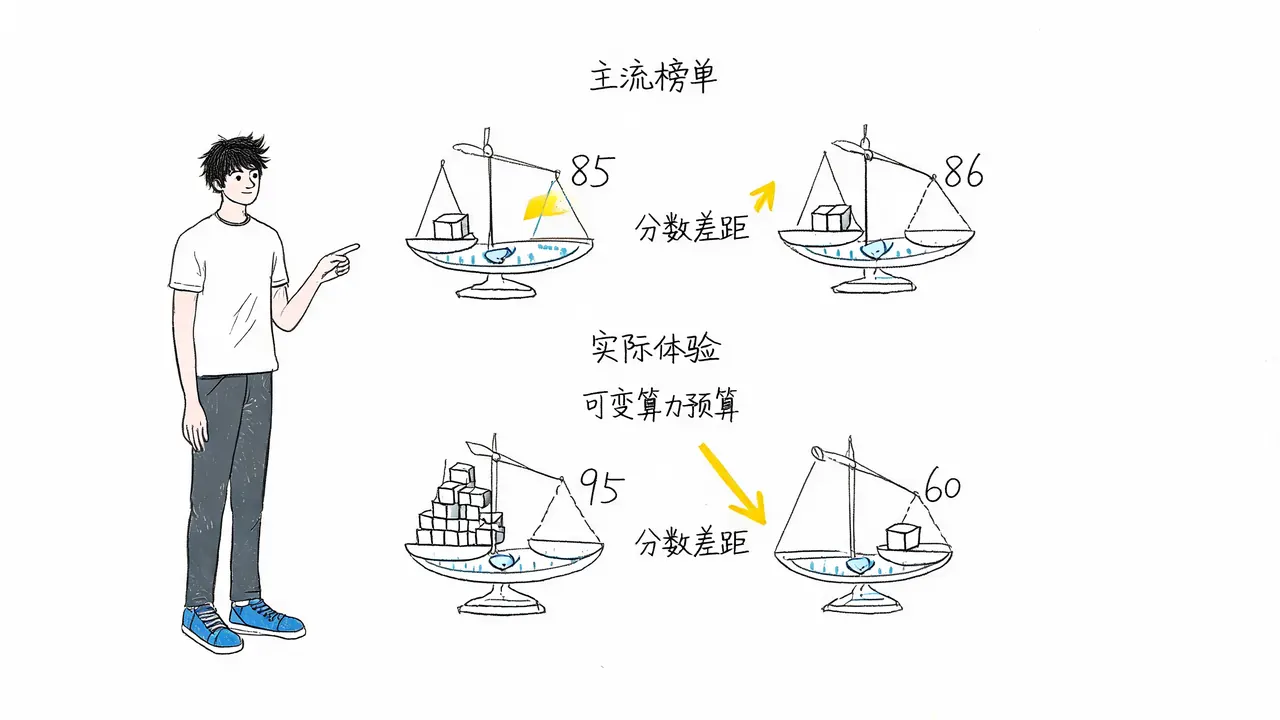
需要诚实指出的是,榜单未覆盖推理预算维度,并不意味着差距一定巨大,仅说明该维度未被量化。目前尚无公允的量化办法来精确衡量这一差距。
两种资源条件下的技术路径
当前大模型发展呈现出两种截然不同的路径,均源于各自的资源条件:
- 抬高算力上限:在资源宽裕条件下,通过增加单次推理的计算量来提升能力。
- 提高算力产量:在资源受限条件下,通过稀疏架构和工程优化,极致压缩单次成本。
将单次成本压到极低并非妥协,而是真功夫。世界上大部分国家因缺乏相应的工程能力和资源约束压力,难以走通这条路。
展望:下一代训练的原料危机
当前模型训练完成后,权重基本固定,能力上限已定,省与不省主要影响的是发挥程度。然而,下一代模型面临新的挑战:
- 数据枯竭:人类写下的高质量文本即将被训练殆尽。
- 自生成数据:下一代的“原料”需由模型自己生成,通过自我尝试、自我打分、自我积累经验来创造训练数据。
- 算力需求激增:这种自生成过程比传统训练更耗费算力。
在算力预算进一步收紧的背景下,现有的“省”是否还能“够用”,将是下一轮技术竞争的关键问题。