RAG 进阶:重排序(Reranking)如何解决检索成功但答案不准的问题
在构建检索增强生成(RAG)系统时,一个常见的痛点是:检索环节看似成功,返回了大量相关文档,但最终生成的答案却不够准确。这通常不是模型能力的问题,而是上下文构建的问题。
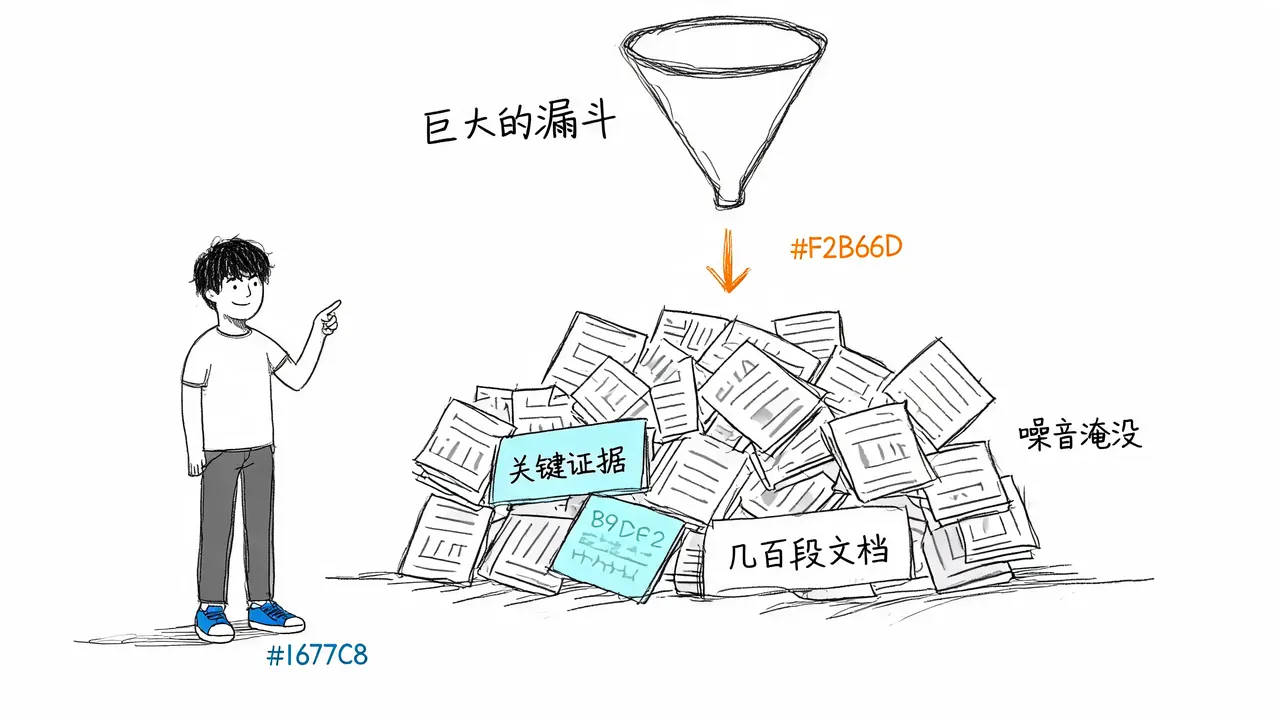
想象一下,召回阶段像是一个巨大的漏斗,一次性倒出几百段文档。然而,大模型的上下文窗口有限,无法容纳所有信息。如果塞入过多无关内容,关键证据会被噪音淹没;如果塞入过少,又可能遗漏核心信息。因此,核心问题在于:在检索到的数百段资料中,哪几段才最该交给大模型?
回答这个问题的关键组件,就是重排序(Reranking)。
重排序在 RAG 链路中的位置
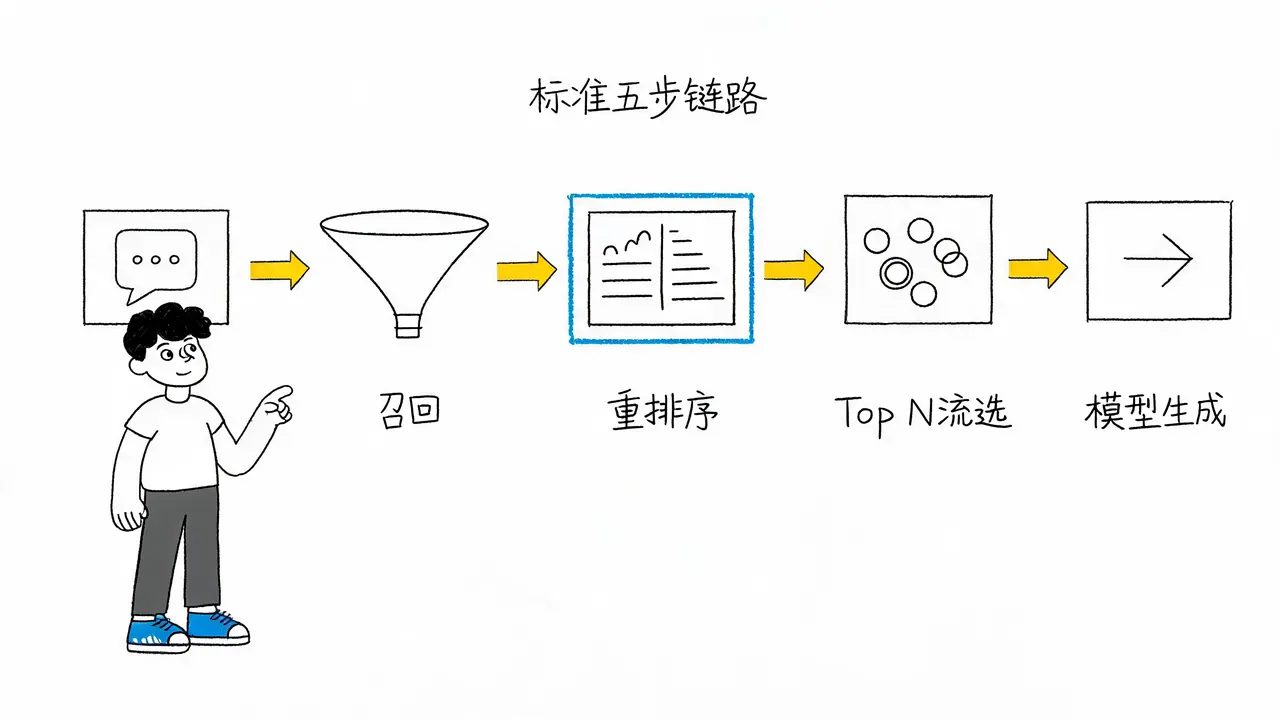
重排序并不负责从知识库中“找”内容,而是负责在已有的候选池中“排”顺序。为了理解其作用,我们需要回顾 RAG 的标准五步链路:
- 用户提问:输入自然语言问题。
- 召回(Retrieval):扩大范围,宁多勿漏。这一阶段的目标是“别漏”,因此通常使用大漏斗策略,尽可能多地抓取潜在相关文档。
- 重排序(Reranking):对召回的候选文档重新打分,按相关性排序。此时,文档卡片上会显示具体的相关性分数(如 0.92, 0.88, 0.76),即使是同一批召回的结果,分数差异也可能很大。
- Top-N 筛选:截取分数最高的核心精华,切掉低分文档。
- 模型生成:将筛选后的精准上下文输入大模型,生成最终答案。
由此可见,重排序是接在召回之后、生成之前的“金牌”环节。它不替代检索,而是对检索结果进行精细化处理。
为什么召回之后还需要重排序?
既然前面的检索已经找到了文档,为什么还要多此一举?这是因为常见的两种检索方式各有盲区:
- 向量检索(Vector Search):
- 优势:速度极快。
- 盲区:基于语意向量的距离计算,容易被字面相近但语义无关的内容误导。例如,某些文档可能在向量空间中距离很近,但实际上与问题无关,从而被误抓进来。
- 关键词检索(Keyword Search):
- 优势:精准匹配。
- 盲区:对同义词或改写敏感。例如,用户查询“采购”,但文档中写的是“订单”,由于词汇不匹配,关键词检索可能无法捕获该文档。
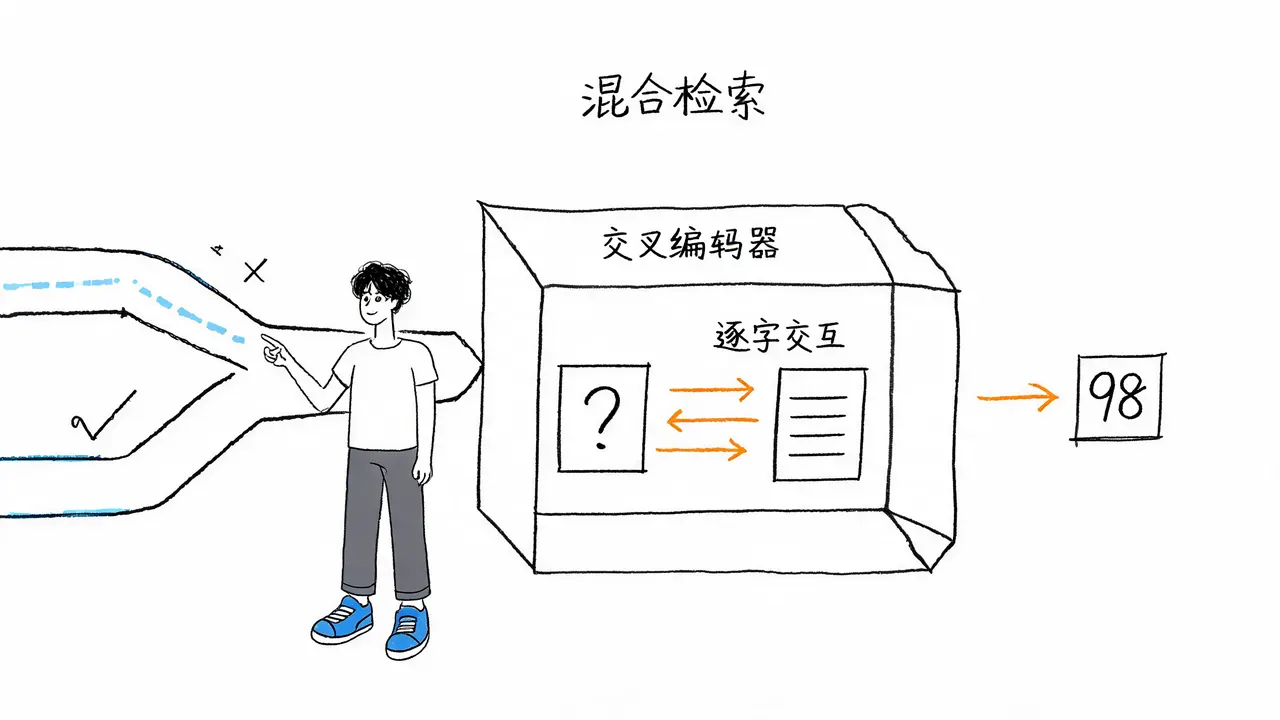
重排序引擎解决了上述问题。它采用**交叉编码器(Cross-Encoder)**机制,将问题和文档同时送入模型,让两者在内部逐字交互,直接计算文档对问题的具体相关度。这种深度交互能给出更精准的相关性分数(例如 0.98)。
然而,交叉编码器的代价是计算量大,因此它只能应用于少量候选文档。标准的混合检索链路如下:
- 向量检索:快速召回大量候选。
- 关键词检索:补充召回,覆盖语义盲区。
- 重排序引擎:对前两步产生的少量高潜候选进行精细排序,排出最相关的结果。
简而言之,前两步负责“找全”,最后一步负责“排准”。
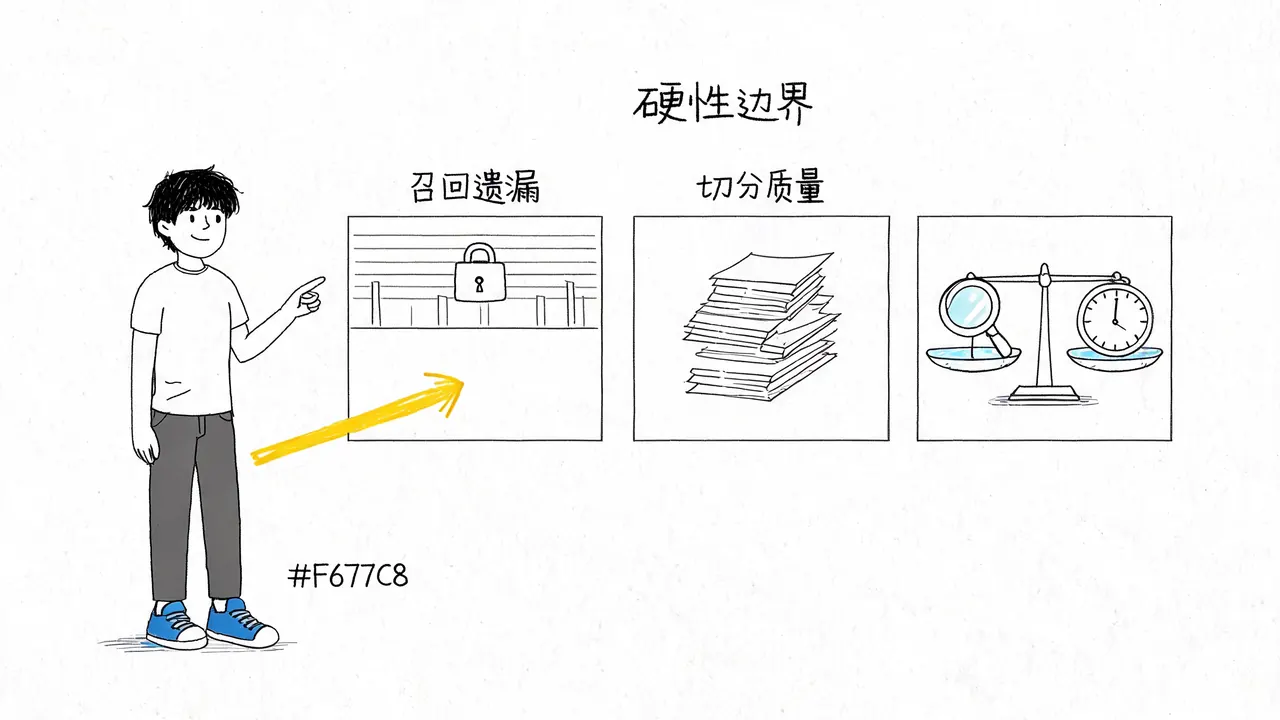
重排序的三大硬边界
尽管重排序能显著提升答案质量,但它并非万能修复器。必须认清其三条硬性边界:
- 无法弥补召回遗漏: 重排序只能在候选池内重新排队。如果初始检索(召回)阶段根本没有找到某篇关键文档,重排序也无法将其“变”出来。重排序的天花板,是由初始召回率锁死的。
- 受制于文档切分质量(Chunking): 重排序模型看到的材料质量取决于文档切分。如果切得太碎,片段缺乏上下文;如果切得太长,又混入大量噪音。输入材料质量不佳,打出的分数自然不可靠。
- 延迟与成本的平衡: 候选文档越多,需要重排序的次数越多,线上响应延迟越高,计算成本也越大。因此,需要在精度和性能之间找到平衡点。
一句话总结:重排序能把好的排到前面,但它变不出你根本没抓到的东西。
面试中的标准答法
如果在技术面试中被问到 Reranking,可以用以下四句话清晰阐述:
- 位置:位于召回之后,生成之前。
- 作用:对粗筛结果进行精细化排序。
- 原理:通过交叉编码器深度计算问题和文档的匹配度得分。
- 边界:受限于初始召回率、文档切分质量以及算力成本。
若能进一步补充:“重排序通常与混合检索配套使用,向量加关键词负责把候选捞全,重排序负责把顺序排准,两者分工明确”,则能证明你不仅了解概念,更具备实际工程落地的认知。
结语
在 RAG 系统中,认知地图需要点亮关键的一格:召回负责尽量找全,重排序负责尽量排准。
注意这里的“尽量”二字,意味着两者都没有绝对。RAG 的效果不仅取决于能否检索到信息,更取决于能否将最该看的那几段内容精准地排到最前面,送入大模型的上下文窗口。