智能体记忆系统:为何 AI 需要主动遗忘与降权?
在构建 AI 智能体的记忆系统时,一个常见的误区是认为“检索到最相似的记忆就应当直接使用”。然而,在实际应用场景中,这种基于向量相似度的单一检索策略往往存在严重缺陷。旧项目的解决方案可能在字面上与当前问题高度相似,但其背后的业务前提可能已经改变,或者该方案已被新版本取代。如果智能体直接调用这些过时的信息,不仅无法解决问题,反而可能引导出错误的执行结果。
因此,主动遗忘(Active Forgetting)在智能体架构中至关重要。它不仅仅是为了节省存储空间,更核心的目的是避免旧证据持续抢占模型宝贵的注意力资源,确保当前任务能够基于最新、有效且合规的信息进行处理。
向量相似度的局限性
我们日常使用的向量相似度检索,主要反映的是文本在表达层面的接近程度。然而,这种接近度并不能保证以下三点:
- 时效性:该信息在当前时间点是否依然有效。
- 可靠性:信息的来源是否真实可靠。
- 权限合规性:当前提问的用户或任务是否有权限读取该信息。
案例说明: 假设有一份上个月的内部讨论草案,其文字描述与今天需要解决的任务匹配度极高。但如果这份草案实际上是一份已废弃的草稿,或者当前对象并没有权限调阅该文件,那么直接引用它将是错误的。
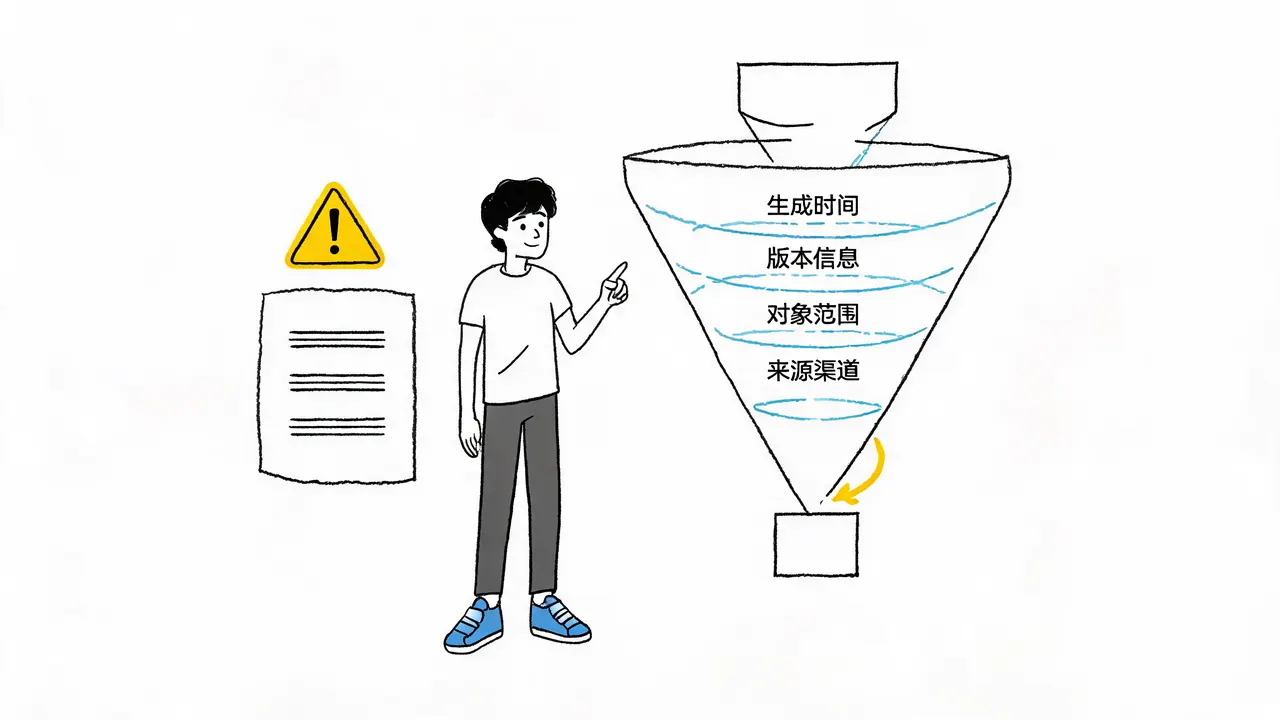
因此,当系统读取长期记忆时,不能仅仅盯着向量库中“最相似的几条”,而应当综合考量以下维度进行判断:
- 记忆的生成时间
- 对应的版本信息
- 适用的对象范围
- 信息的来源渠道
记忆淘汰与失效策略
在操作层面,针对不同类型的记忆,应采取不同的处理策略:
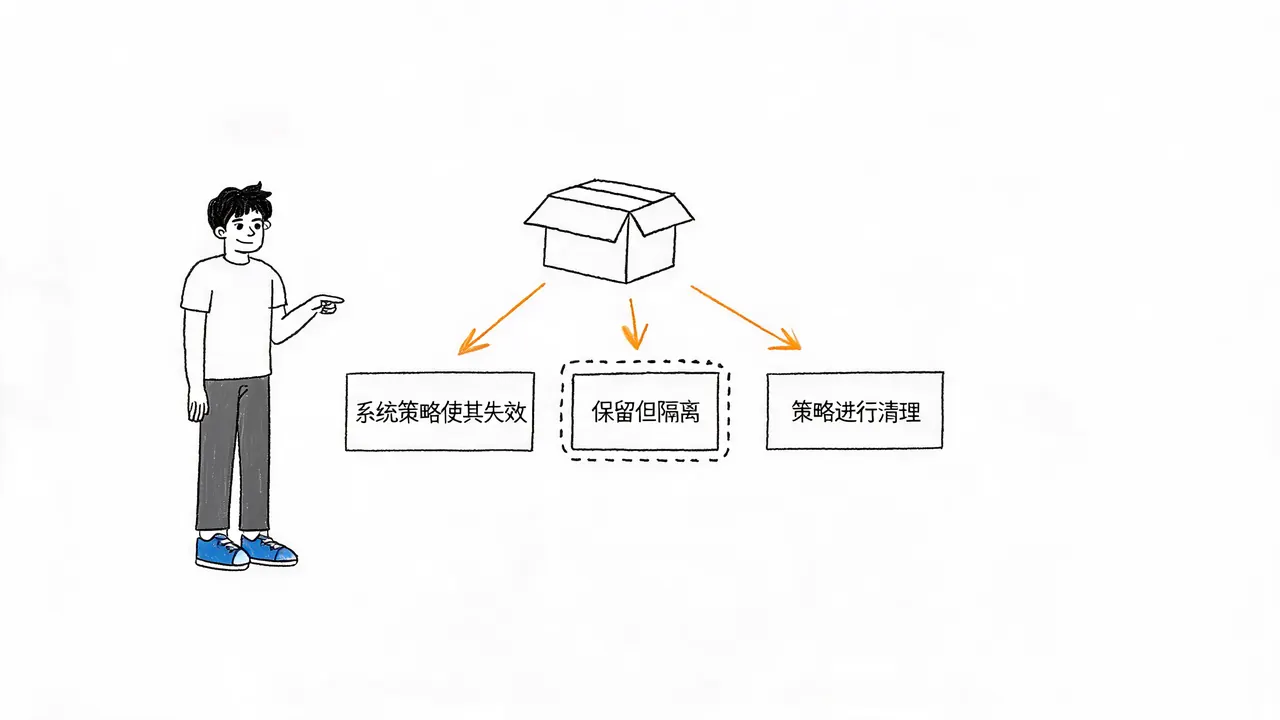
1. 明确过期或被更正的记录
对于已经明确过期,或者已被最新事实更正过的记录,可以通过系统策略使其失效,或者直接删除。这是最直接清理无效信息的方式。
2. 需要审计的场景
如果业务场景涉及事后审计或合规要求,直接删除可能不符合规范。此时可以采取“保留但隔离”的策略:
- 底层存储保留:将历史记录保留在底层存储中,以满足合规和审计需求。
- 默认召回排除:从智能体的默认召回环节中排除这些记录,确保它们不会干扰当前的判断逻辑。
3. 临时任务产物
对于临时任务产生的文件或产物,一旦到期,应按照预先设定好的策略进行清理。具体是打标签归档还是直接删除,取决于实际的业务要求。
记忆降权:压低无用信息的优先级
“遗忘”的另一种形式是降权(Down-weighting)。
智能体的上下文窗口(Context Window)资源是有限的。如果某条记忆在历史选择和使用中从未给实际解决问题带来过帮助,属于低效信息,那么它就不必永远占据宝贵的上下文空间。通过降权机制,可以让这类信息慢慢“沉底”,从而为高价值信息腾出空间。
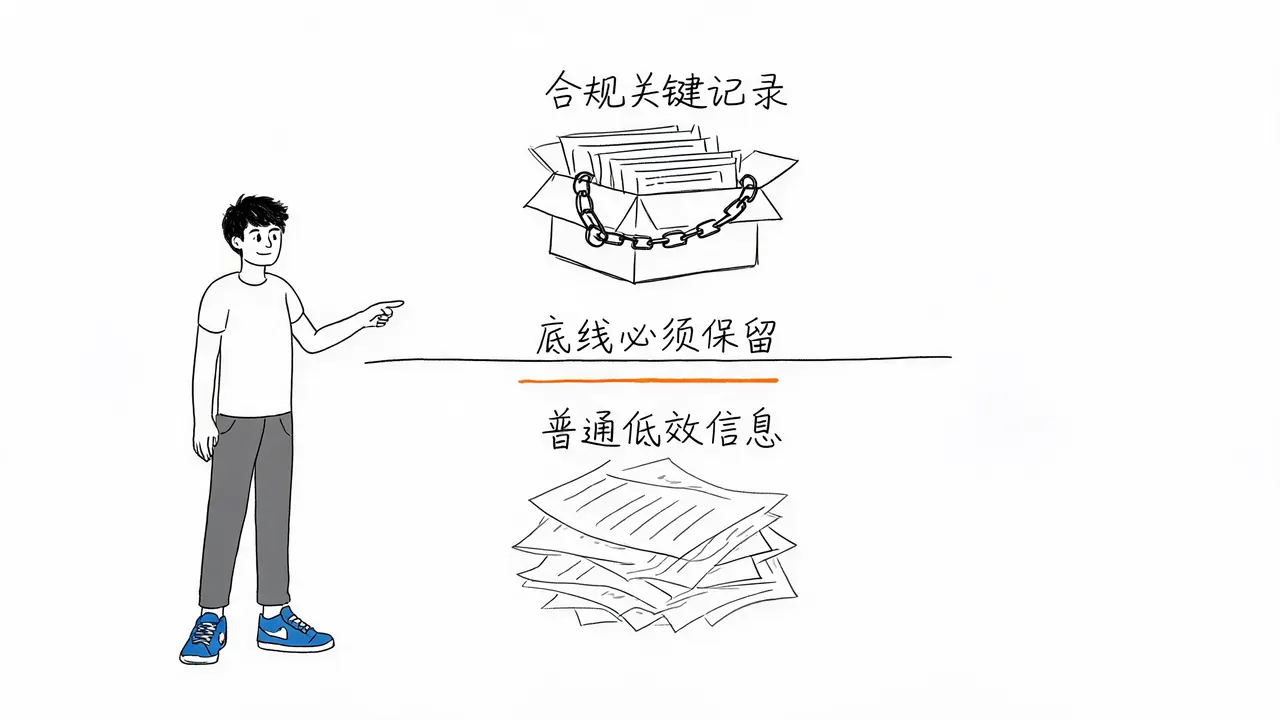
重要区分: 在实施降权或删除策略时,必须明确区分合规追溯关键记录与普通低效信息。
- 普通低效信息:可以降权或清理,以优化 Token 消耗和检索效率。
- 合规关键记录:绝不能为了单纯节省 Token 消耗而随意删除。该保留的底线必须保留,以确保系统的可追溯性和合规性。
评测建议:引入动态变化场景
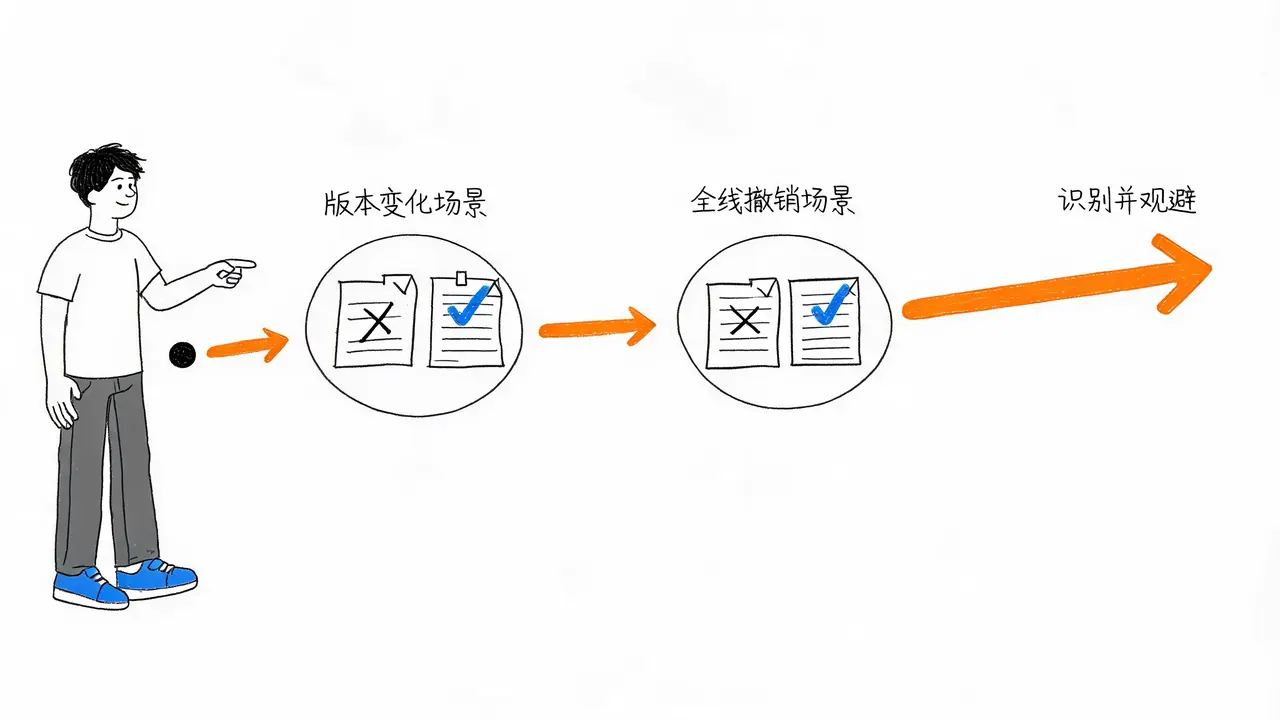
为了验证记忆系统的有效性,建议在评测过程中刻意加入以下测试场景:
- 版本变化场景:模拟信息版本更新,检查智能体是否引用了旧版本。
- 全线撤销场景:模拟某项政策或方案被中途撤销,检查智能体是否会继续引用已失效的内容。
通过这种动态变化的测试,可以检查 Agent 是否会“犯迷糊”,即是否具备识别并规避过时信息的能力。
结语
一个优秀的智能体记忆系统,其终极目标从来不是看谁保存的数据最多、存得最满。
真正的目标是在当前正在处理的任务中,能够精准提供那些:
- 仍然有效的信息;
- 确实必要的信息;
- 在规则上被允许使用的信息。
通过建立完善的记忆淘汰、降权和失效机制,智能体才能在复杂多变的环境中保持判断的准确性与高效性。