算力差距的隐性代价:从模型分数到人才成长速度的深层逻辑
中美 AI 模型在公开评测上的分数差距不到 3%,但双方每年用于训练大模型的算力总预算却不在同一量级。这两件事同时成立,揭示了算力差距的复杂性:它不是一个单一的倍数,而是一组不同维度的数据。
`` 是摘要与正文的分隔标记,请保留。算力差距的多维视角:为什么没有统一倍数?
在讨论中美算力差距时,许多争论往往源于口径不一。实际上,差距体现在三个不同的维度上,且每个维度的倍数都不同:
- 总算力规模:截至 2025 年初,美国约为 2400 EFLOPS,中国约为 1053 EFLOPS,差距约为 2 倍。
- 高端训练芯片:在高端训练芯片领域,差距约为 8 倍。
- 当季新增高端加速卡份额:一边不足 4%,另一边接近 70%,差距更是达到了数量级级别。
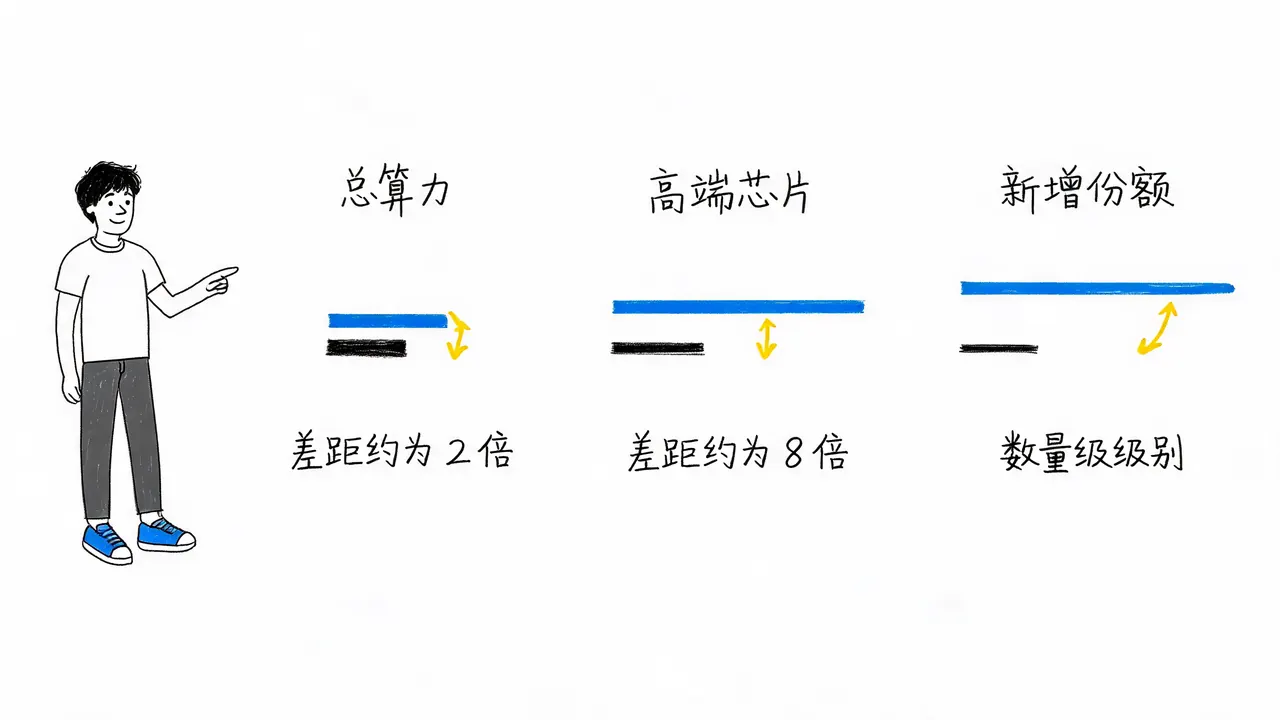
这三个口径都是正确的,因为它们衡量的对象不同。由于芯片型号、互联带宽、集群利用率及软件栈成熟度存在差异,无法给出一个精确的“美国算力是中国的几倍”的统一换算值。然而,资源不对称是客观存在的,其表现形式并非榜单上的分数差,而是选择权的差异。
资源约束下的日常取舍:训练、研究与推理的博弈
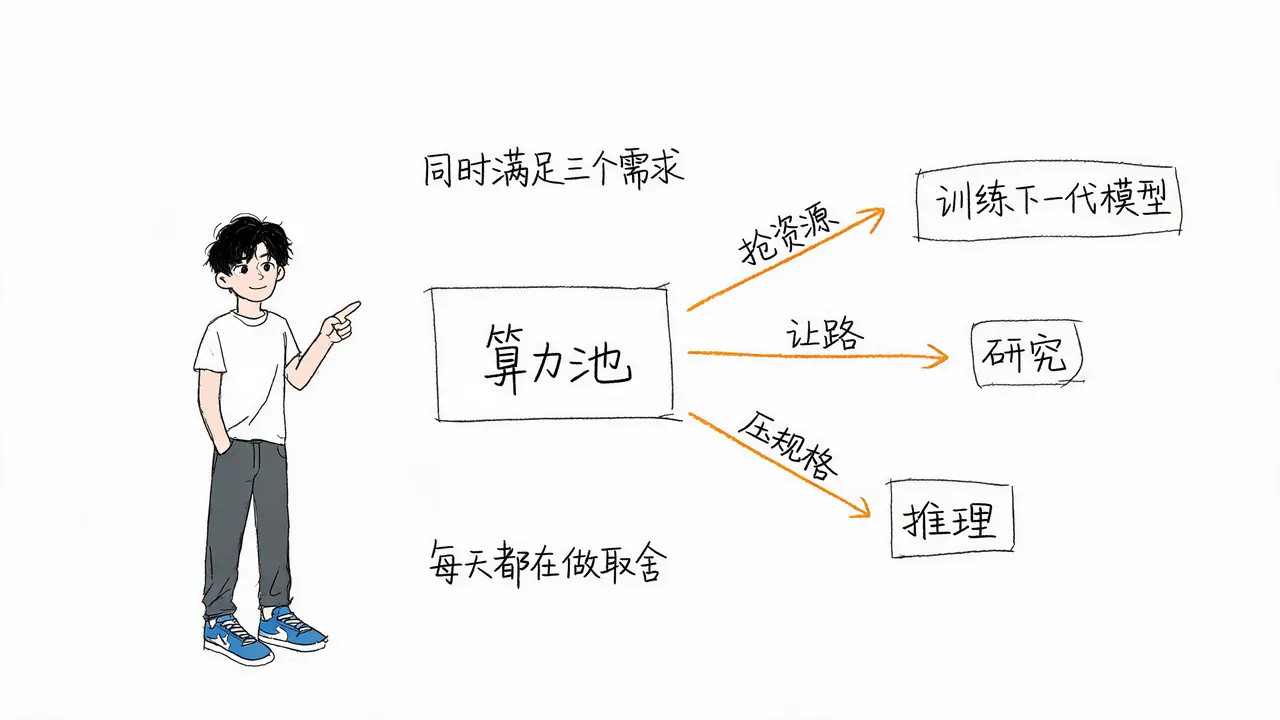
真正卡住一支团队的,往往不是算力总量,而是同一批算力需要同时满足三个需求:
- 训练下一代模型
- 跑研究实验(即“炉刺”,指训练实验的次数)
- 在线推理服务(面向外部用户)
算力宽裕的一方可以三条线并行推进;而算力紧张的一方,每天都在做取舍。这种取舍是天天发生的,比账面差距更“疼”,也更少被统计到。
1. 产品形态是资源约束的影子
训练和推理互相抢资源是常态。保住对外推理,训练和实验的算力就得让路;反之,用户能体验到的推理规格就得压下去。
这种内部博弈直接体现在普通用户拿到的模型规格上:
- 上下文长度能开多长?
- 默认思考时长是多少?
- 每分钟提问次数限制?
- 高规格版本是否单独付费?
很多人以为这些是产品经理拍板决定的,其实很多时候是算力预算决定的。当一家公司突然放开免费额度或调长思考长度,往往不是因为它变“慷慨”了,而是因为它那一次的算力宽裕了。看懂这一层,许多产品公告就能读出第二层意思。
2. 探索半径的收窄:保守是被逼出来的姿势
更隐蔽且代价更大的取舍,在于能同时推进几条技术路线。
- 算力宽裕方:可以同时压十条技术路线,允许其中八条失败。
- 算力紧张方:必须先在会议室里把道理想清楚,然后只压一两条,“想清楚再开炉”。
在实验学科中,这种“谨慎”有着沉重的代价:它意味着放弃了撞见意外的机会。化学史上大量的重大突破来自没预料到的实验结果。一支只做有把握实验的团队,永远不会走到那次意外突破上去。
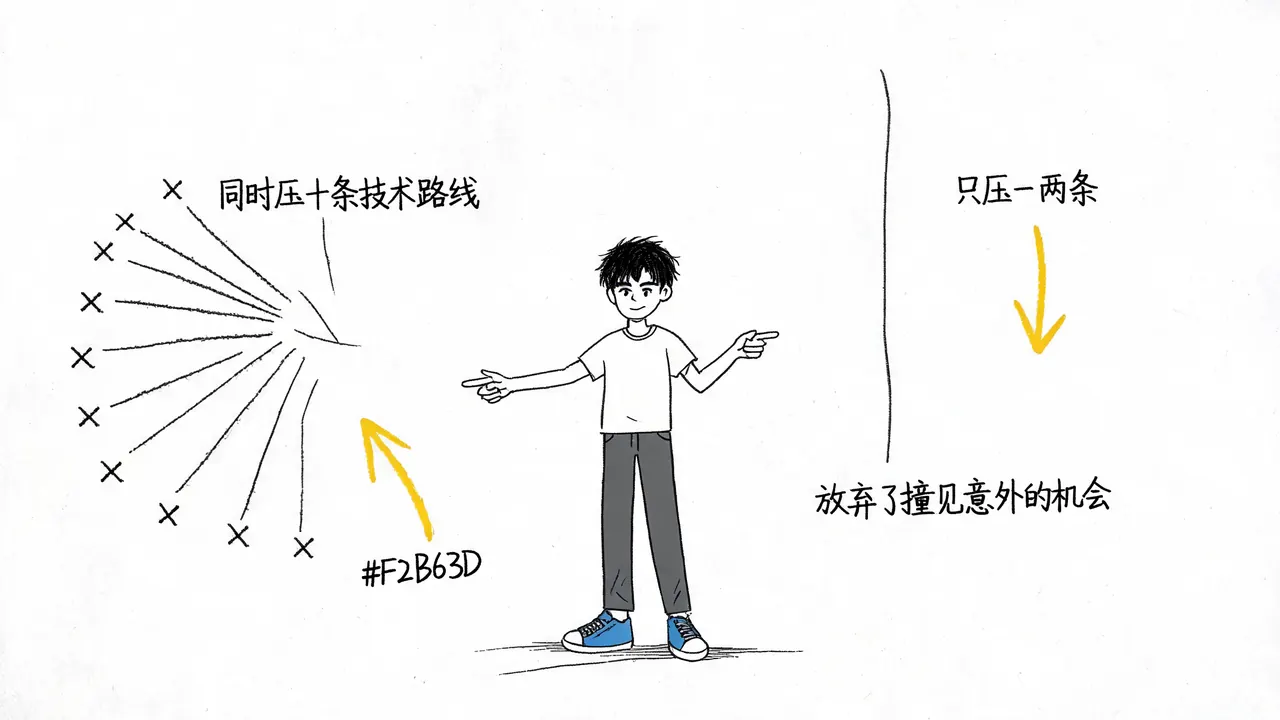
资源约束最贵的地方在于,它不只是让你变慢,还悄悄收窄了你的探索半径。你只能沿着已知最有希望的方向挪动,而真正的跨代突破经常不在那个方向上。因此,保守往往不是主动选择,而是被算力逼出来的姿势。
隐性代价:人才成长速度与实验席位
前面两种取舍,最终都会落到“人”身上。
同样优秀的两个年轻研究员,一边一年能亲手参与几次大规模训练,另一边只能读别人的日志。手感经验只能亲手做出来,更努力可以补上进度,但补不上手感。这不是态度问题,而是席位问题。
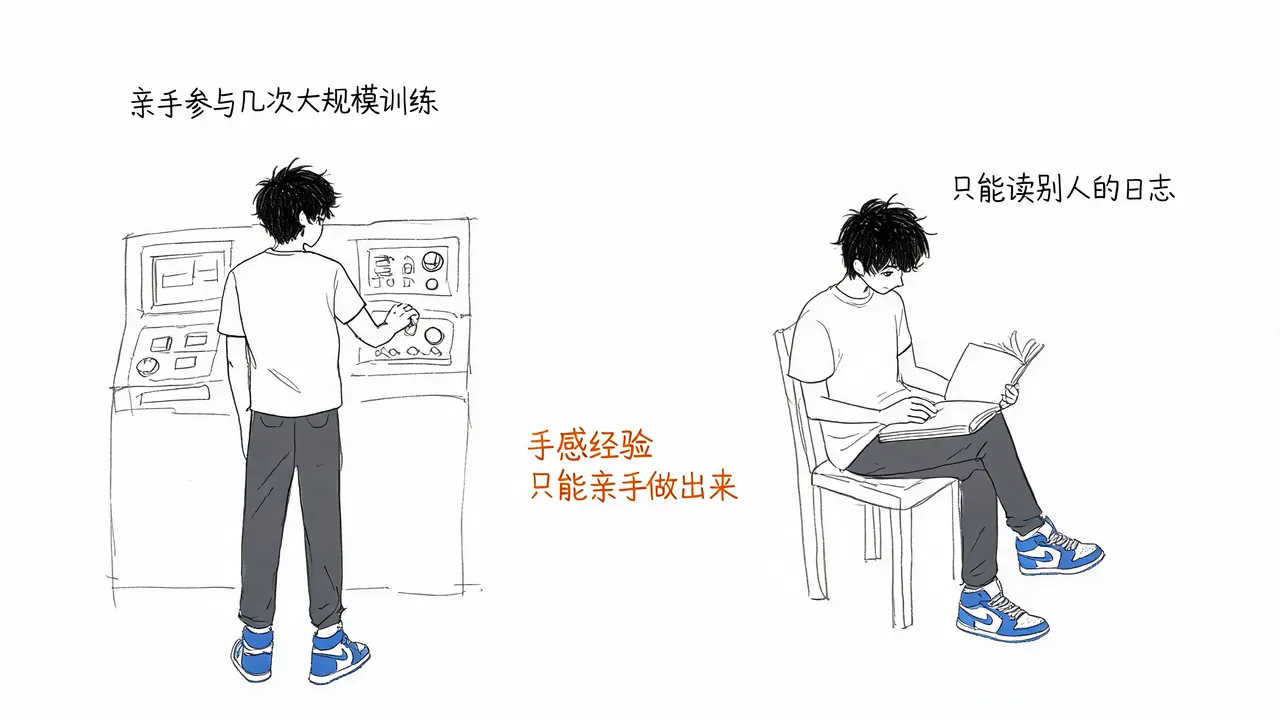
常见的讲法是中国缺人才,但这并不准确。中国从来不缺后辈人才,理工教育的规模摆在那里,每年输送的优秀毕业生非常多。真正缺的是把后辈变成主力的实验席位。
这是算力约束里最难被统计、也最晚显行的一部分:
- 它不会出现在任何一份算力报告里。
- 它不会反映在今年的榜单上。
- 它反映在五年后:那一批本来可以成为主力的人,手上少了几百次亲手训练模型的记录。
注:这一条是基于逻辑的推论,而非已被完全验证的结论。
结语:差距落在哪里?
算力不是智能,但它决定了一个国家一年能进行多少次通往智能的实验,以及多少人能坐上那张实验台。
差距确实存在,但它不落在你正在看的那张评测表上,而是落在:
- 训练实验的次数上;
- 探索半径上;
- 五年后的人才厚度上。
尽管资源紧的一方在隐性维度上吃亏,但事实是公开榜单上的差距真的只有不到 3 个百分点。如果算力差好几倍,为什么效果只差这么一点?答案不在榜单里,而在你每问一句话时,两边各自烧掉了多少算力。
下一集预告:同一个问题,两边烧掉的算力不是一个量级。