Redis为什么这么快?揭秘其高性能核心机制
Redis 以其极高的性能著称,能够轻松应对每秒十万次的请求。在如今高并发的互联网场景中,传统数据库往往受限于磁盘读写延迟,而 Redis 则通过独特的设计彻底打破了这一瓶颈。
那么,Redis 究竟凭什么如此快速?它为何坚持使用单线程处理任务?又是如何同时处理成千上万个用户并发访问的?本文将拆解让 Redis 跑起来的核心机制。
1. 内存存储:消除磁盘 I/O 延迟
Redis 高性能最基础的原因,在于它将数据直接存储在内存中。
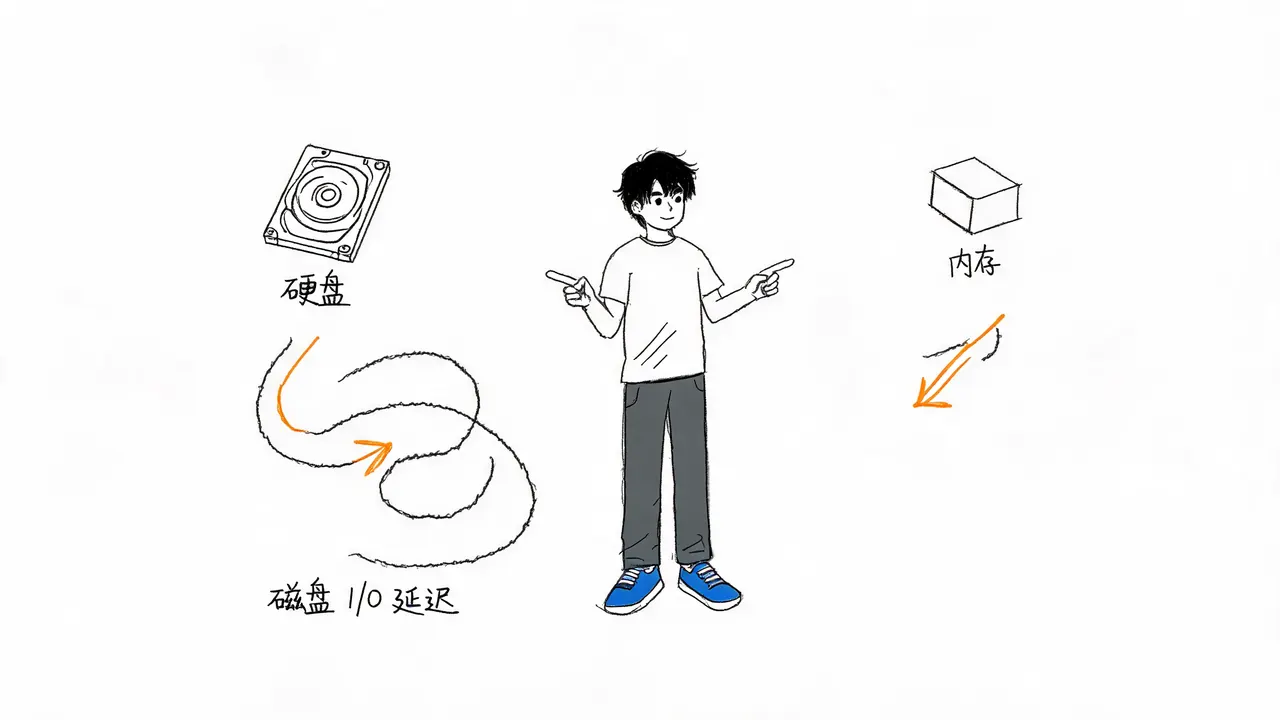
传统数据库(如 MySQL)的数据通常存储在硬盘上。我们可以将硬盘想象成一个巨大的远程仓库,每次查找数据都需要“开车”去仓库翻找货架,这在计算机中被称为磁盘 I/O 延迟。
相比之下,Redis 将数据直接放在服务器的内存里,就像把数据放在手边的办公桌上,伸手即可获取。这种设计省去了访问磁盘的时间,使得基础读写速度提升了几个数量级。
2. 单线程模型:避免上下文切换与锁竞争
除了内存存储,Redis 还有一个反常识的设计:其核心执行逻辑是单线程的。
很多人直觉认为多线程同时工作会更快,但在处理内存中的简单读写时,多线程反而可能带来麻烦:
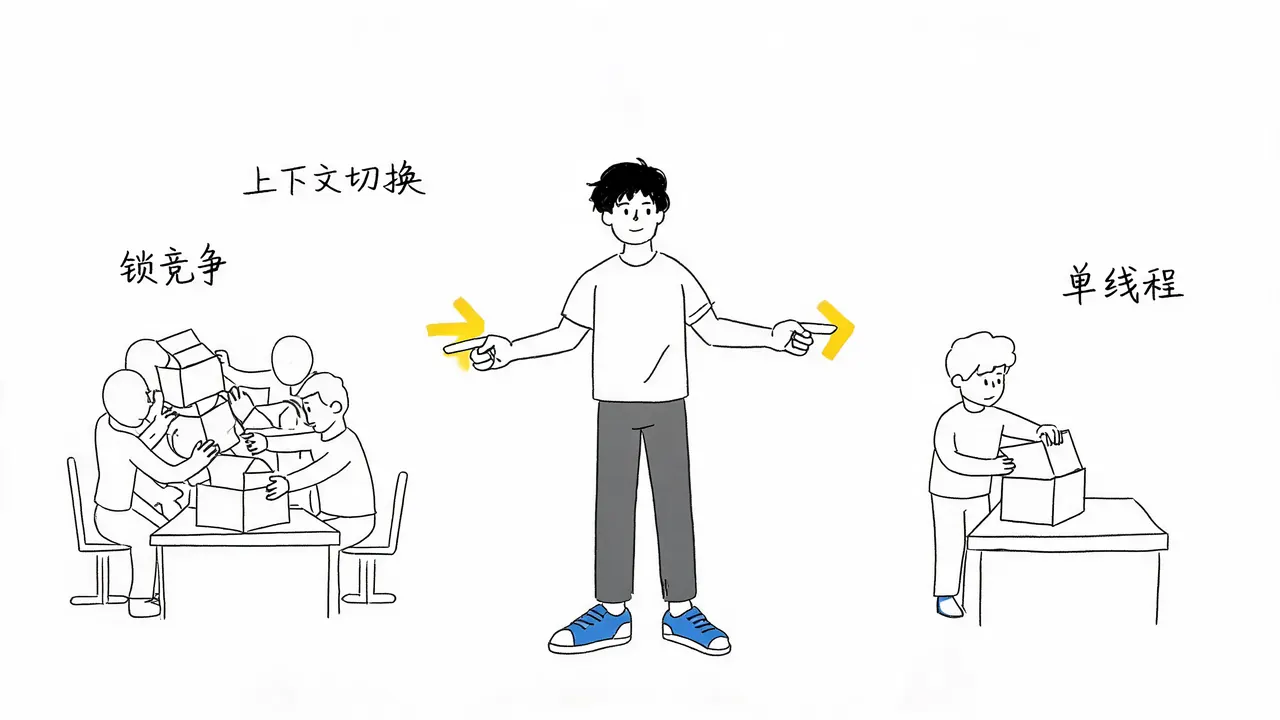
- 多线程的弊端:想象一个狭小的工作台,如果多个人同时抢着打包,他们需要不断沟通“这个包裹归谁”、“别拿错我的”,这会导致效率下降。在计算机中,这对应着线程上下文切换和锁竞争带来的内部消耗。
- 单线程的优势:Redis 采用单线程,就像一位极其熟练的打包员专注干活,避开了上述内部消耗,将算力全部用于处理实际业务。
3. IO 多路复用:高效处理海量连接
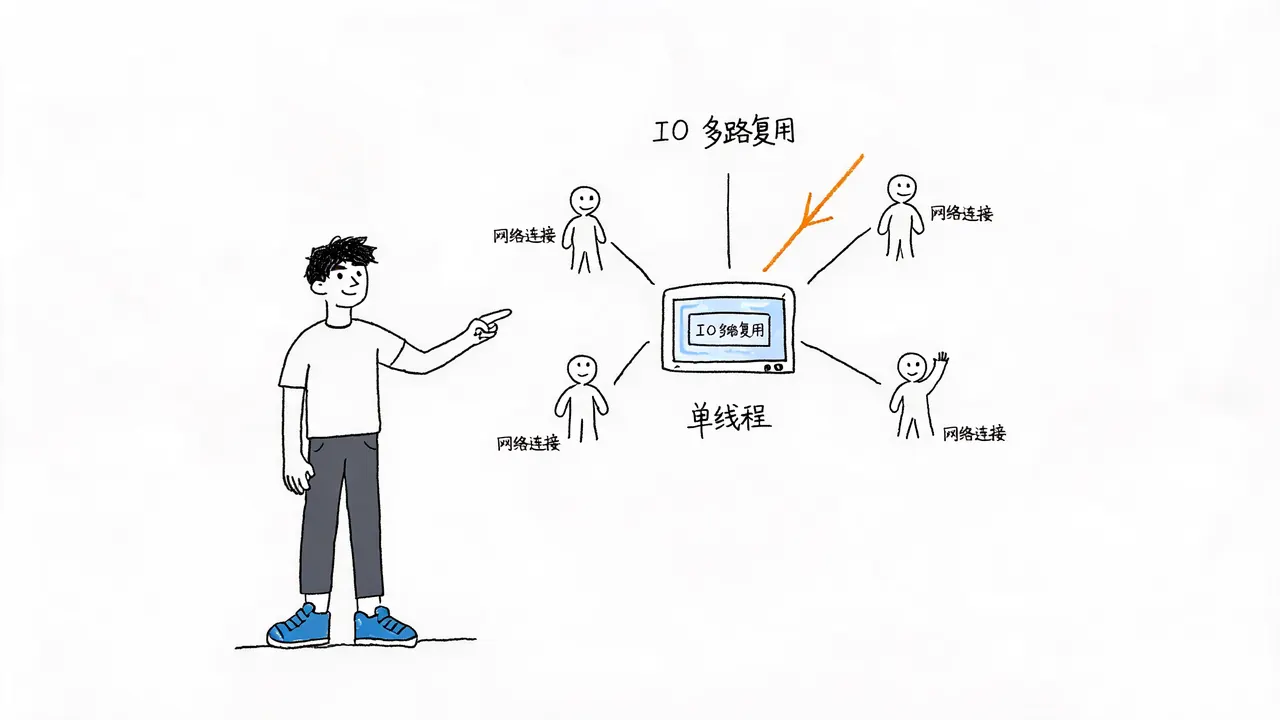
既然只有一个“工人”(单线程),Redis 是如何同时接待成千上万个“客户”(网络连接)的呢?这得益于其网络层的绝招:IO 多路复用。
- 传统模式:一个服务员接待一个客人,如果客人点菜慢,服务员只能干等,资源被占用。
- IO 多路复用:就像给前台配了一个智能监控屏。服务员不需要死等某一个客人,而是盯着屏幕,哪个客人的菜准备好了、哪个客人举手了,就立刻去处理谁。
这种机制让 Redis 的单线程能够同时挂起并处理海量的网络连接,不会因为某个连接卡顿而拖慢整体速度。
4. 性能边界与注意事项
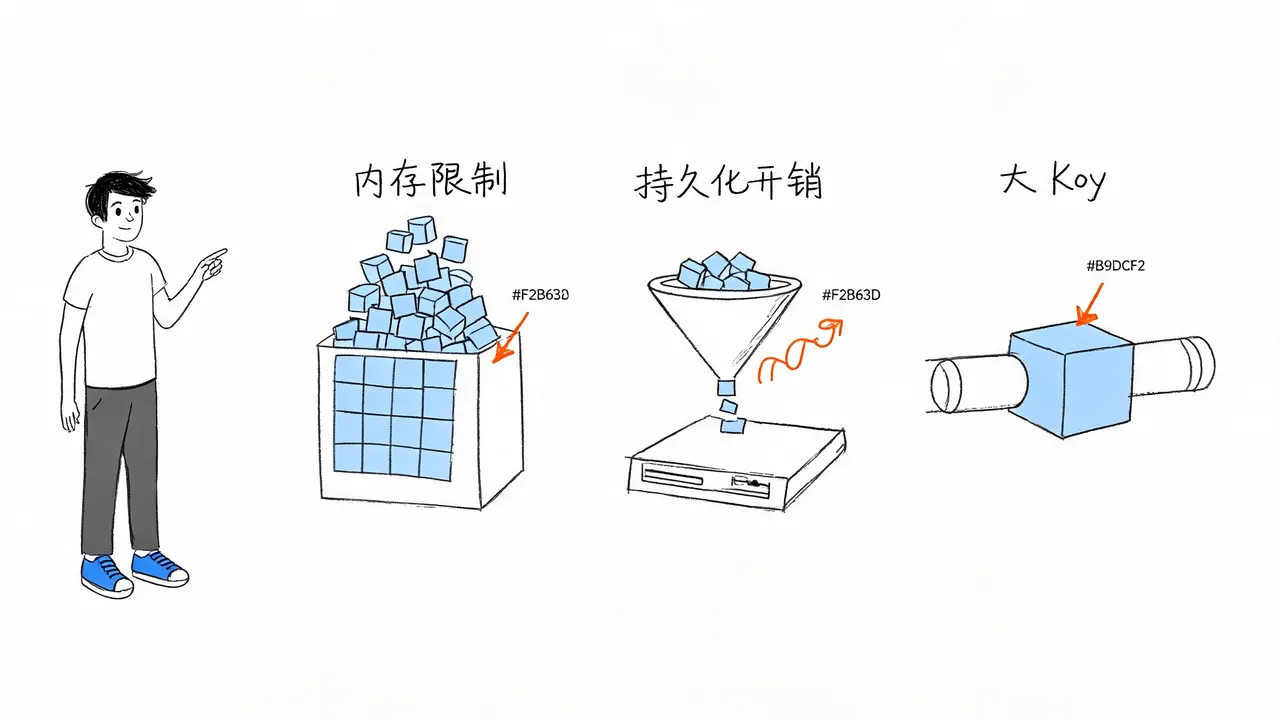
尽管 Redis 非常快,但它并非在任何情况下都绝对不卡顿,其性能存在物理边界:
- 内存限制:当数据量超出服务器内存的物理上限时,性能会受到影响。
- 持久化开销:在进行数据备份(将内存数据写回硬盘)时,可能会出现明显的延迟。
- 大 Key 问题:如果存储了超级大的数据对象(大 Key),单线程在处理这个庞然大物时,会阻塞后续的所有请求。
因此,在实际使用中,控制单条数据的大小和合理规划内存,是保证 Redis 持续高性能的前提。
总结
Redis 的快并非依靠无脑堆砌硬件,而是通过以下机制将每个环节的效率发挥到极致:
- 内存存取:消除磁盘 I/O 延迟。
- 单线程模型:减少线程切换与锁竞争的内耗。
- IO 多路复用:提高网络接待效率。
看清这套机制,我们就能明白:在系统架构中,没有绝对完美的万能组件,只有将特定能力发挥到极致的专属利器。