Redis为什么要搞主从复制?一台Redis不够用吗?
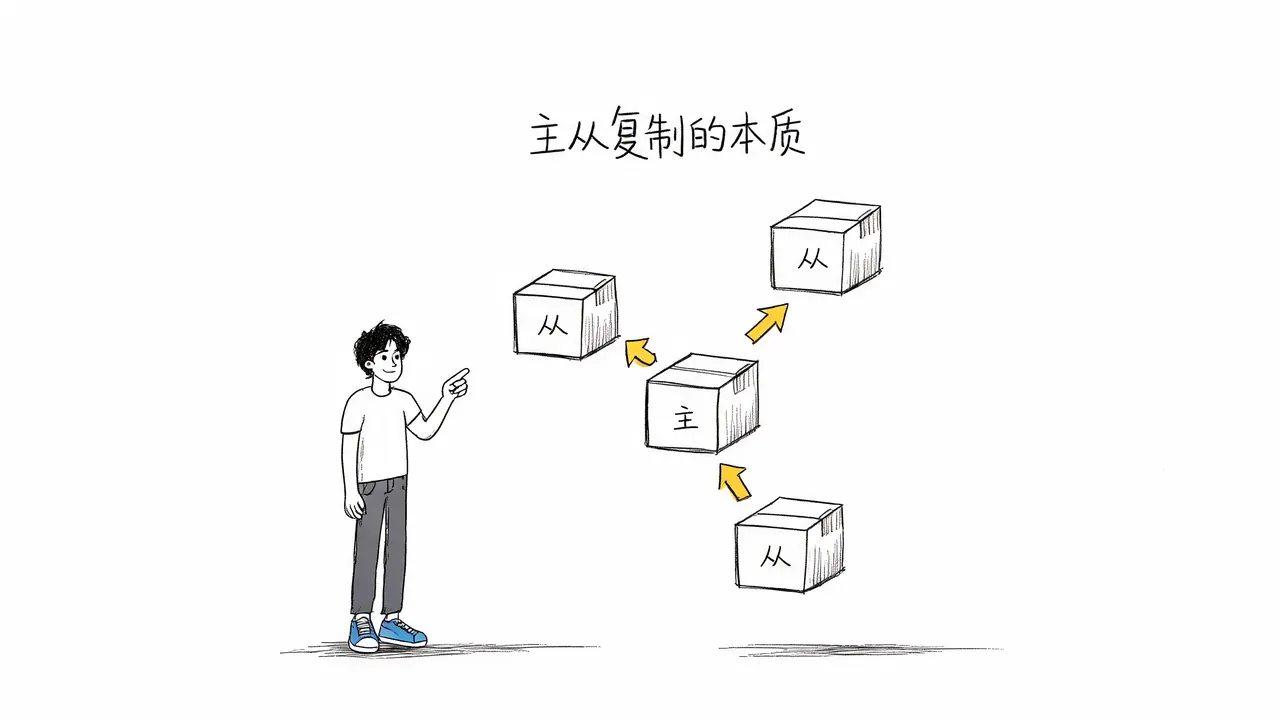
很多开发者在初识 Redis 时都会产生一个疑问:Redis 单机性能如此强劲,每秒能处理数万次请求,为什么还需要引入主从复制(Master-Slave Replication)?一台服务器真的不够用吗?
答案是肯定的:在真实的业务环境中,单台 Redis 确实不够用。
主从复制的本质,是为 Redis 安排“分身”,让一台服务器专门负责写入新数据,而多台服务器负责读取和备份。本文将深入解析单机面临的瓶颈、主从节点的分工协作机制,以及这种架构模式无法解决的固有缺陷。
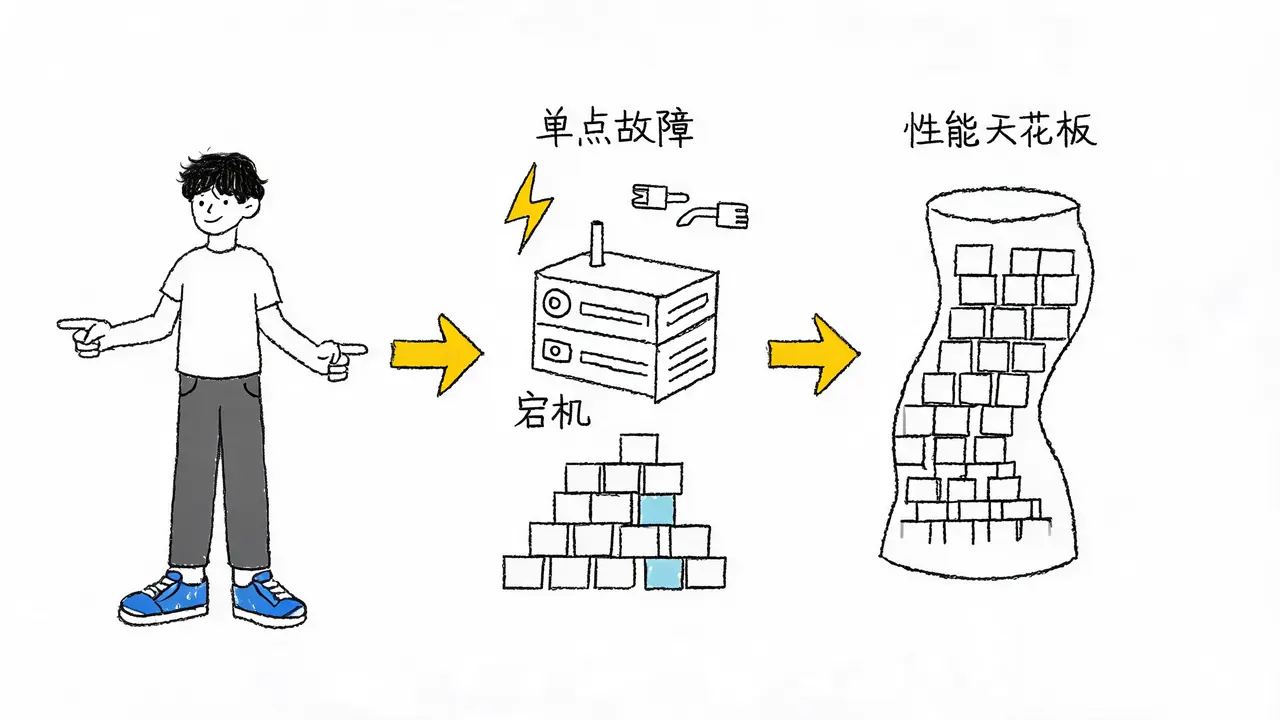
``单机 Redis 面临的两大致命风险
尽管 Redis 以高性能著称,但在生产环境中,单节点部署主要面临两个无法回避的风险:
1. 单点故障(Single Point of Failure)
无论 Redis 软件本身多么稳定,它都无法抵御物理层面的意外。例如:
- 机房断电
- 网络线路被挖断
- 服务器硬件损坏
一旦这台唯一的机器宕机,整个系统的缓存服务将彻底瘫痪,导致业务中断。
2. 性能天花板
虽然 Redis 的读写速度极快,但单台服务器的 CPU 核心数和内存容量存在物理上限。当遇到大促活动或热点事件时,海量用户同时发起查询请求,单台机器依然会出现排队和卡顿现象,无法无限扩展。
主从复制的核心分工:读写分离
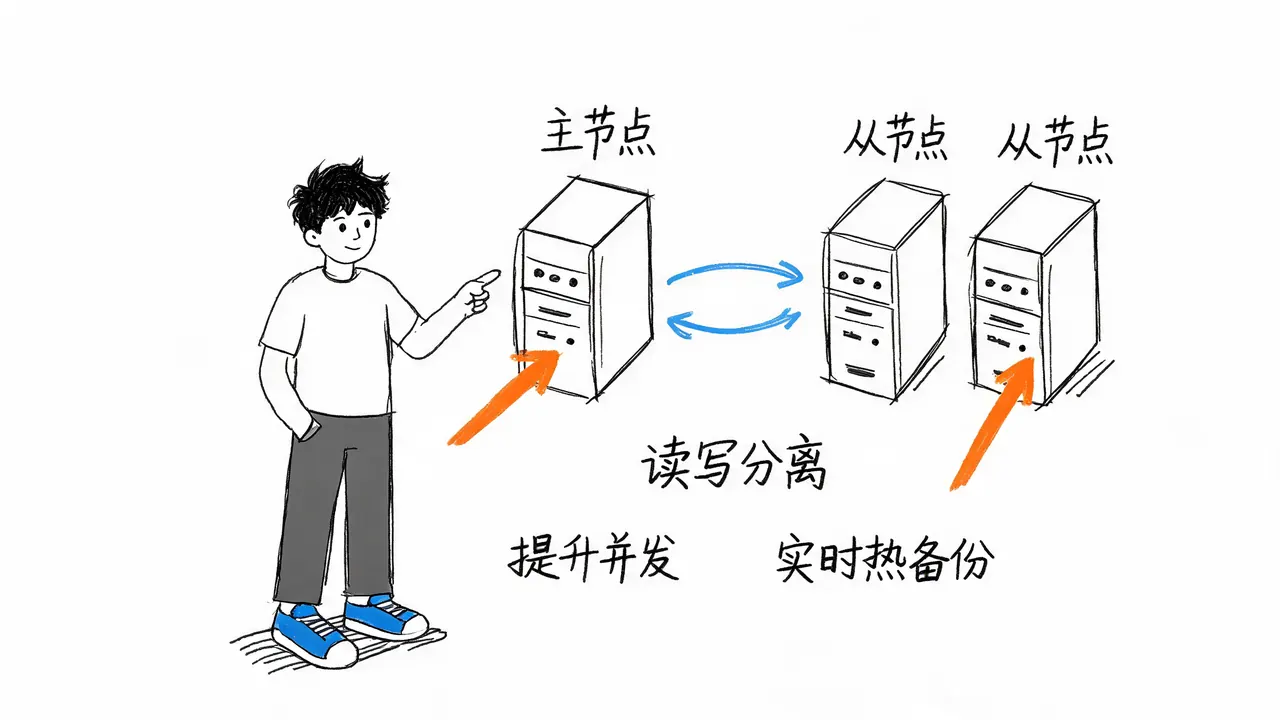
为了解决上述问题,主从复制将原本由一台机器承担的工作拆分给了一个“团队”。在这个团队中:
- 主节点(Master):原始数据的服务器,专门负责接收和处理写请求(如新增、修改、删除数据)。
- 从节点(Slave):拷贝数据的服务器,只负责读请求(即查询数据)。
这种模式被称为读写分离。其优势在于:
- 提升并发能力:查询压力被分摊到多台从节点上,系统的整体并发处理能力显著提升。
- 实时热备份:从节点手中持有一份完整的数据副本,相当于实现了实时的数据备份。
数据同步机制:全量与增量
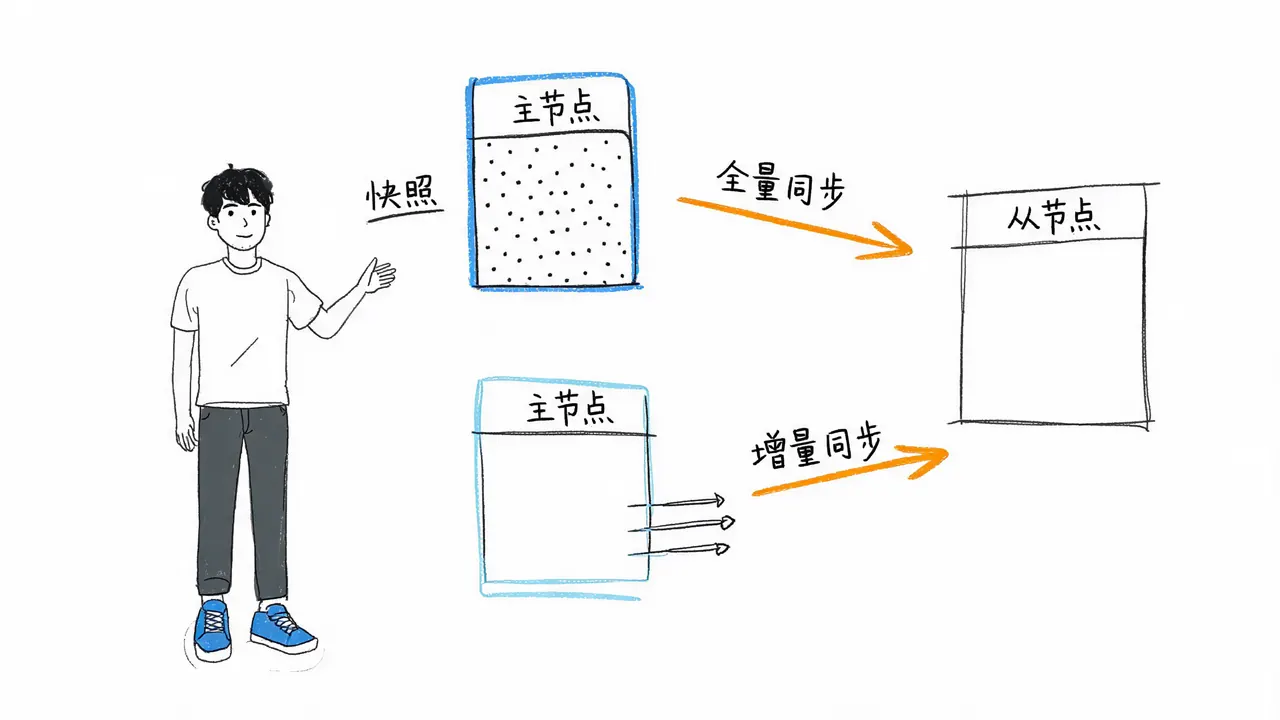
主节点的数据是如何实时同步到从节点的呢?这个过程分为两个阶段:
1. 全量同步(Full Sync)
当从节点刚加入集群时,主节点会将自己内存中的所有数据打包成一份快照,完整发送给从节点。这确保了从节点拥有初始的完整数据集。
2. 增量同步(Incremental Sync)
当从节点补齐数据后,双方进入日常协作模式。主节点每执行一条新的写命令,就会立刻将该命令通过网络传给从节点,从节点跟随执行一遍。通过这种机制,主从节点之间的数据能保持高度一致。
主从复制的局限性与误解
尽管主从复制解决了数据备份和读并发问题,但它并非万能药。这里存在一个常见的误解:认为只要不断增加从节点,Redis 的性能就能无限提升。
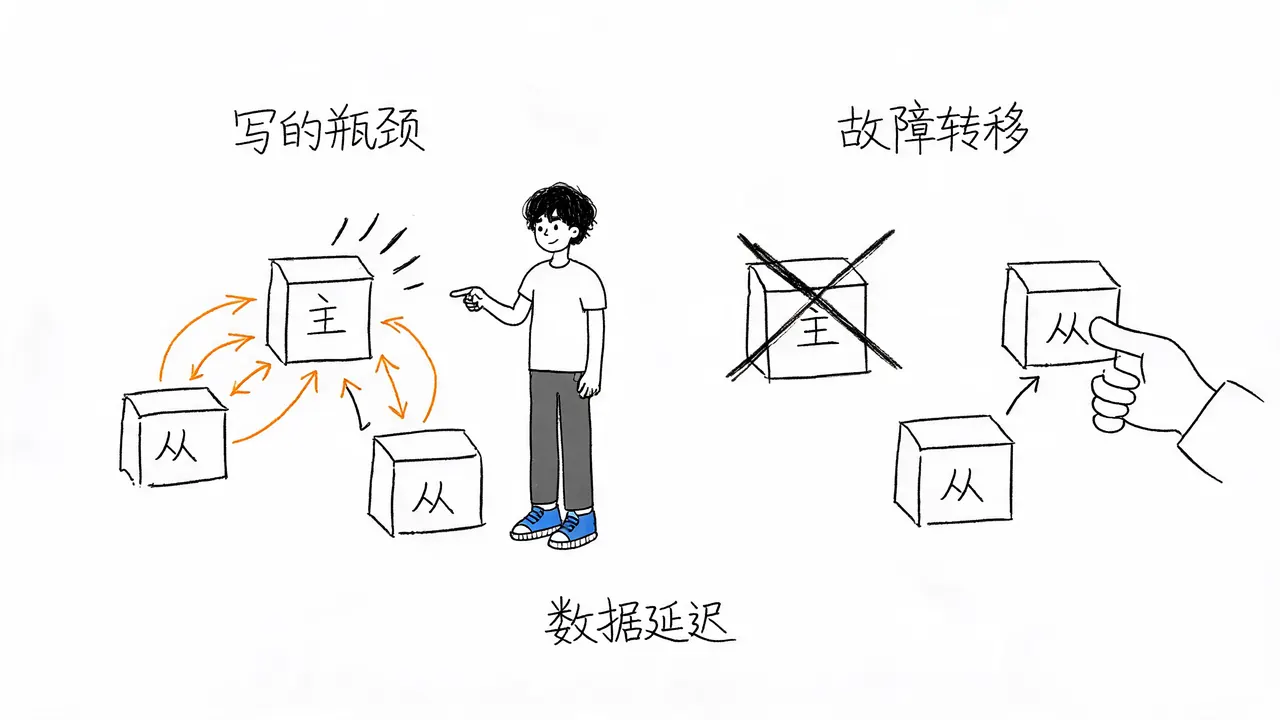
事实上,从节点只能分担读的压力,无法解决写的瓶颈。因为所有的写操作依然只能由唯一的主节点处理。如果业务场景是“写多读少”(如频繁更新库存、记录海量日志),主节点依然会被压垮,增加再多的从节点也无济于事。
此外,主从复制还有两个天然的硬伤:
- 数据延迟:数据从主节点通过网络传给从节点需要时间。如果网络抖动或主节点负载过高,从节点的数据会比主节点慢半拍,导致用户刚写完数据却立刻查不到(读旧数据)。
- 故障转移困难:如果主节点宕机,从节点虽然持有数据,但默认身份仍为“从属”,不会自动接管写请求。此时必须依靠人工介入修改配置,无法实现自动高可用。
结语
回到最初的问题:一台 Redis 确实不够用,但主从复制也不是包治百病的方案。
它完美解决了数据备份和读并发的问题,是 Redis 高可用架构不可或缺的地基。然而,正是由于它在自动故障转移和写并发上的局限,才促使后来演化出了哨兵模式(Sentinel)和集群架构(Cluster)。
理解了主从复制的分工与边界,也就看懂了 Redis 整个高可用体系的演进起点。