有了主从复制,为什么还要 Redis 集群?
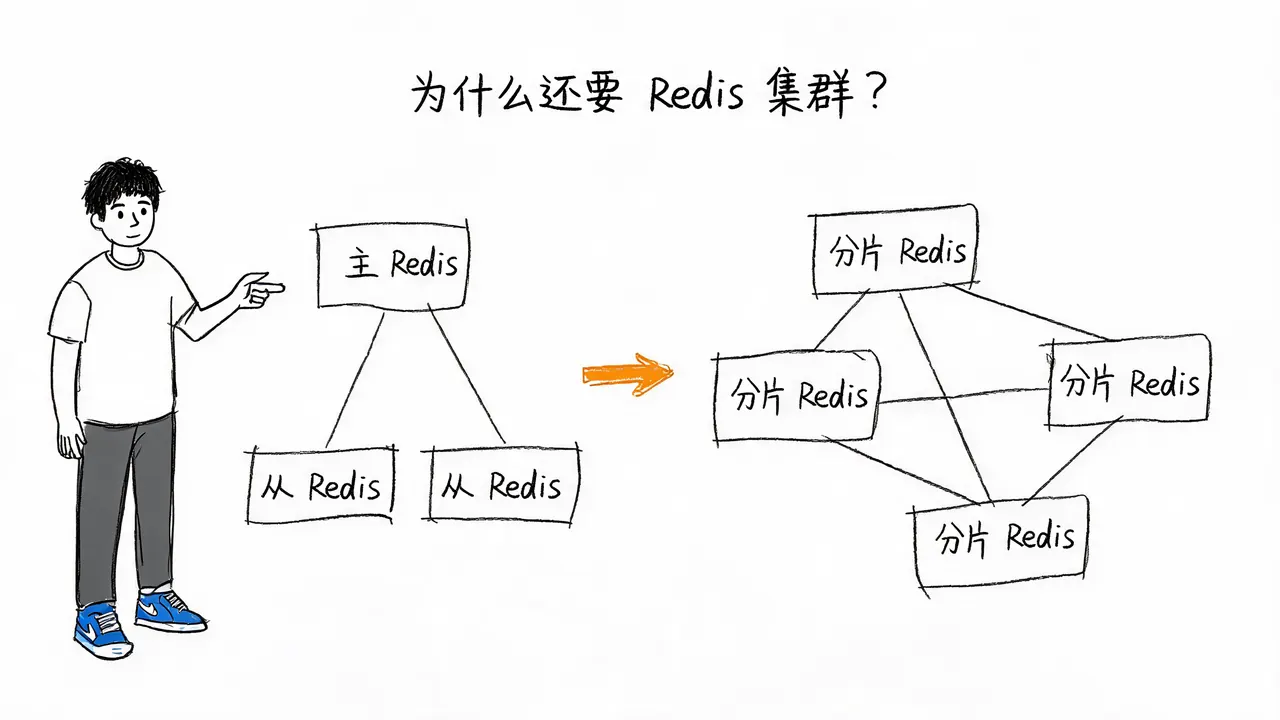
一句话说明白:主从复制解决的是“数据别丢”和“读得快”,而 Redis 集群解决的是“装得下”和“写得快”。
很多人认为主从复制已经足以应付高可用场景,但当业务规模扩大时,为何架构必须升级?本文将深入剖析主从复制的物理极限,以及 Redis 集群如何通过核心机制打破这一瓶颈,并厘清两者之间的真实关系。
`` 是摘要与正文的分隔标记,请保留。主从复制的物理天花板
要理解集群的必要性,首先必须看透主从复制(Master-Slave Replication)的本质与局限。
主从复制的核心机制是建立几个一模一样的完整数据副本:
- 主节点(Master):负责写入新数据。
- 从节点(Slave):同步主节点数据,并分担读取压力。
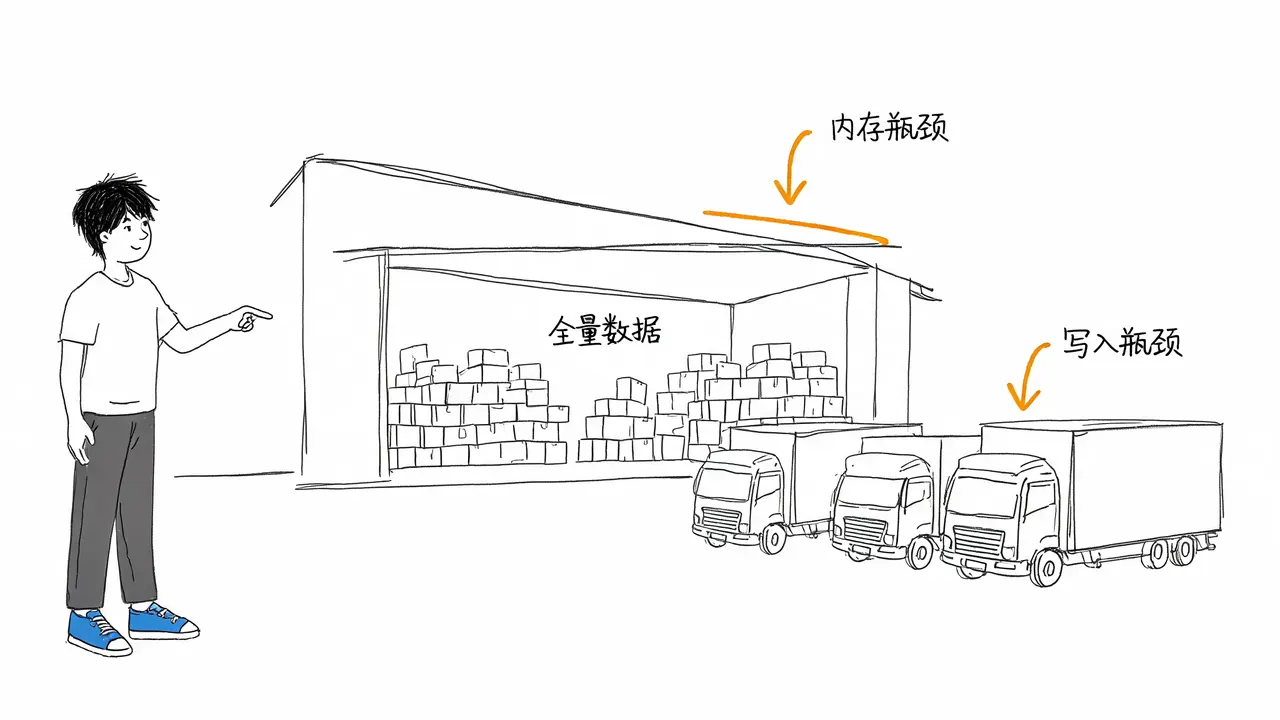
你可以将其想象为仓库管理:主仓库负责进货,从仓库负责出货。这种架构确实有效解决了数据备份和读并发的问题,但它存在一个致命的物理边界——每个仓库都必须装下所有的货。
这意味着:
- 内存瓶颈:如果数据总量超过了单台服务器的内存上限,主从复制将彻底失效。
- 写入瓶颈:如果写入速度超过了单个主节点的处理极限,系统性能将遭遇天花板。
哨兵模式不是集群
这里存在一个常见的误解:有人认为给主从复制加上哨兵模式(Sentinel),让其在主节点宕机时能自动选举新的主节点,这就构成了完整的集群。
事实并非如此。
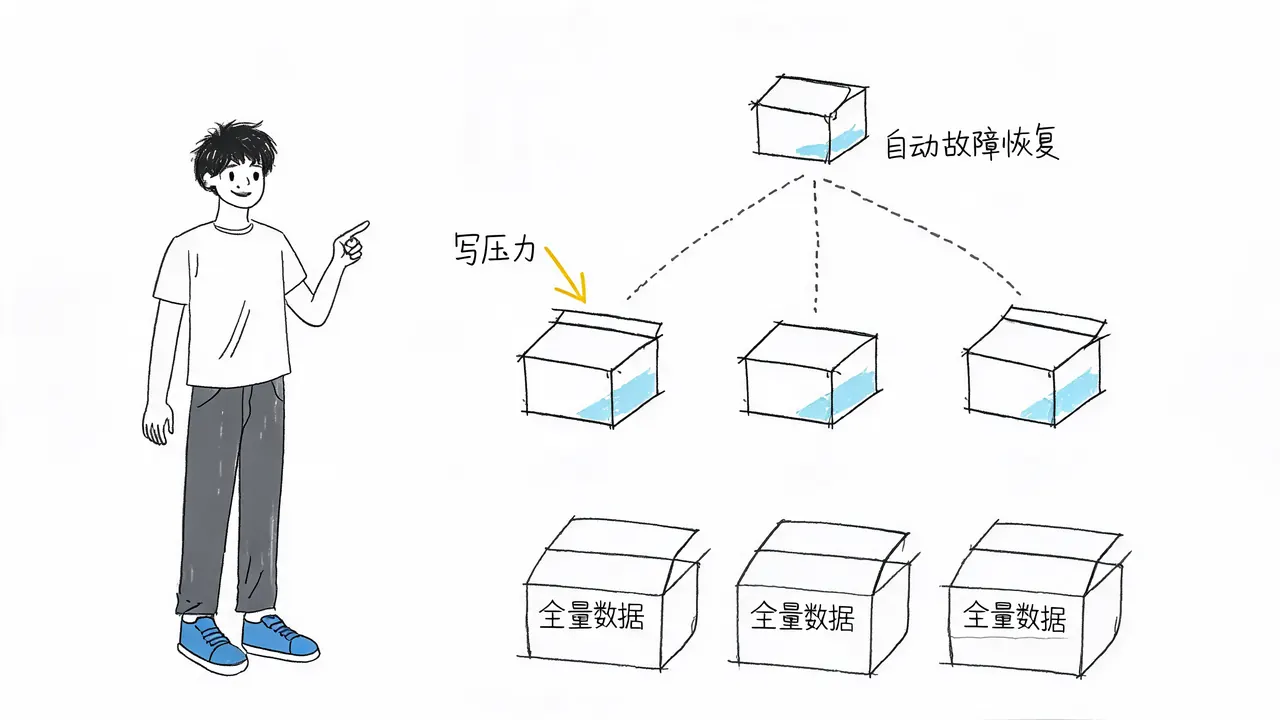
哨兵模式确实解决了自动故障恢复的问题,提升了系统的健壮性,但它依然没有打破单机容量的限制:
- 在哨兵模式下,所有节点依然存储着全量数据。
- 写压力依然全部压在那唯一的主节点上。
因此,哨兵模式只是让主从复制变得更可靠,但并未解决数据量大和写入快的问题。
Redis 集群的核心:数据分片
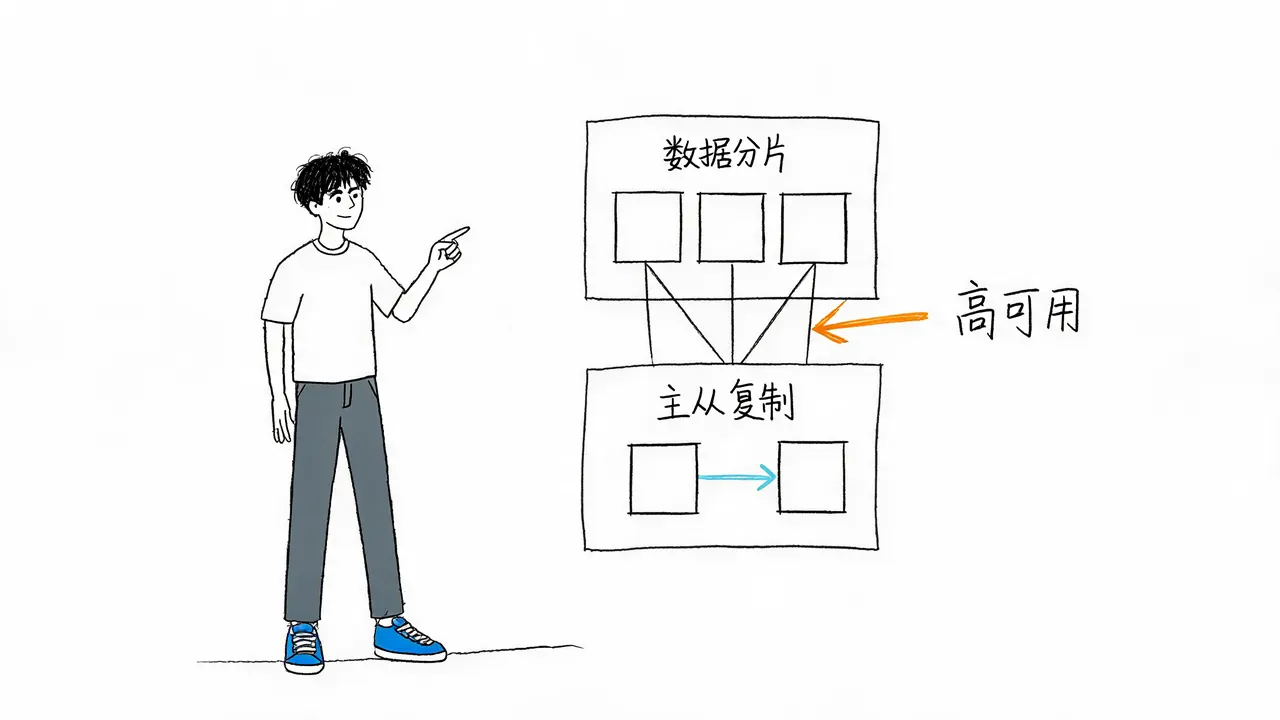
真正的 Redis 集群(Redis Cluster)通过**数据分片(Data Sharding)**打破了上述极限。它不再让每个节点存储所有数据,而是将庞大的数据集切分成许多小块,分散存储到不同的节点上。
哈希槽机制
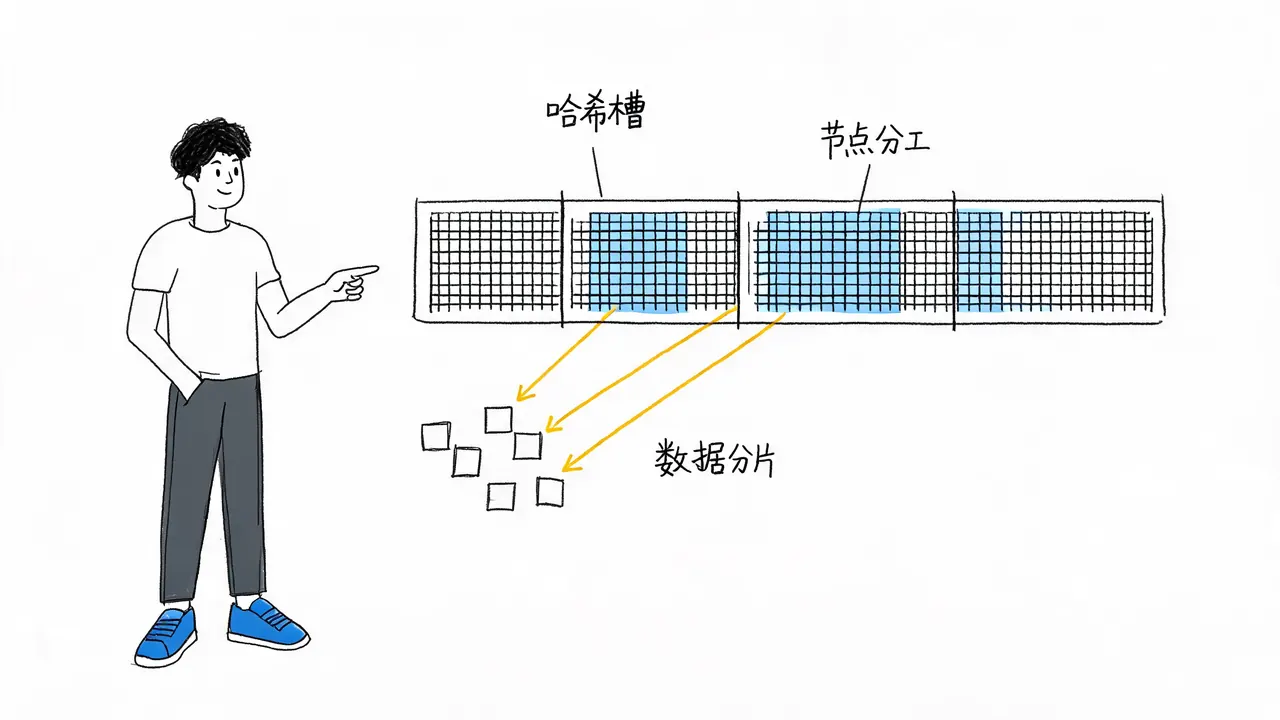
Redis 集群底层维护了 16384 个哈希槽(Hash Slots)。其工作原理如下:
- 数据落槽:每一条数据在写入时,都会经过计算,落入一个固定的槽位。
- 节点分工:集群中的每个主节点只负责管理其中的一部分槽位。
这好比将一个大总舱拆成了几个专门存放不同品类的小分舱,每个分舱只存自己负责的那部分货物。
自动路由与水平扩展
当客户端需要存取数据时,集群会自动将请求路由到负责对应槽位的那个节点。这种机制带来了两个关键优势:
- 打破内存瓶颈:数据分散存储,总容量等于所有节点内存之和。
- 分担写入压力:多个主节点同时处理写入请求,提升了整体吞吐量。
集群与主从复制的关系
重要的是,Redis 集群并没有抛弃主从复制,而是将其作为基础组件集成其中。
在集群内部,为了保证高可用,每个负责特定槽位的主节点,通常都会配备一个从节点来做数据备份。这意味着:
- 主从复制是基石:负责守住数据的安全底线和读操作的扩容。
- 集群是终极形态:建立在主从复制基础之上,通过数据分片实现了分布式扩展。
总结
主从复制和 Redis 集群从来不是非此即彼的替代关系,而是解决不同维度瓶颈的工具:
| 特性 | 主从复制 (+哨兵) | Redis 集群 |
|---|---|---|
| 核心优势 | 数据冗余、读并发扩展、自动故障转移 | 水平扩展、突破单机内存/写入极限 |
| 数据存储 | 全量副本 | 数据分片(哈希槽) |
| 适用场景 | 数据量适中、读多写少、对一致性要求高 | 海量数据、高并发写入、需要横向扩展 |
看清这个分工,你就能明白:系统架构的每一次升级,本质上都是在为特定的业务瓶颈寻找最对症的解药。