Elasticsearch 比 MySQL 更适合搜索?理清底层分工与架构选择
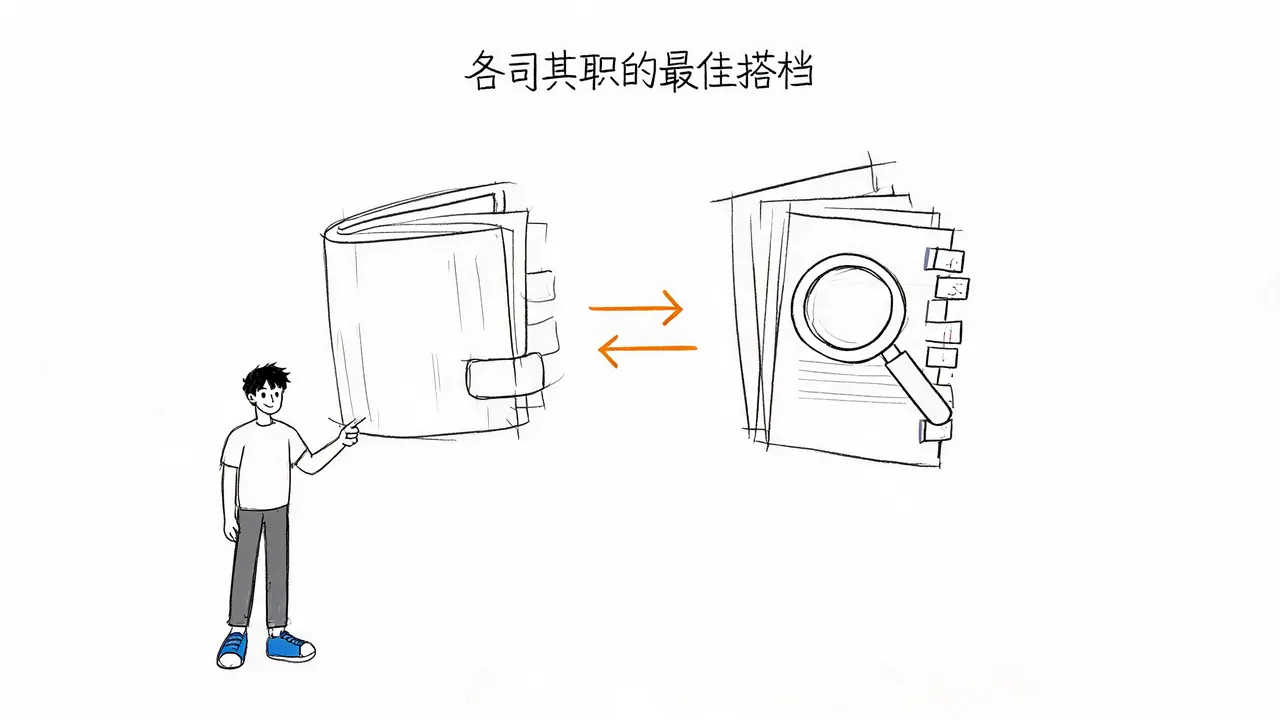
很多公司在构建搜索功能时,都会选择将数据从 MySQL 同步到 Elasticsearch。既然 MySQL 中已经存储了数据,为何还要多此一举引入另一套系统?
本质上,这是由两者的核心定位决定的:MySQL 是关系型数据库,擅长精确的“记账”与“算账”;而 Elasticsearch 是专门的搜索引擎,擅长模糊的“全文翻找”。
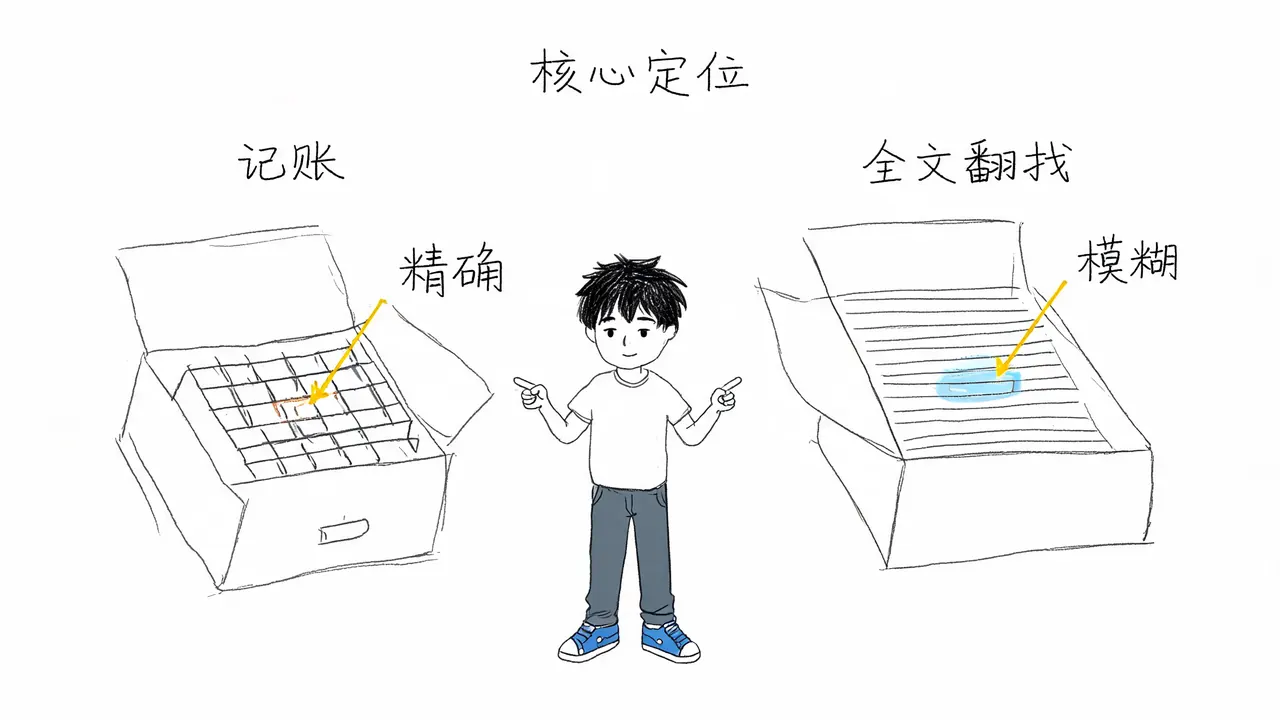
本文将深入剖析两者底层数据结构的差异,解释为何 MySQL 在处理复杂搜索时容易性能瓶颈,而 Elasticsearch 却能秒出结果,并探讨在何种场景下其实并不需要引入 Elasticsearch。
`` 是摘要与正文的分隔标记,请保留。MySQL 为何不适合复杂搜索?
MySQL 底层主要依靠 B+ 树 这种数据结构。你可以把它想象成一本按顺序排好页码的账本。
- 精确查询极快:如果你知道确切的订单号或者用户 ID,MySQL 能顺着目录瞬间定位到那一页,效率极高。
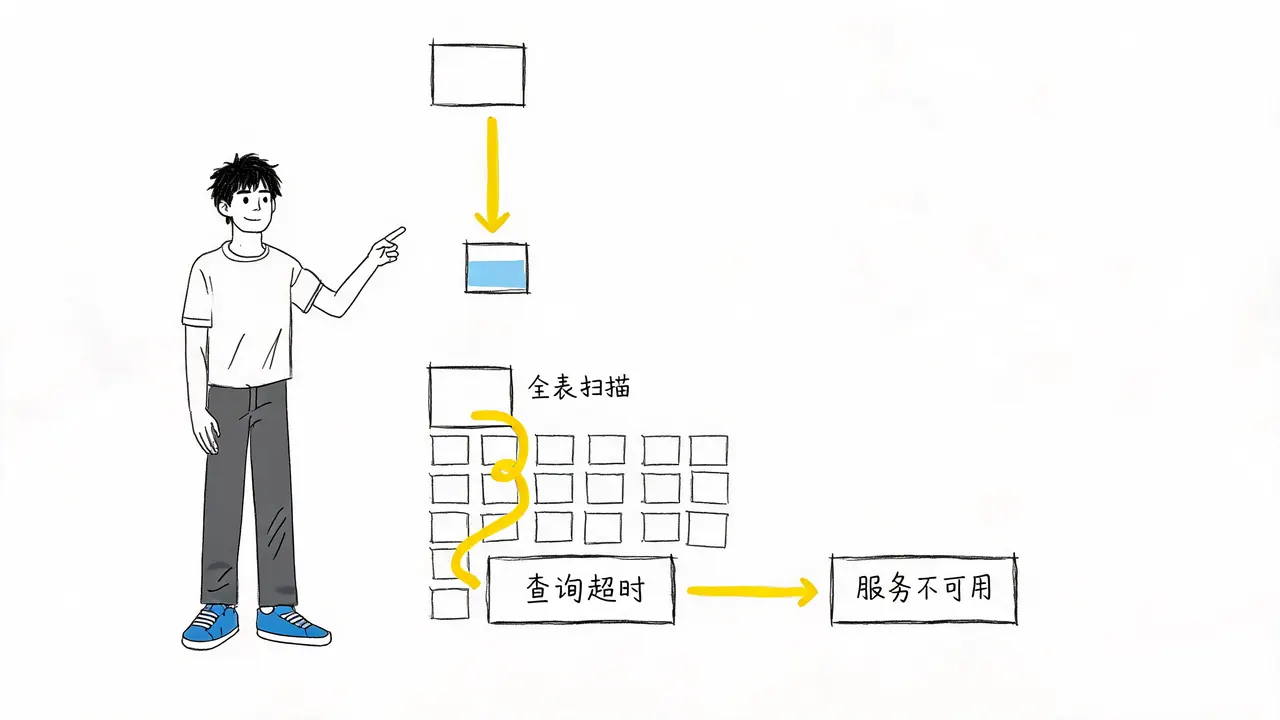
- 模糊查询灾难:但如果你要在商品描述里搜索包含“红色”和“连衣裙”的商品,MySQL 就“傻眼”了。它无法通过 B+ 树目录直接定位,只能从第一页开始,把几千万条数据挨个看一遍。
这种全表扫描在数据量巨大时,会直接拖垮数据库性能,导致查询超时甚至服务不可用。
Elasticsearch 如何实现秒级搜索?
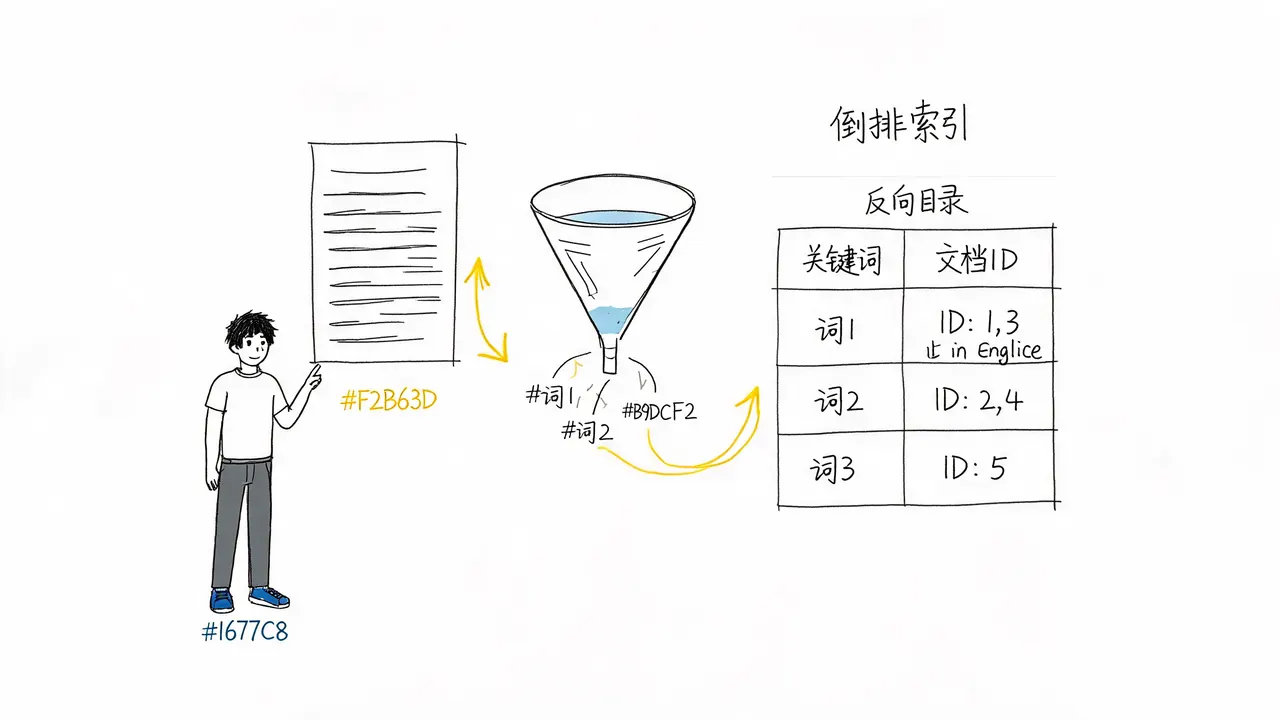
Elasticsearch 之所以能实现秒级响应,核心在于其采用的 倒排索引(Inverted Index) 机制。这就像书本最后附带的关键词索引页。
1. 分词与反向目录
当 ES 存入一条长数据时,会先将其拆解。例如,将“红色修身连衣裙”拆分为“红色”、“修身”、“连衣裙”三个词,然后建立反向目录:
- “红色”出现在第 1、5、8 条数据里。
- “连衣裙”出现在第 1、3、8 条数据里。
当你搜索时,ES 直接查这个目录,瞬间就能拿到所有相关数据的 ID,完全不需要去翻找原始数据。
2. 更懂人类语言
除了找得快,ES 还内置了分词和分析机制,能够处理:
- 同义词匹配
- 拼音搜索
- 常见的拼写错误纠正
3. 智能相关性排序
最关键的是,ES 会给搜索结果打分。例如,一件商品标题里同时出现了“红色”和“连衣裙”,它的得分就高,排在前面;只出现一个词的得分低,排在后面。这种按相关度智能排序的能力,是只能做精确匹配的 MySQL 完全不具备的。
什么时候不需要 Elasticsearch?
尽管 ES 在搜索方面表现卓越,但这并不意味着它可以替代 MySQL。
- 事务一致性:ES 不擅长处理复杂的财务转账,也没法保证像银行扣款那样绝对严密的事务一致性。
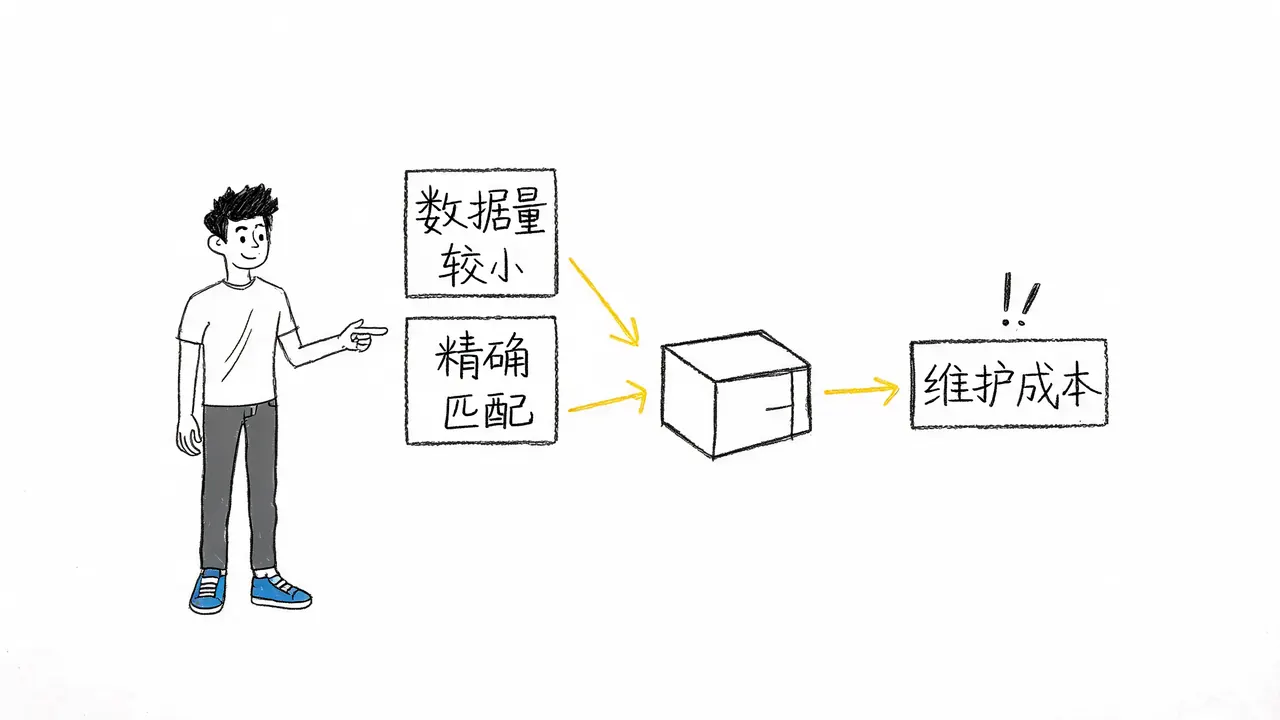
- 资源消耗:ES 非常吃内存,维护成本较高。
如果你的业务满足以下条件,MySQL 自带的查询功能完全够用,强行引入 ES 反而会增加数据同步的维护成本,且没有性能收益:
- 业务数据量较小(例如只有几万条)。
- 用户查询方式主要是精确匹配(如通过手机号、订单号查询)。
总结:各司其职的最佳搭档
在真实的业务架构里,MySQL 和 Elasticsearch 通常是搭档关系,而非替代关系:
- MySQL 做主账本:负责把每一笔交易记得清清楚楚,保证数据的绝对准确和事务一致性。
- ES 做前台检索:专门负责应对海量用户的模糊搜索需求,提供快速、智能的查询体验。
认清它们底层的数据结构差异,把记账的交给账本,把搜索的交给字典,才是系统设计的真正逻辑。