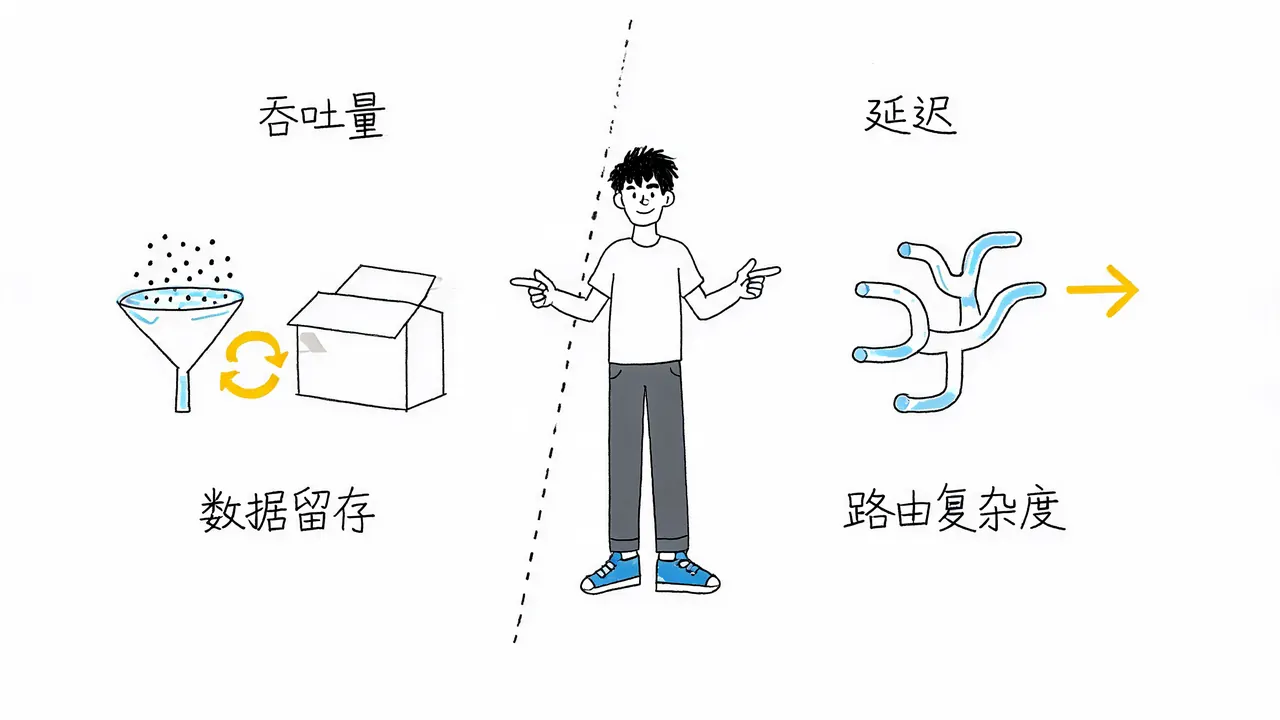
有了Kafka,为什么很多公司还在用RabbitMQ?
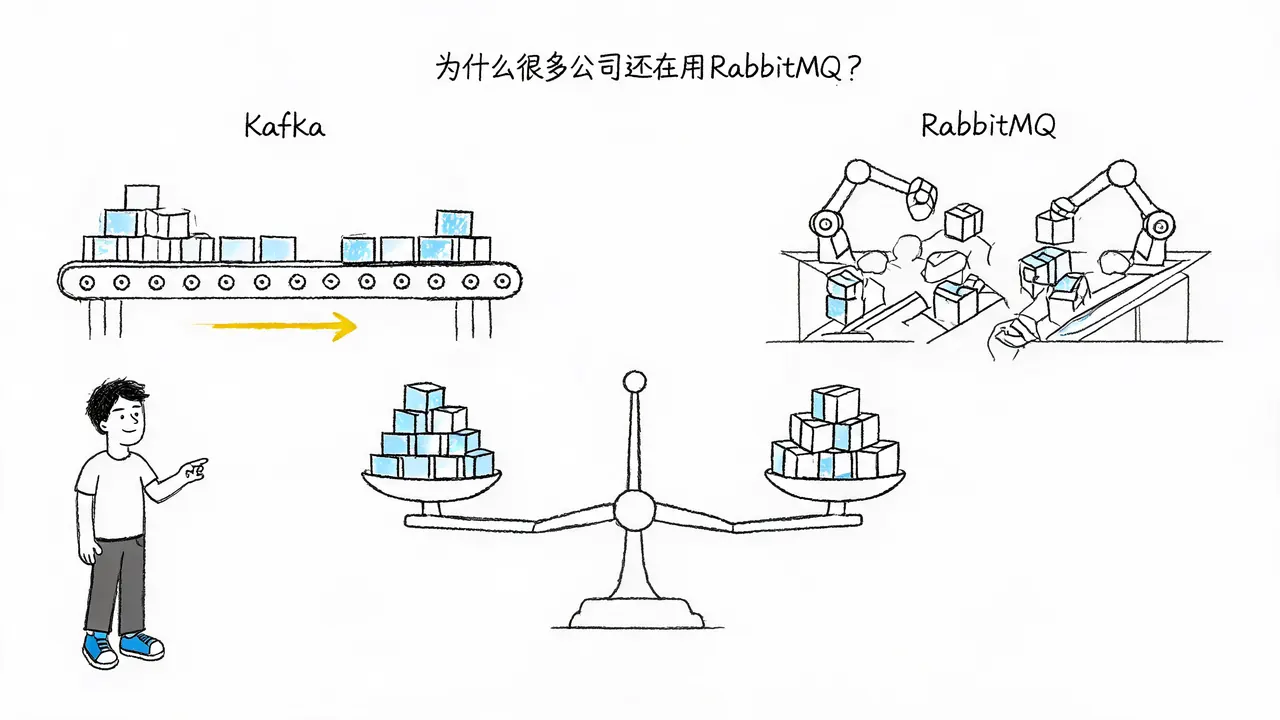
在分布式系统架构中,Kafka 常被视为“性能怪兽”,凭借其极高的吞吐量成为大数据领域的标配。然而,许多公司在引入 Kafka 后,依然保留着 RabbitMQ。这并非因为老系统难以迁移,而是因为两者在底层设计上属于完全不同的物种:Kafka 是分布式事件流平台,而 RabbitMQ 是传统的消息代理。
很多人存在一个误区,认为既然 Kafka 能处理海量消息,直接用其替换 RabbitMQ 即可。这好比因为重型卡车装载量大,就非要用它去送同层的急救药。吞吐量只是选型的一个维度,若仅看处理上限,很容易在真实业务场景中栽跟头。
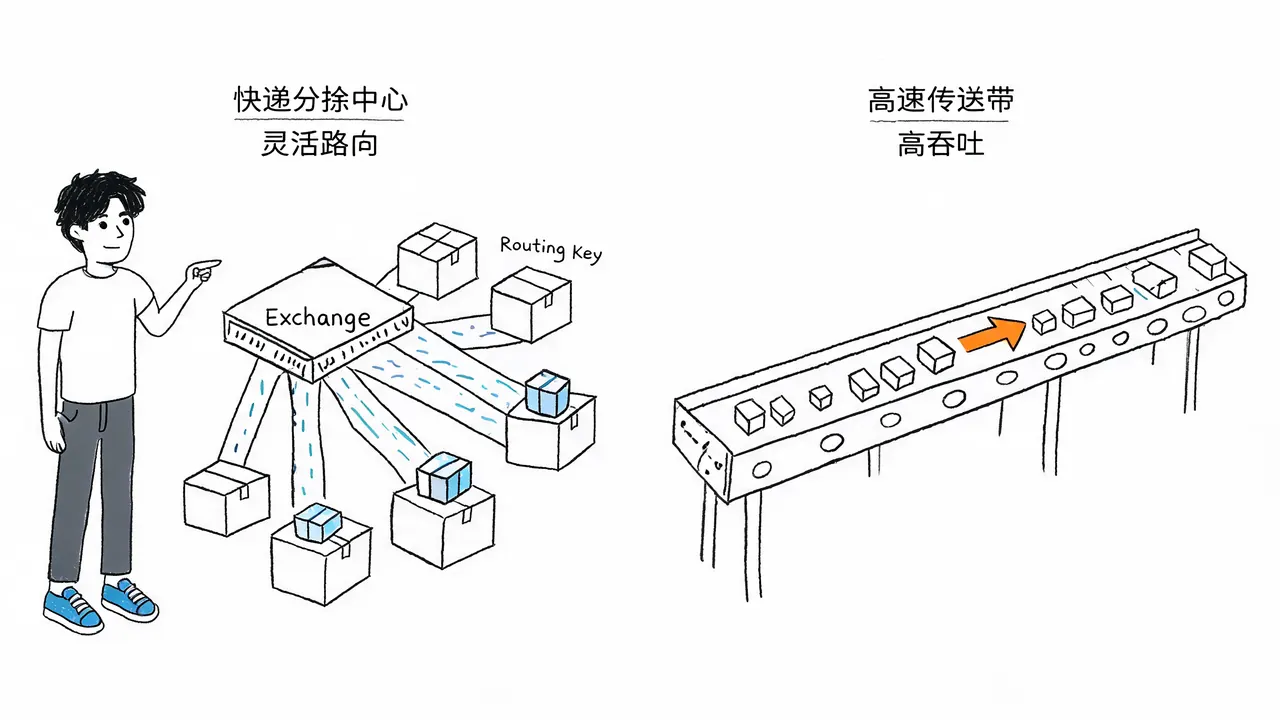
``核心定位差异:快递分拣中心 vs 高速传送带
要理解两者的区别,首先需明确它们的设计初衷。
RabbitMQ:灵活的消息路由
RabbitMQ 可以想象成一个高度智能化的快递分拣中心。当一条消息进入时,它可以根据预设的复杂规则(如交换机类型、路由键等),精准地将消息分发到对应的队列中。
- 推送模型(Push):消息一旦到达队列,代理会主动推给消费者。
- 低延迟:这种机制确保了消息能被快速投递,适合对实时性要求极高的场景。
- 灵活路由:支持多种交换模式,能够轻松应对复杂的业务逻辑分发。
Kafka:海量数据的搬运工
Kafka 的设计初衷并非为了复杂的消息路由,而是为了搬运和保存海量数据。它可以被看作一条超宽的高速传送带。
- 拉取模型(Pull):消费者根据自己的处理能力,主动从分区中批量拉取数据。
- 高吞吐与扩展性:这种设计侧重于最大化吞吐量和支持水平扩展。
- 顺序持久化:基于分区的分布式日志系统,确保数据按顺序写入磁盘。
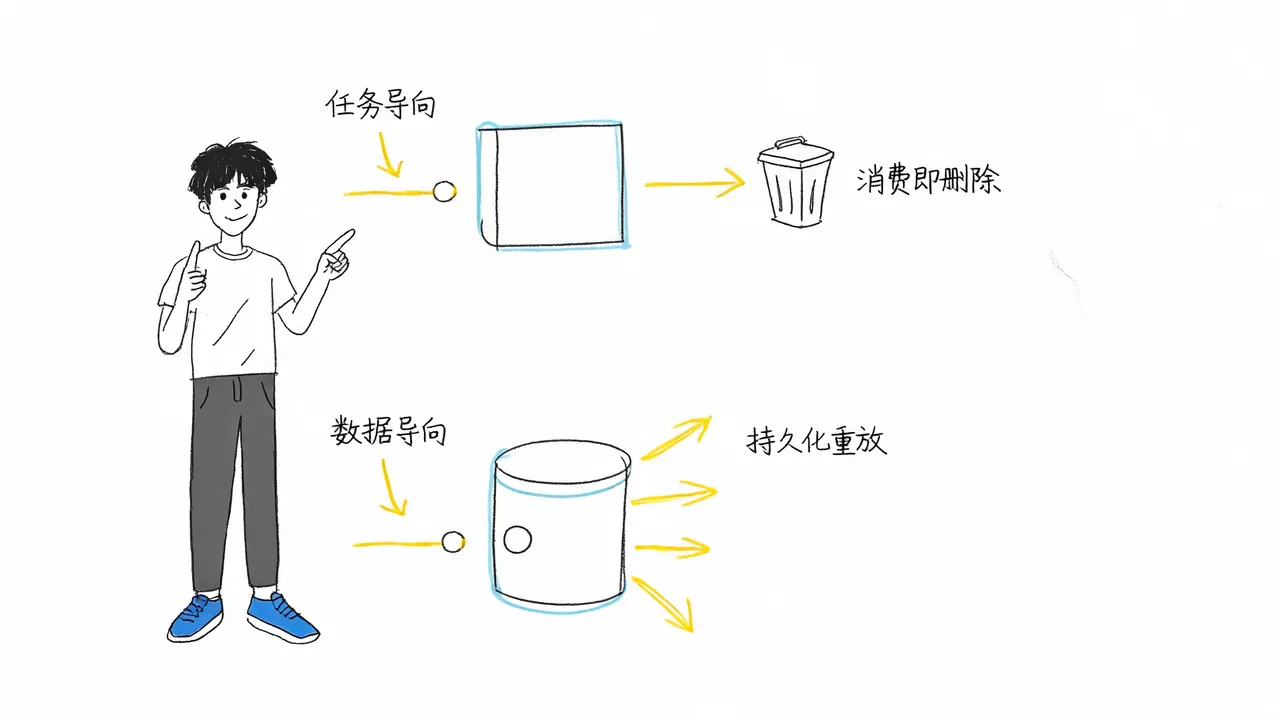
消息生命周期:消费即删除 vs 持久化重放
两者最核心的区别在于消息被消费后的命运,这也决定了它们适用的数据流转逻辑。
RabbitMQ:任务导向
在 RabbitMQ 中,消息的生命周期通常较短:
- 消息被消费者成功处理并确认(ACK)。
- 消息从队列中删除,任务结束。
- 数据不再保留,除非配置了特殊的死信队列或持久化策略。
这种模式适合“一次性”的任务执行,如订单状态流转、异步通知等。
Kafka:数据导向
在 Kafka 中,消息被消费后并不会立刻消失:
- 消息按顺序持久化保存在磁盘上,可保留数天甚至更久。
- 消费者通过记录**偏移量(Offset)**来标记读取进度。
- 数据可以被多个不同的系统独立读取、重放。
这种特性使得 Kafka 成为大数据流处理、日志收集和事件溯源的理想选择,因为它允许下游系统随时回溯历史数据。
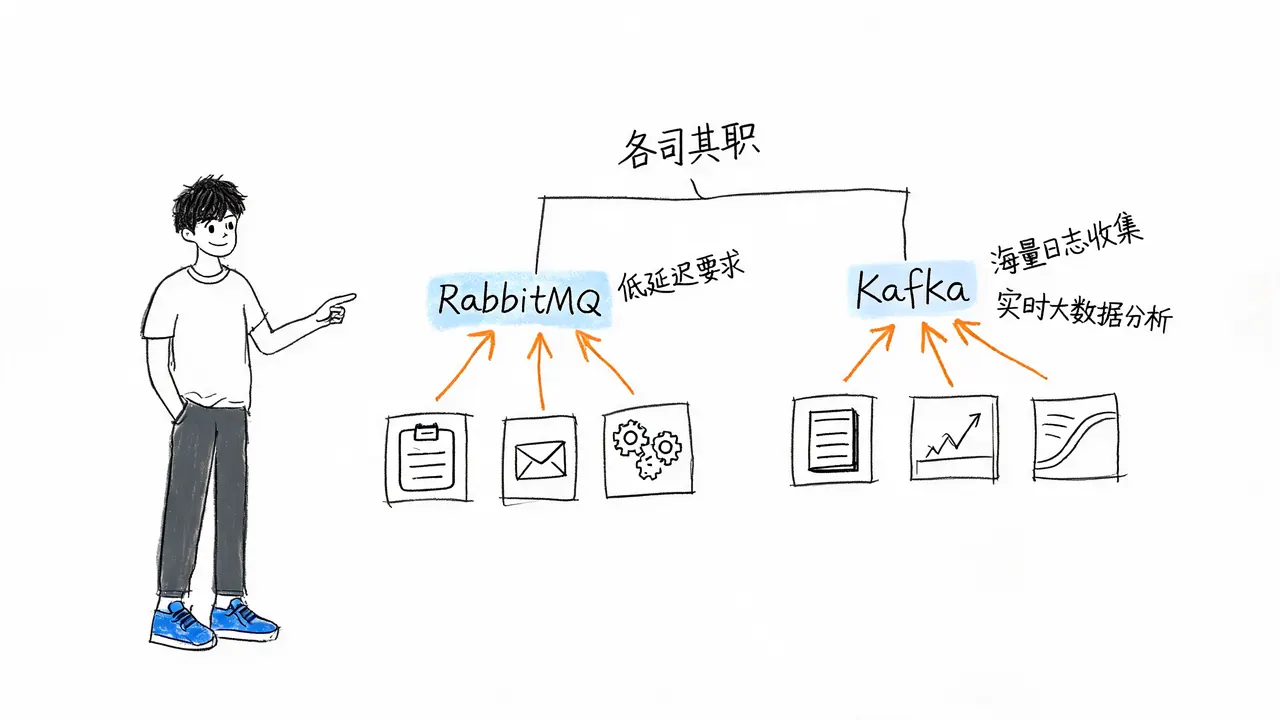
场景选型指南:各司其职
在真实的互联网架构中,Kafka 和 RabbitMQ 往往是互补而非替代关系。强行用 Kafka 实现复杂路由,或用 RabbitMQ 承载海量事件流,都会导致开发、维护和资源成本的增加。
适合使用 RabbitMQ 的场景
- 复杂路由需求:需要根据不同条件将消息分发到不同队列。
- 低延迟要求:如订单支付后的状态通知、用户注册后的短信发送。
- 异步任务解耦:传统的微服务间通信,强调消息的即时投递和处理确认。
适合使用 Kafka 的场景
- 海量日志收集:服务器运行日志、应用监控数据。
- 实时大数据分析:用户行为埋点、实时点击流分析。
- 事件流处理:需要数据重放、多系统独立消费的场景。
结语
技术选型从来没有绝对的“谁比谁更高级”,只有“谁更适合当前的业务”。
- Kafka 赢在:海量数据的记录、分发、持久化和重放能力。
- RabbitMQ 赢在:复杂规则的精准投递、灵活的路由机制和较低的处理延迟。
看懂了它们的设计哲学,也就看懂了分布式系统中数据流转的真正逻辑。在架构设计时,应根据业务对吞吐量、延迟、路由复杂度和数据留存的具体需求,准确判断该将谁放在哪个位置。