别盲目上 Agent:先搞懂业务验收标准,再决定放权边界
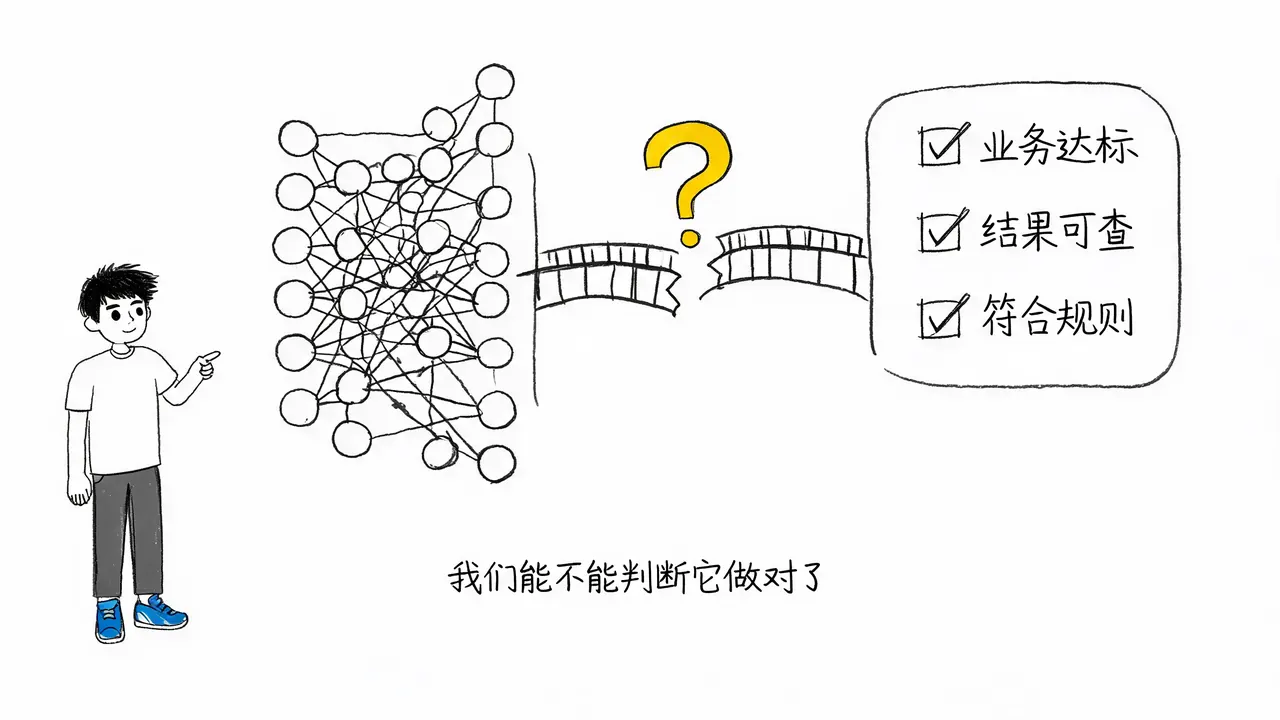
在考虑业务是否接入 AI Agent 时,核心问题往往不是“模型能不能做”,而是“我们能不能判断它做对了”。如果用户的要求仅是一句模糊的“帮我处理好”,且缺乏清晰的完成标准,那么模型自主执行的步骤越多,最终的验收难度反而越大。
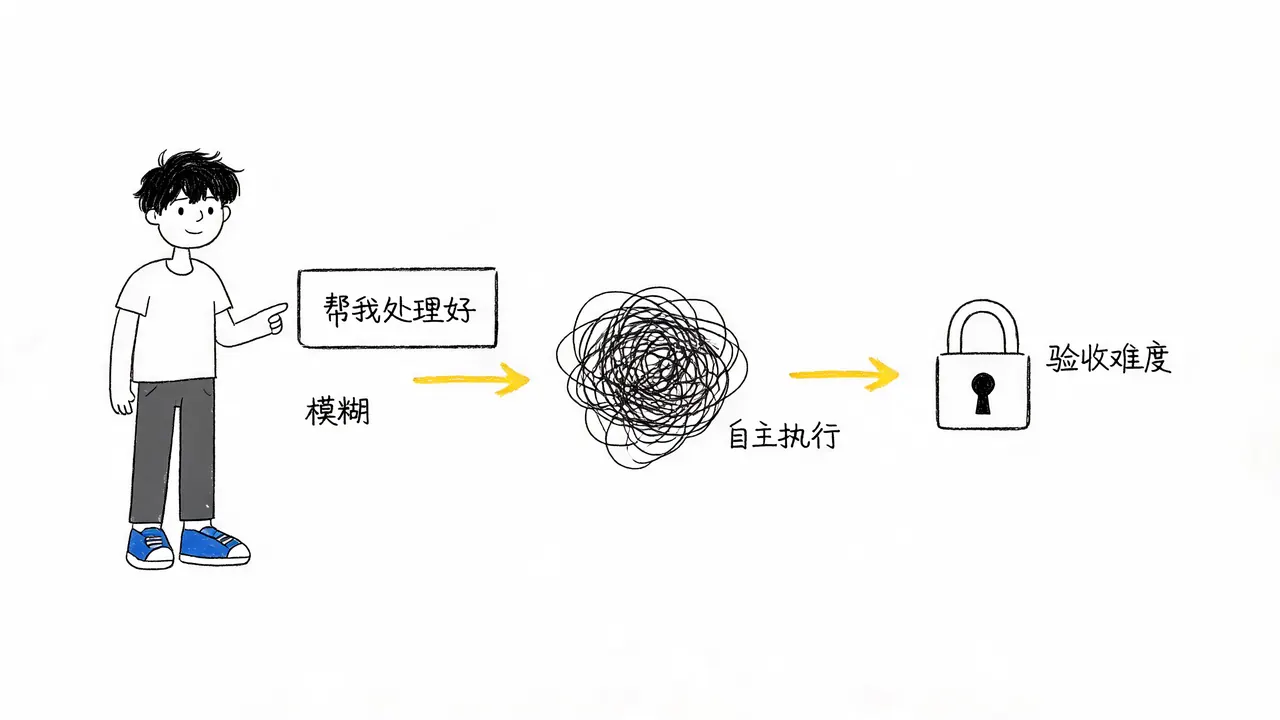
本文将基于验收条件,探讨如何决定哪些步骤可以放权交给模型,哪些步骤必须保留在固定的传统流程中。
第一步:将模糊目标转化为可核对的具体结果
在引入 Agent 之前,首要任务是将用户模糊的目标翻译成能够逐条核对的具体结果。
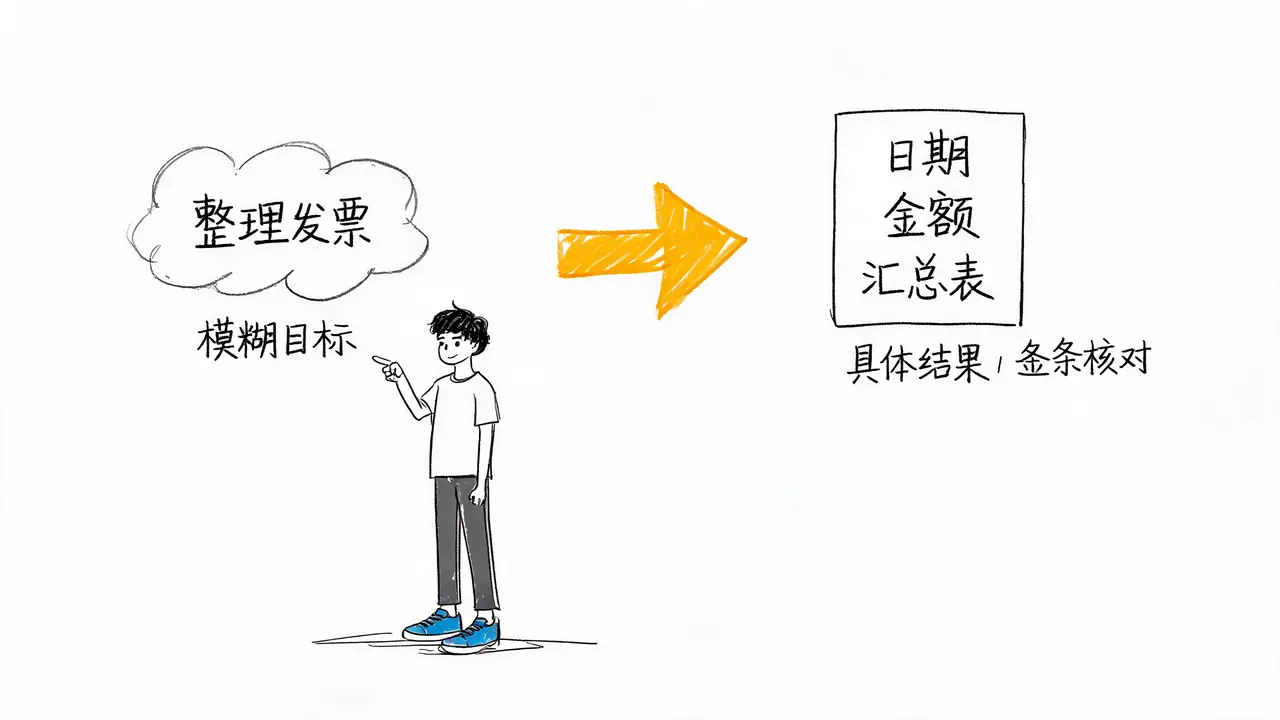
以“整理发票”为例,如果指令仅仅是“帮我把这些发票弄好”,这是无法验收的。具体的要求应当细化为:
- 识别每张发票上的日期和金额。
- 若发现缺失字段,需明确标出。
- 最终生成一张结构化的汇总表。
只有具备了这些具体条目,才能客观评估模型执行的正确性。
同样的逻辑适用于文字处理任务。例如,“写得专业一点”这种要求过于笼统,无法直接验收。此时需要补充具体的风格定义或用途说明,例如:
- 是写给技术人员看的内部文档?
- 还是给客户看的商业报告?
明确目标边界不等于锁死执行步骤。 模型依然拥有发挥空间,但如果缺乏清晰的目标边界,我们在评估系统时,就无法比较不同方案的优劣。
混合架构:模型负责理解,代码负责校验
以发票处理为例,假设业务接收到的发票输入形式多种多样(排版各异),但最终需要的输出结果始终是固定的几个字段。在这种场景下,推荐采用“模型理解 + 代码校验”的混合架构:
- 模型负责理解:让 Agent 负责解析排版各异的内容,提取关键信息。
- 代码负责校验与导出由固定代码完成后续的字段格式校验及表格导出动作。
- 固定逻辑处理异常:如果在代码校验过程中发现缺少关键材料,通过固定的逻辑请求用户补充,而非让模型自由发挥。
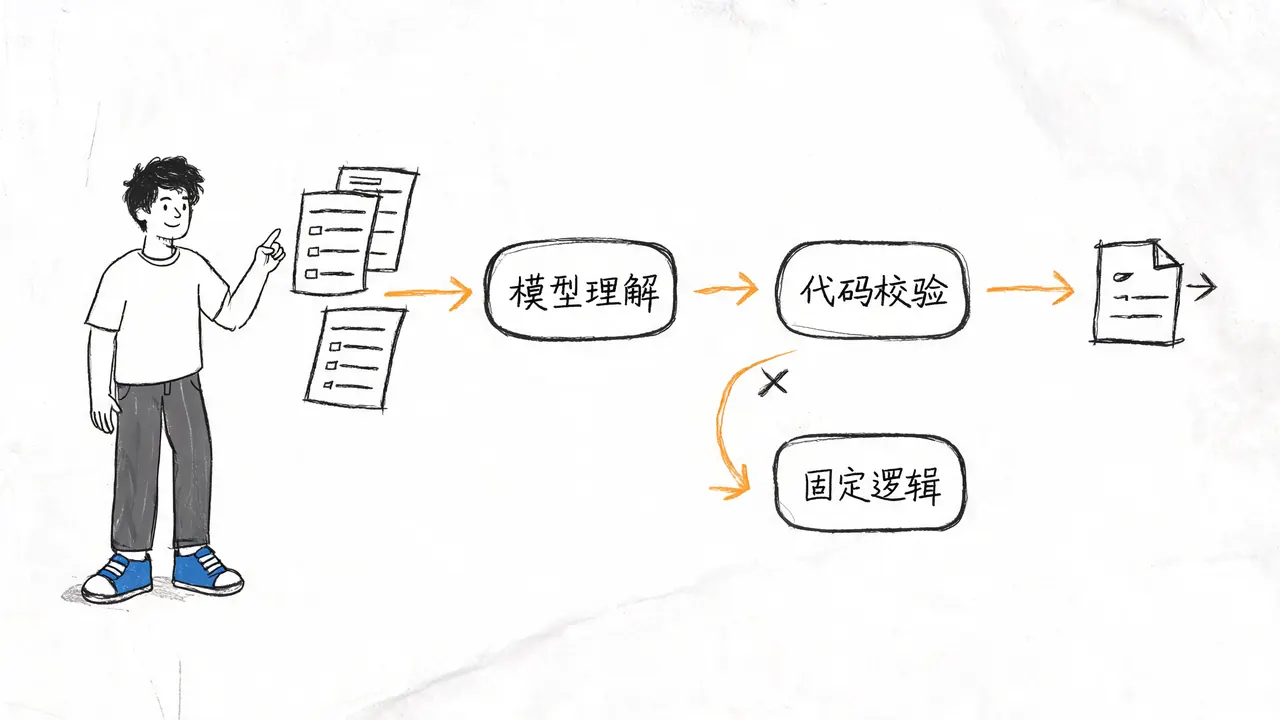
这里需要强调一个关键认知:输入条件的复杂,并不自动意味着要将整个业务流程的决定权都交给模型。
何时让 Agent 自主决策更有价值?
自主决策在以下场景中价值最大:
- 任务需要探索比较陌生的资料。
- 在探索过程中,需要根据新发现的线索动态调整后续的查询方向。
即便是在这种高自主性的场景中,也可以采取“分段控制”的策略:
- 探索阶段:使用 Agent 进行线索探索和动态查询。
- 执行阶段:当模型找出关键信息并经过人工或规则确认无误后,再将其送入业务中固定的审批或执行流程。
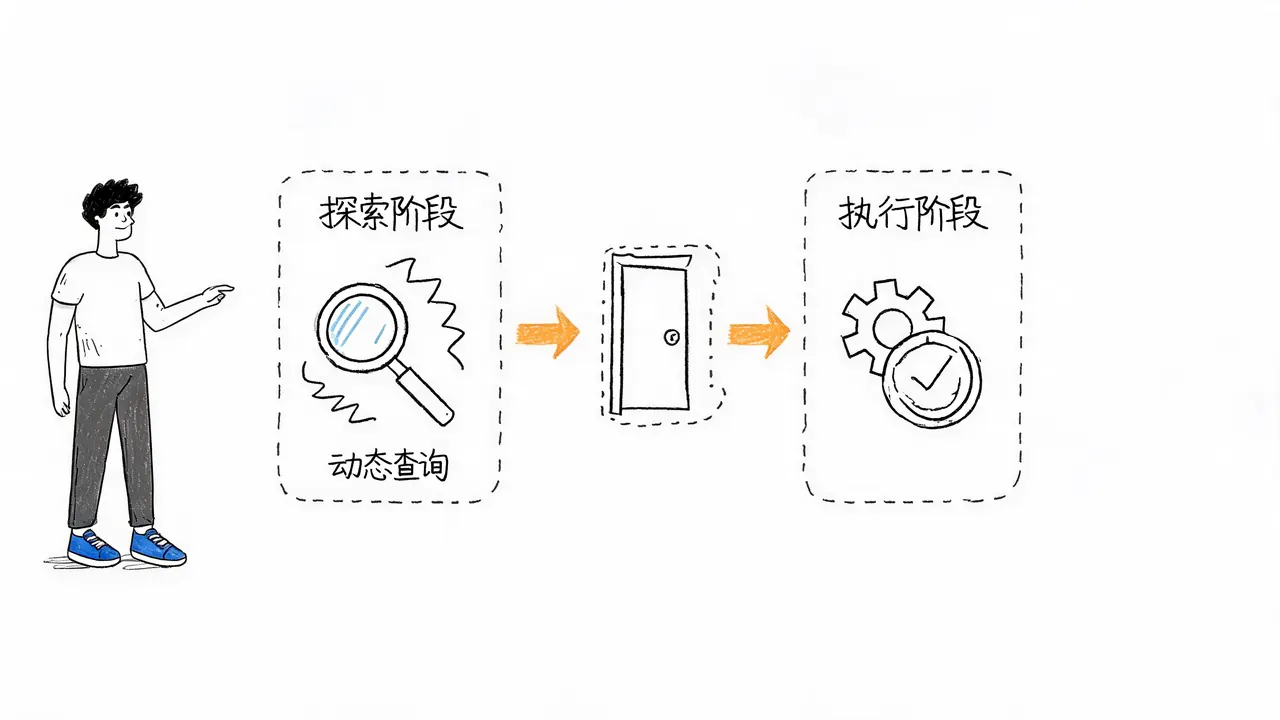
我们拆解的核心在于:识别哪一个环节需要模型进行动态选择,而不是将传统工作流和 Agent 视为互不兼容的两套系统。
技术选型:基于客观数据的对比
在进行技术选型时,建议通过以下步骤进行客观比较:
- 选取代表性任务:选取一组在业务中非常有代表性的任务进行实测。
- 记录关键指标:
- 模型的完成质量。
- 需要人工介入接管的具体原因。
- 总成本(Token 消耗、API 费用等)。
- 系统运行的等待时间(延迟)。
- 方案对比:基于上述客观数据,对比“固定方案”与“动态 Agent 方案”的优劣。
结语
在设计系统时,首要任务是找清楚模型的自主性究竟解决了业务上的哪一个特定问题。
不要仅仅因为当前的框架提供了工具调用能力,就将每一步都交给模型去决定。清晰的验收标准和明确的放权边界,是业务成功落地 AI Agent 的前提。