AI Agent 长期记忆设计:区分临时要求与稳定偏好
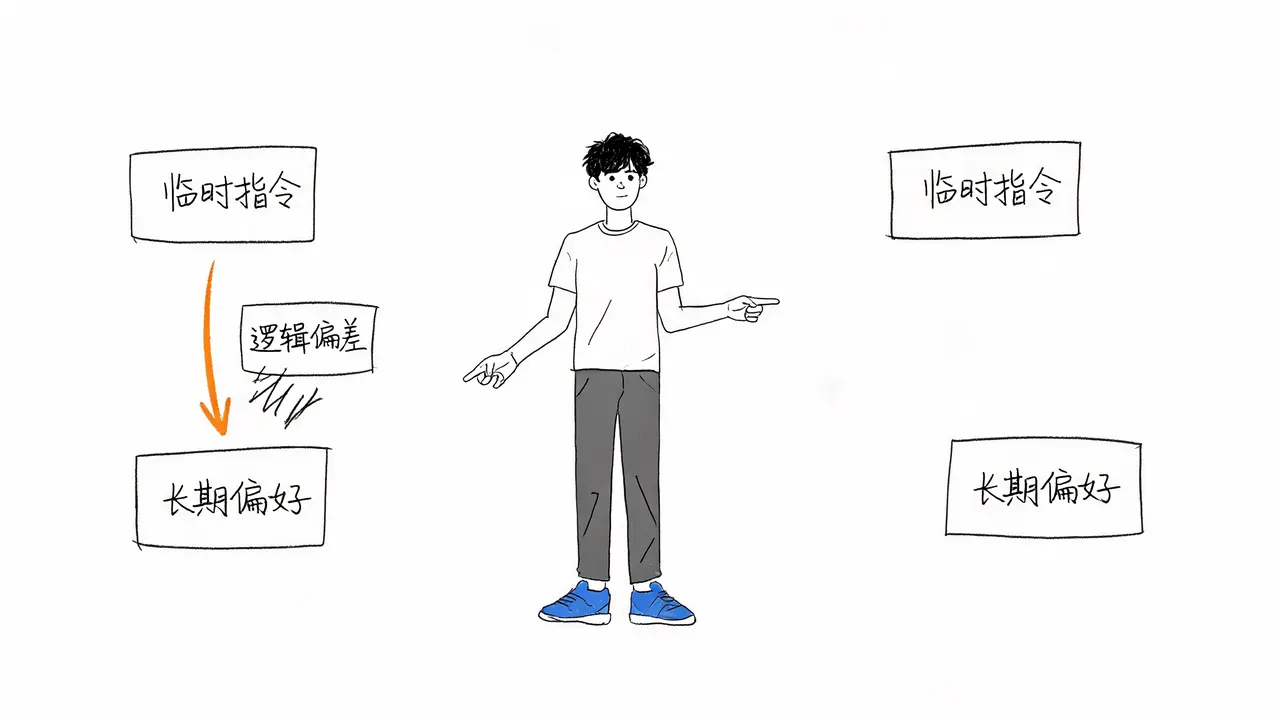
在构建 AI Agent 时,长期记忆(Long-term Memory)常被误认为是一个“万能存储桶”,试图记录用户的所有交互细节。然而,这种“有求必应”的记录策略往往适得其反。当系统错误地将一次性的临时指令(如“这封邮件用英文”)固化为长期偏好(如“以后都用英文”)时,后续不相关的任务极易出现逻辑偏差。
本文旨在厘清长期记忆的核心边界,探讨在信息写入记忆库之前,如何准确判断其来源、适用范围及生命周期,从而构建一个既高效又准确的 Agent 记忆系统。
长期记忆的核心价值与误区
长期记忆的主要作用是**跨会话(Cross-session)**保存那些具备复用价值的信息。它的核心价值在于减少用户重复沟通的成本,让 Agent 能够基于历史上下文提供更个性化的服务。
然而,一个常见的误区是认为“记录得越多,系统就越懂用户”。事实上,具体任务中的临时细节往往不具备长期保留的价值。如果系统不加筛选地抓取关键词并建立粗糙的用户画像,不仅会增加存储负担,更会引入噪声,导致推理错误。
因此,设计长期记忆系统的关键不在于“记什么”,而在于**“什么该记,什么不该记”**。
信息分类:写入前的关键判断
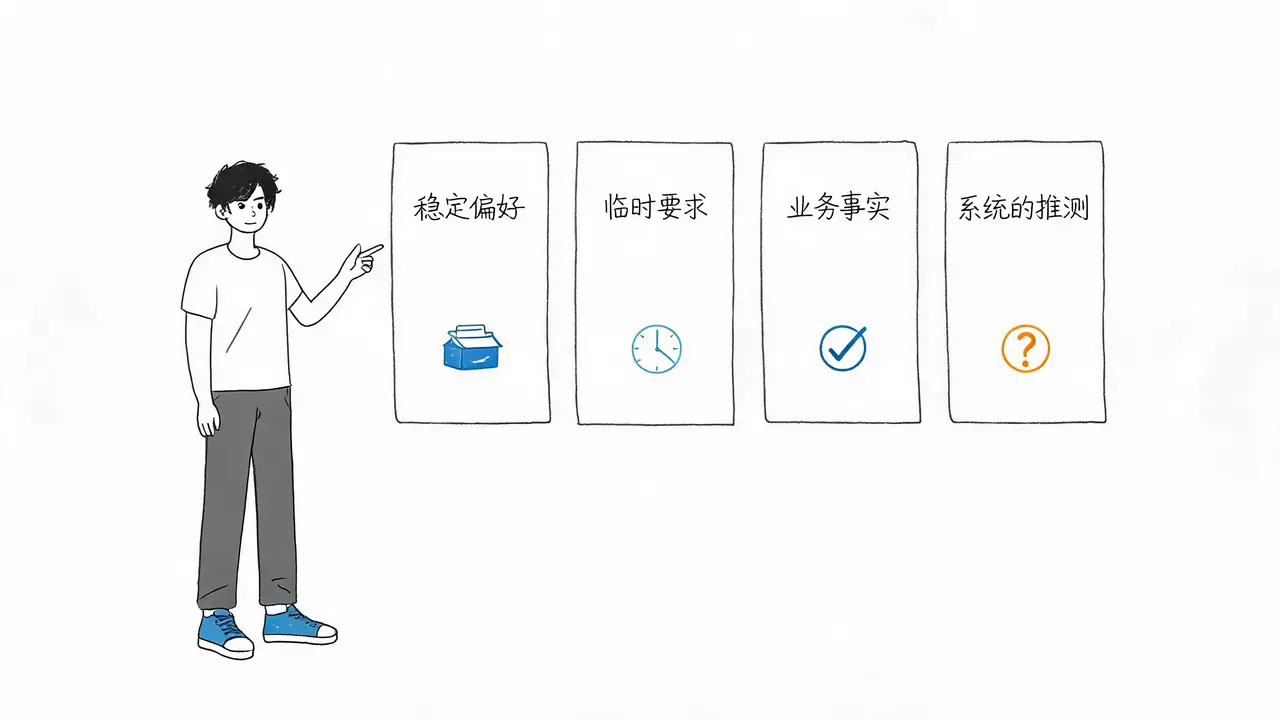
在将任何信息正式写入长期记忆之前,必须明确其来源和适用范围。我们需要将交互信息清晰地划分为以下四类:
- 用户稳定的偏好:用户在多个场景下反复确认或明确声明的长期习惯。
- 示例:“以后代码解释都用中文。”
- 处理:可记录为特定场景下的稳定偏好。
- 当前任务的临时要求:仅针对当前特定任务或上下文有效的指令。
- 示例:“这一封邮件用英文写。”
- 处理:应仅保留在当前任务上下文中,严禁写入长期记忆。
- 客观的业务事实:不随用户意愿改变的外部事实或数据。
- 示例:用户的职位、公司架构、项目截止日期等。
- 处理:需验证时效性后记录,并标记更新时间。
- 系统的推测:Agent 基于有限信息做出的假设。
- 示例:系统猜测用户喜欢简洁的回答风格。
- 处理:应标记为“待确认”状态,而非直接作为事实存储。
核心原则:不能因为系统抓取到一个关键词,就直接建立用户画像。必须区分“一次性指令”与“长期偏好”,避免局部指令错误地传播到完全不相关的任务中。
记忆的生命周期管理
记忆不是静态的,它需要动态的管理机制来保证准确性。
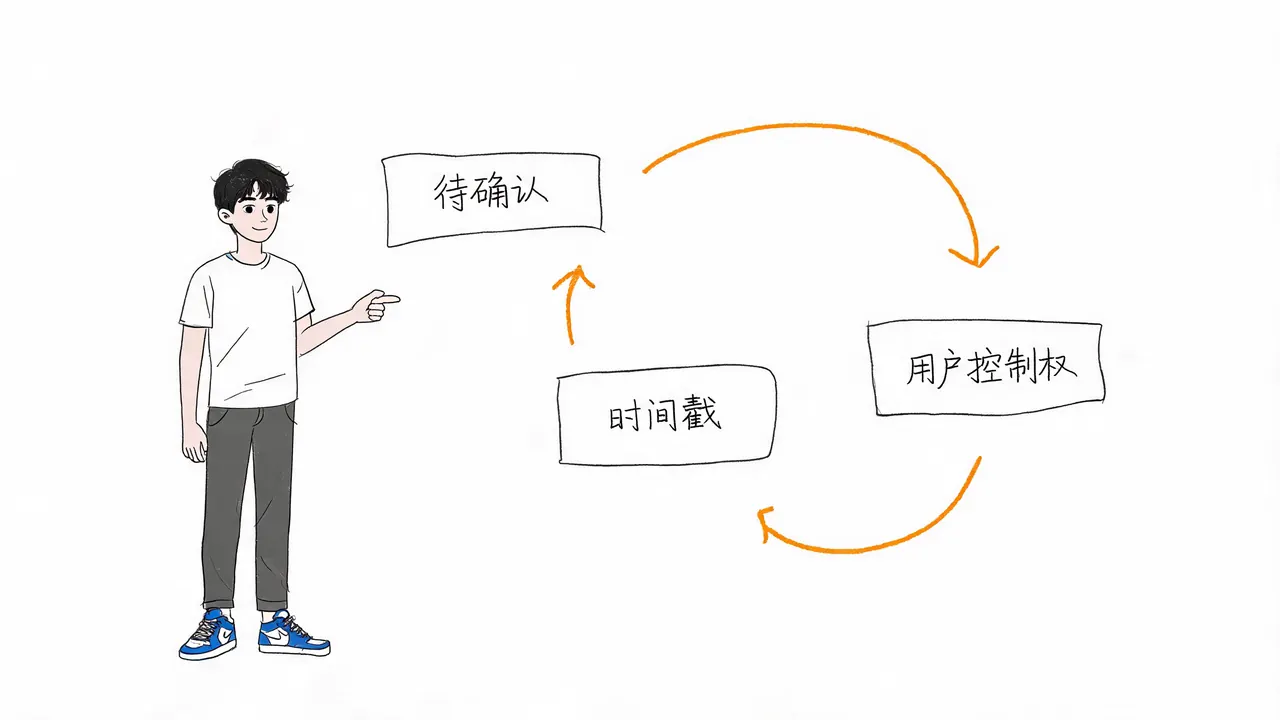
1. 待确认状态与验证机制
当系统遇到不明确的偏好时,不应直接覆盖旧记录,而应将其保留为**“待确认”**状态。
- 策略:等待下次遇到类似场景时,通过用户的反馈进行验证。
- 目的:防止单次误判或临时需求污染长期记忆库。
2. 时间戳与过期清理
记忆系统必须包含更新时间戳。
- 风险:过期的业务信息(如旧的项目截止日期、已离职的联系人)如果不清理,会误导系统后续的动作。
- 对策:建立定期清理机制,对长期未验证或明确过期的信息进行标记或移除。
3. 用户控制权:修改与删除
必须为用户提供明确的修改和删除入口。
- 透明度:用户应能查看 Agent 记住了什么,并有权纠正错误。
- 纠正机制:这是长期记忆系统可靠性的最后防线。当发现记忆错误时,用户应能轻松修正,系统应能即时同步更新。
敏感信息的删除规范
涉及敏感信息时,不能因为“方便”而无限期存储。这里的“删除”有着严格的技术定义,绝不仅仅是前端界面的隐藏。
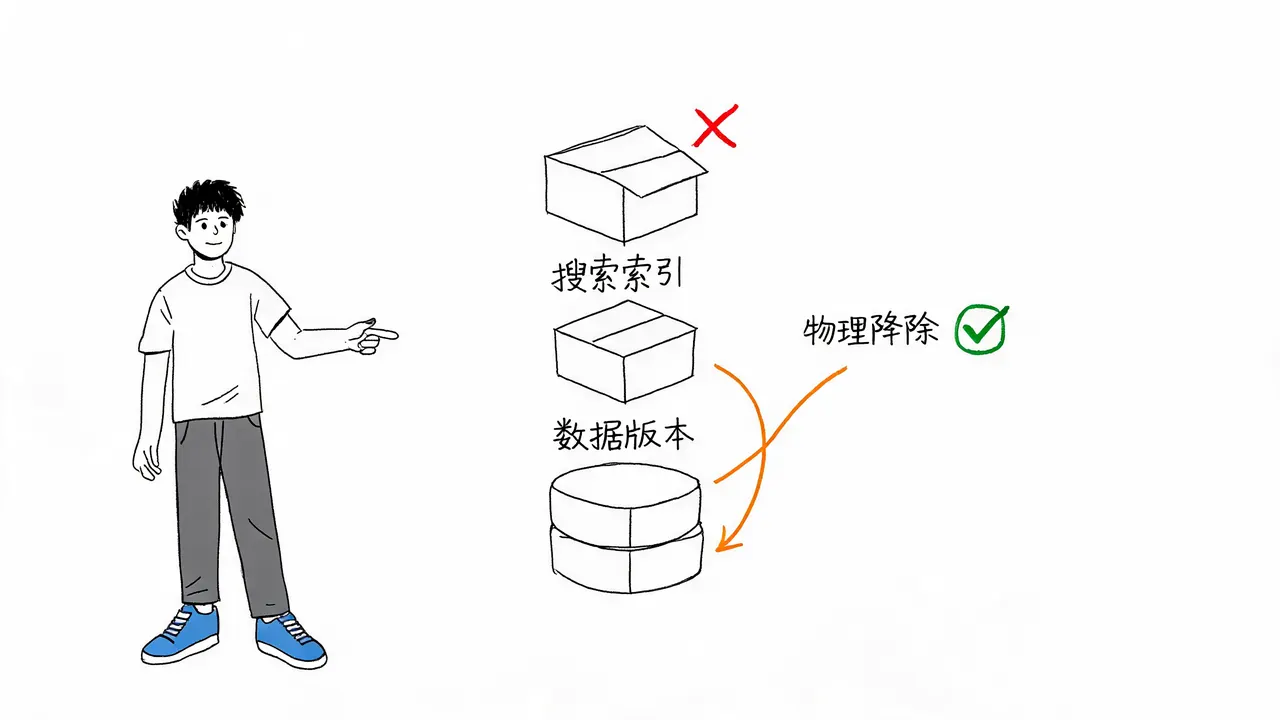
真正的删除必须严格遵循底层存储规范,涵盖以下层面:
- 实际存储:从数据库或向量数据库中物理移除数据。
- 搜索索引:从全文搜索或向量索引中移除对应条目,确保无法被检索到。
- 数据副本:清理所有备份、缓存或日志中的副本。
- 保留政策:符合适用的数据保留政策(如 GDPR 等合规要求)。
仅在前端隐藏数据而不进行底层清理,存在严重的数据泄露风险,不符合安全标准。
测试策略:验证记忆隔离性
在系统测试阶段,应专门设计用例来验证记忆的隔离性和准确性。
测试方法: 故意给出不同场景下比较相似的要求,观察系统是否会错误地传播指令。
- 场景 A:用户要求“写一封英文邮件”。
- 场景 B:随后用户要求“写一段 Python 代码注释”。
- 预期结果:代码注释应使用默认语言(如中文或代码规范语言),而不是因为之前的邮件要求而自动切换为英文。
如果系统出现跨场景的错误传播,说明记忆的范围划分或上下文隔离机制存在缺陷,需要立即修复。
结语
AI Agent 的长期记忆能带来显著的核心收益——减少重复沟通,提升交互效率。但这有一个大前提:记忆的范围必须划对,且具备完善的纠正机制。
记住的数据越多,并不自然代表系统就更懂用户。相反,错误的记忆会累积成系统性的偏差。因此,在设计 Agent 记忆系统时,严谨的信息分类、动态的生命周期管理以及严格的删除规范,比单纯的存储容量扩展更为重要。