拆开内核:为什么这些办公AI长得一模一样
近期流传着一个观点:现在的办公Agent(智能体)本质上就是AI编程工具换了一层外壳。在查阅了多家主流厂商的官方架构文档后,这一说法在架构层面完全成立,但在产品层面仅对了一半。
要厘清这一概念,首先需要区分“大模型”与“Agent”的本质差异。
从文本预测到动作执行
单独的大模型本质上是一个文本预测器。你输入一段话,它输出下一段话,其核心产出是文字和符号。
而Agent提供的是实际动作。它不仅仅是告诉你“该整理文件夹”,而是真的动手把文件夹整理好。
从“输出文字”跨越到“执行动作”,依靠的并非模型突然变聪明,而是引入了三个关键要素:
- 工具(Tools)
- 执行循环(Execution Loop)
- 可操作的环境(Environment)
所有此类办公Agent产品的核心,都遵循同一个四步循环。一旦这个循环启动,Agent便开始工作。
核心机制:四步执行循环
无论厂商如何包装,其底层运行逻辑几乎一致,均包含以下四个步骤:
- 工具清单注入:系统向模型提供一份工具清单,告知其可以读写文件、打开浏览器或运行命令。
- 决策与参数生成:模型理解用户要求,决定使用哪个工具,并生成所需的参数。
- 外部程序执行:模型外部的程序接收指令,真正去执行操作。注意:实际动手的不是模型,而是外部程序。
- 结果反馈与迭代:程序将执行结果交回给模型,模型评估结果后决定下一步行动,随后回到第2步继续循环,直到任务完成。
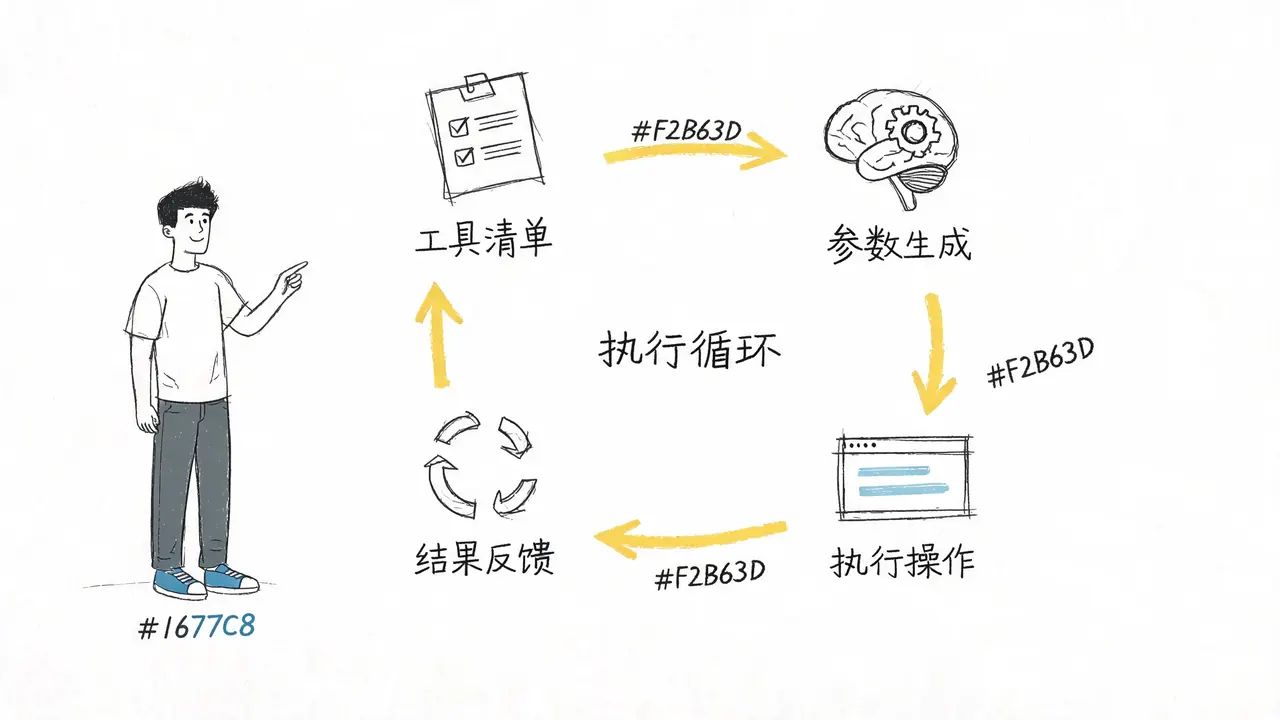
这里有一个常被混淆的关键点:模型本身并不直接执行动作,它只负责决策。真正执行动作的,始终是模型外围的那套程序框架。
为什么底层连接的是编程工具?
既然模型只负责决策,为什么办公Agent底层往往连接的是编程工具,而不是一个更强的聊天模型?
因为真正干活的能力,不仅来自模型,更来自整套组合。
- 聊天模型:只能生成文字。
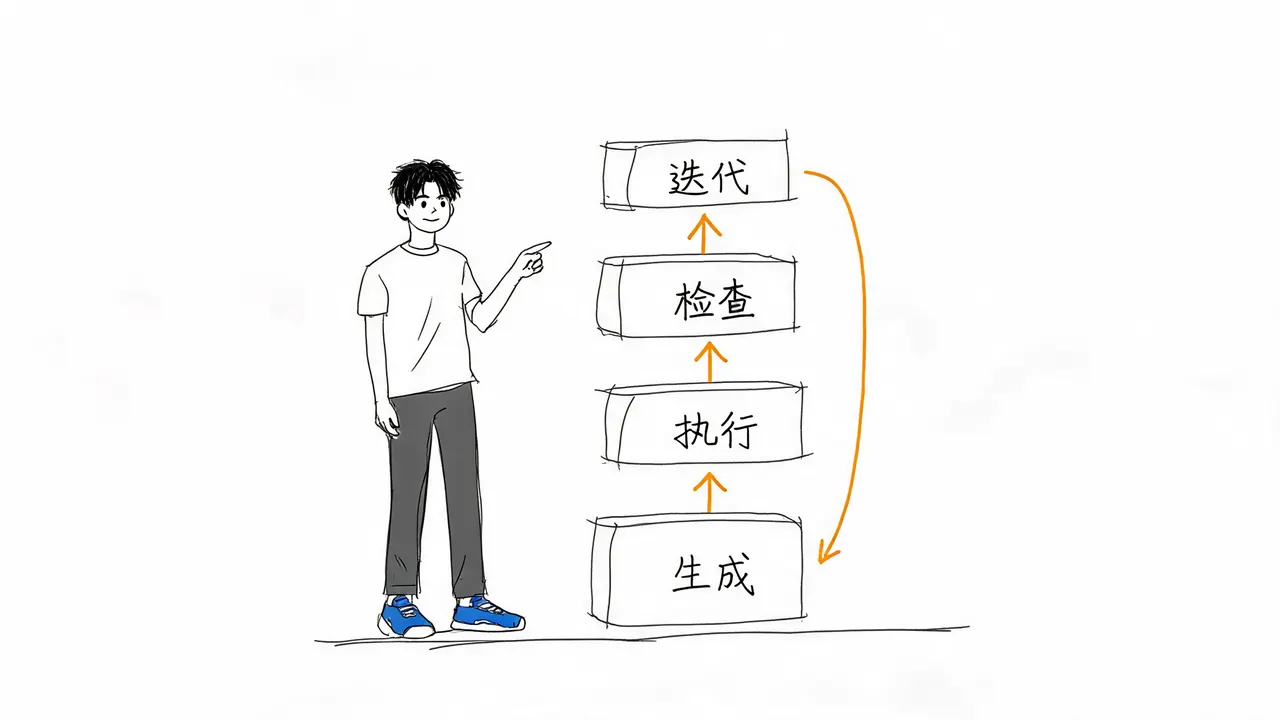
- 编程工具:天然具备生成可运行内容、实际运行、检查结果以及迭代修改的能力。
生成 -> 执行 -> 检查 -> 迭代,这四步是编程工具在代码世界中训练多年的基本功,恰好也是将一件事情真正办成的完整过程。
官方文档的“不约而同”
这一推断并非孤例。翻看各家官方文档,会发现一个有趣的现象:不同厂商对产品的描述几乎一模一样。
- 有的厂商将其称为:感知、规划、执行、交付。
- 有的厂商描述为:先想一步,再做一步,看完结果后再思考下一步。
- 有的厂商明确写道:产品会生成脚本来处理数据。
- 甚至有一家厂商直言:其办公产品和编程产品共用同一套核心能力,只是外层交互面对的用户不同。
不同厂商不可能事先商量好文档怎么写。大家不约而同地用同一套逻辑描述产品,通常只有一个解释:这不是谁在模仿谁,而是实现这类产品本来就要走同一条路。
具体场景下的“通用中间语言”
为了更直观地理解,我们来看几个具体例子:
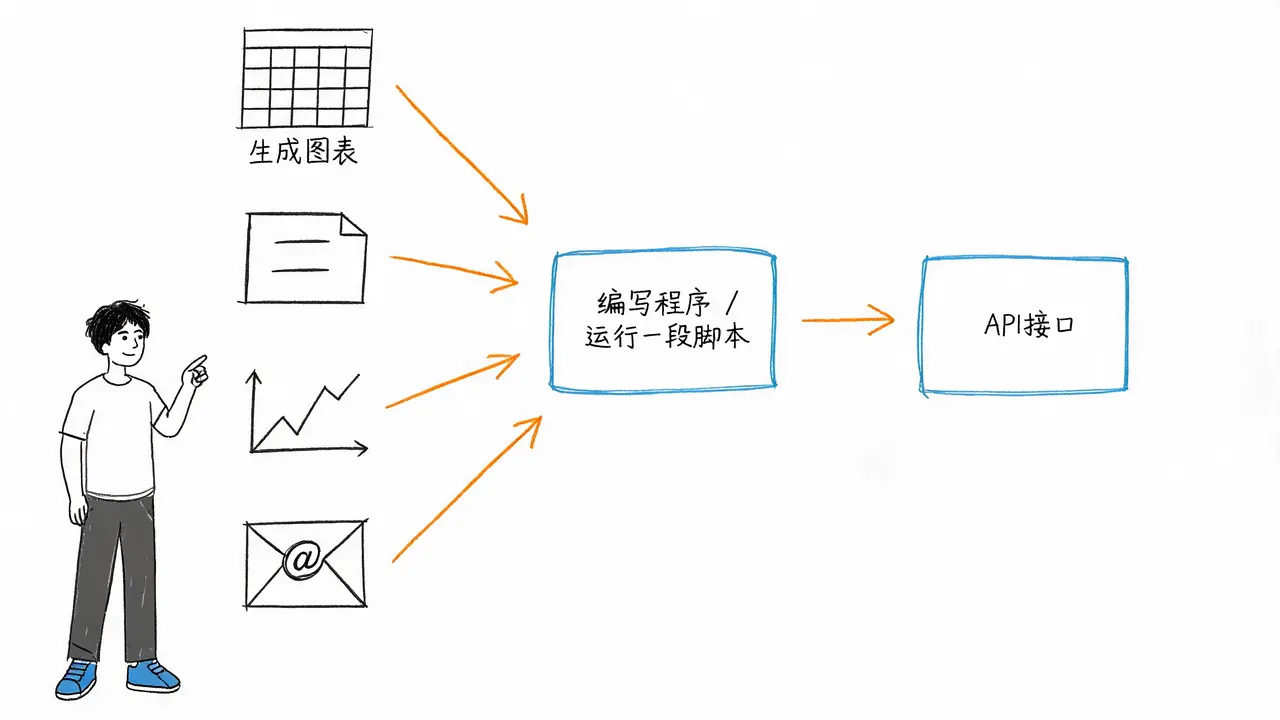
- 整理几千行数据的表格:Agent会在背后编写程序统一处理数据,而不是逐个修改单元格。
- 批量修改文件名:Agent会运行一段脚本。
- 制作带图表的报告:Agent会用代码生成图表。
- 查看日程或发送邮件:Agent会调用软件开放的API接口。
- 无接口软件操作:如果软件没有开放接口,Agent会退回最直接的办法——像人一样操作屏幕。
你会发现,各种办公任务到了底层,几乎都被翻译成了同一种东西。因此,编程正在成为AI操作数字世界的通用中间语言。
架构相同,产品不同
既然内核相同,那么“办公Agent就是编程工具换皮”这个说法对吗?
从架构上看,是的;从产品上看,只对了一半。
打个比方:现在的汽车内部到处都是软件,一辆车运行的代码甚至比很多互联网产品还多,但我们不会把汽车叫做“编程工具”。因为用户买的不是这些代码,而是从家到公司的这段路程。
办公Agent也是一样。用户真正需要的,不是它在后台写出的程序,而是最终完成的那张报表。
更准确的说法是:这些产品把编程工具的执行引擎,包装成了普通人也能使用的工作平台。底层引擎相同,但外面的产品形态却完全不同。
既然内核相同,这些产品真正的差别又在哪里?下一集,我们将探讨最关键的分界线:权限。