Agent 循环设计:如何精准区分有效等待与系统卡死
在构建基于大模型的 Agent 系统时,一个常见的困惑是:当 Agent Loop(代理循环)在某一轮迭代中没有产生新的业务数据或文本输出时,是否应该立即终止循环?
答案是否定的。后台任务可能仍在正常运行,此时“等待”与“卡死”是两种截然不同的状态。盲目地因为缺乏新输出而中断循环,可能会导致任务失败;而无限期地等待,又可能陷入死循环。本文将详细阐述如何在运行循环中准确区分“有理由的等待”与“无效的重选”,并给出相应的处理策略。
``核心机制:反馈驱动的动作选择
Agent 循环的核心机制在于根据反馈来选择下一步要执行的动作。
当系统发现没有拿到新的业务数据时,开发者往往容易陷入误区,直接判定为系统故障。实际上,这种情况需要分场景看待:
- 无效进展(原地打转):搜索或工具调用确实没有取得实质性进展,模型在重复相同的无效操作。
- 有效等待(外部依赖):外部任务(如 API 调用、文件处理)尚未执行结束,系统正在等待异步结果。
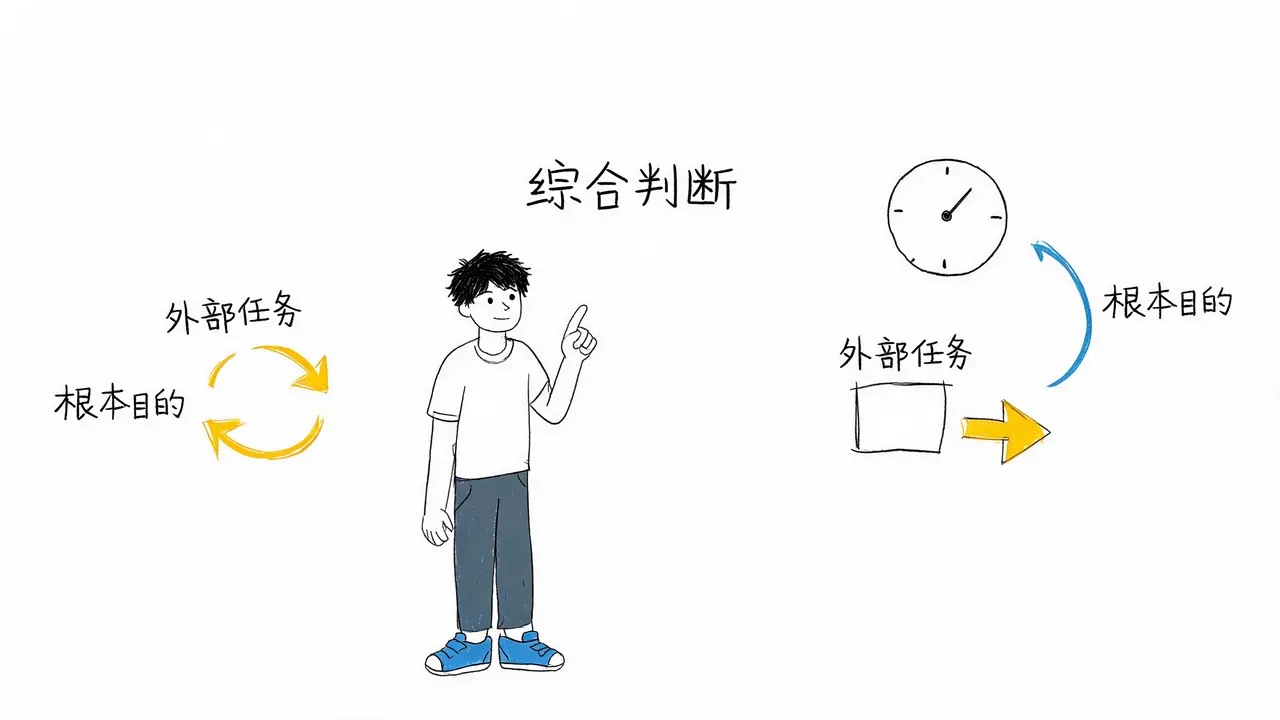
因此,判断系统是否向前推进,不能简单粗暴地只看大模型是否输出了新内容。我们需要结合外部任务当前的实际状态以及这一轮动作的根本目的来进行综合判断。
典型场景:异步任务的状态追踪
为了更清晰地理解这一区别,我们可以假设一个常见的场景:文件转换请求。
场景描述
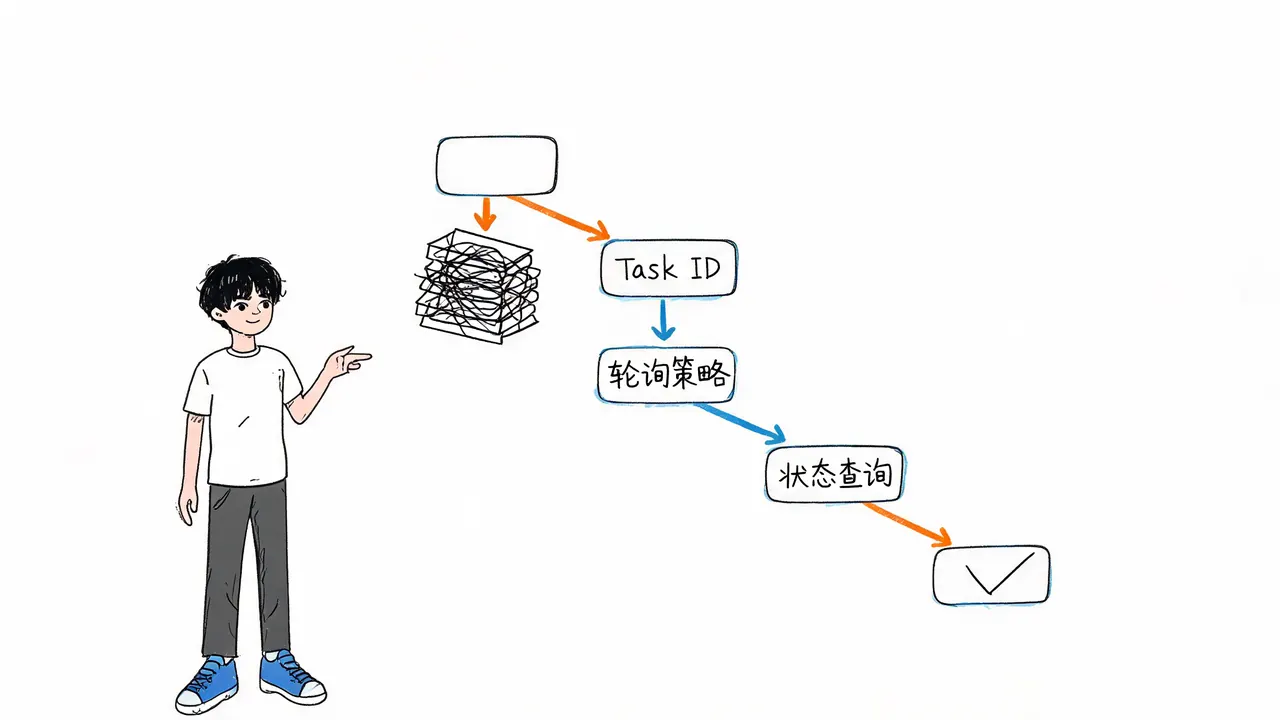
系统向第三方服务发起了一个文件转换请求。对方接口成功返回了一个任务编号(Task ID),但平台状态依然显示为“处理中(Processing)”。
错误做法
此时,如果 Agent 仅仅因为没看到最终结果就重新发起一个一模一样的转换任务,这是错误的。
- 后果:重新提交未必能加快处理速度,反而会给系统造成无意义的重复工作,甚至导致资源浪费或数据冲突。
正确做法
系统应按照第三方服务建议的轮询策略(Polling Strategy),结合自己设定的剩余期限,进行安静地等待或定期发起状态查询。
在这个环节中,系统最关键的动作是:妥善保留任务标识(Task ID),作为后续追踪的凭证。
有效等待的边界设定
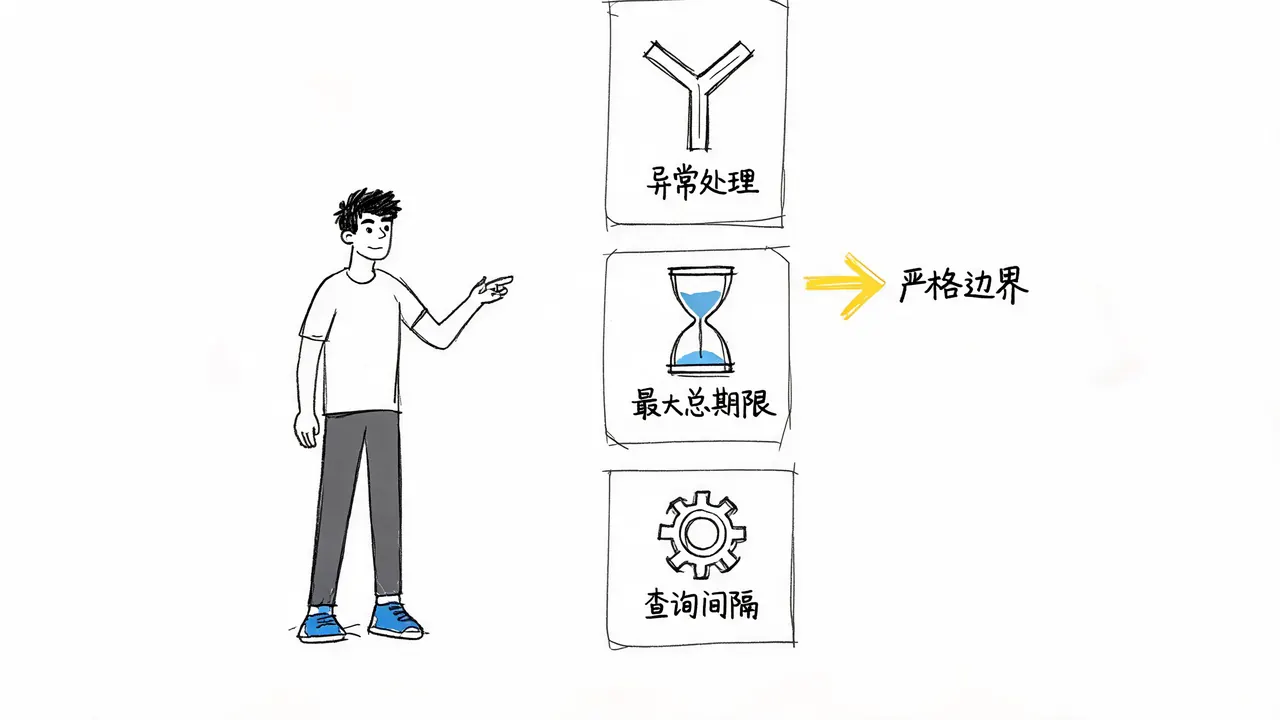
“有理由的等待”并非无限期等待,它必须拥有严格的边界。在设计循环逻辑时,必须提前规划好以下三个维度:
- 查询间隔时间:避免高频轮询对系统造成压力,设定合理的
sleep或重试间隔。 - 最大总期限(Timeout):设定整个任务允许的最长等待时间。
- 异常处理路径:规划当出现超时、接口报错等异常状态时,系统应走哪条处理分支。
超时后的处理原则
如果在规定的时间里一直无法确认最终状态,系统应当:
- 如实报告:向外报告“尚未确认”或“超时”,而不是强行结束。
- 保留入口:保留一个后续可以核对的入口(如返回 Task ID),允许用户或上层系统稍后再次查询。
切记:
- 不是只要手里有个任务编号,就能毫无节制地无限等下去。
- 更不能为了强行结束循环,将这种“还在等待”的状态错误地标记为“已完成”。
测试策略:覆盖典型分支
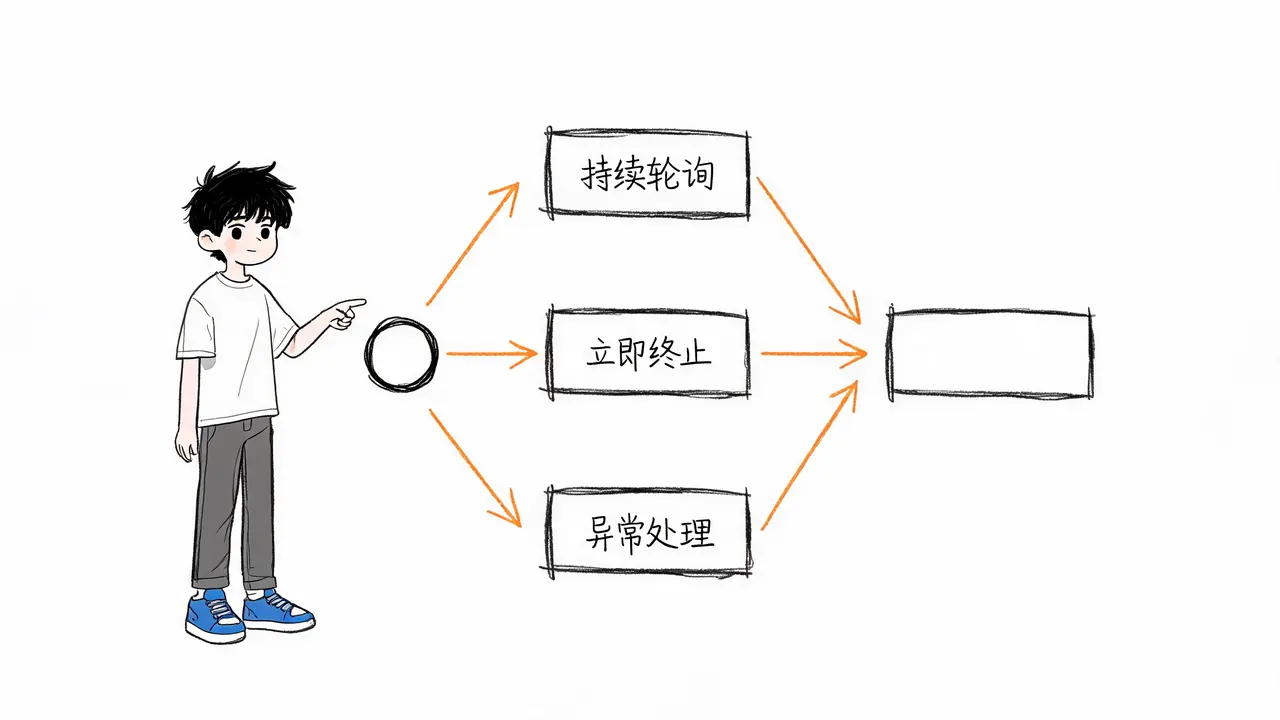
在系统测试阶段,我们需要有意识地覆盖几种典型的分支场景,以验证系统在不同状态下的行为是否正确:
| 测试场景 | 预期系统行为 |
|---|---|
| 正常的长耗时慢任务 | 系统应持续轮询,直到获取最终结果或达到超时上限,期间不重复发起任务。 |
| 明确返回失败结果的任务 | 系统应立即终止等待,记录错误日志,并返回失败状态。 |
| 状态查询接口不可用 | 系统应进入异常处理路径,可能包括重试查询接口或上报系统错误,而非静默失败。 |
通过仔细检查系统在面对这几种不同情况时是否采取了对应的不同动作,可以确保 Agent Loop 的健壮性。
总结:从“限制轮数”到“状态感知”
Agent Loop 设计的关键,从来就不只是简单地限制“它最多跑多少轮”。
真正的设计目标是让系统清楚地知道:
- 自己当前到底是在推进?
- 还是在等待?
- 或者被阻塞住了?
并且,要让每一次循环终止的原因都能够被清晰地解释。只有实现了这种状态感知,Agent 系统才能在复杂的外部依赖环境中稳定、可靠地运行。