Kafka 是什么?揭秘互联网巨头的“中央数据总线”
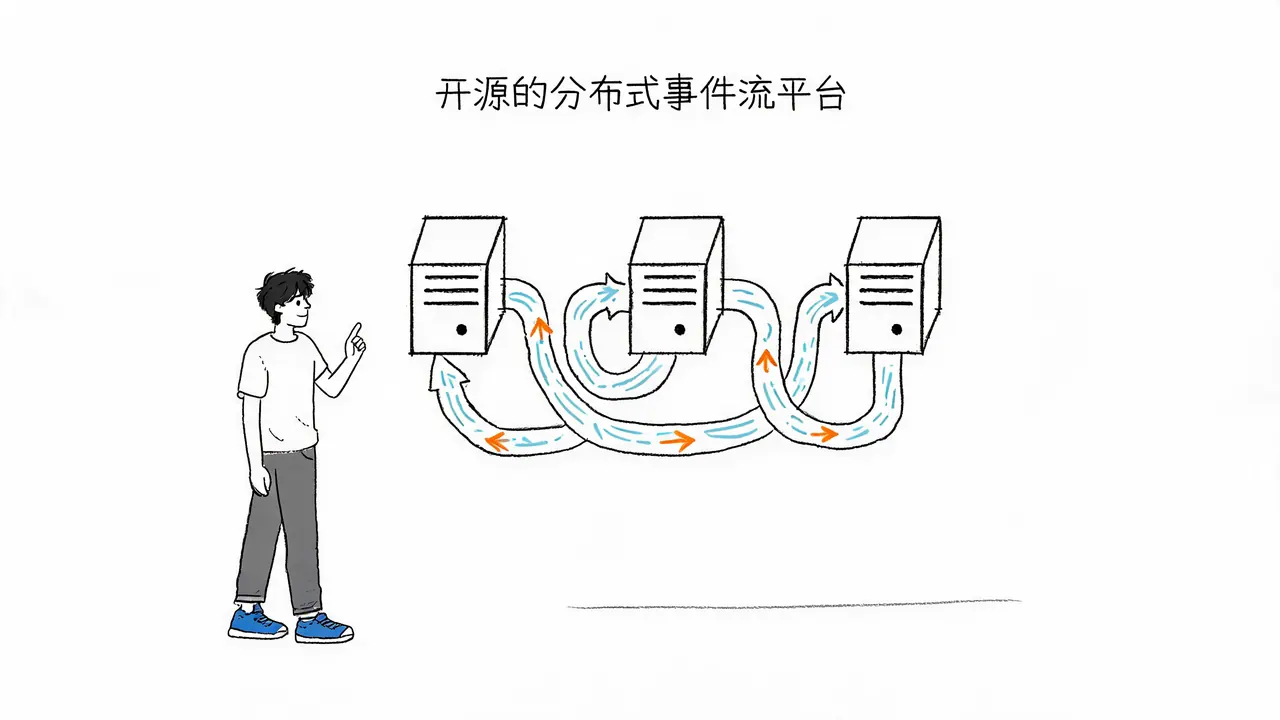
Kafka 究竟为何成为阿里、字节、美团、腾讯等互联网巨头的标配?它解决了什么核心痛点?简单来说,Kafka 是一个性能极其强悍、支持横向扩展、专门用于处理海量实时数据的“中央数据总线”或“信息高速公路”。本文将带你拆解 Kafka 的核心角色、高性能背后的技术原理以及其在实际业务中的关键应用。
`` 是摘要与正文的分隔标记,请保留。从“双十一”抢购看 Kafka 的价值
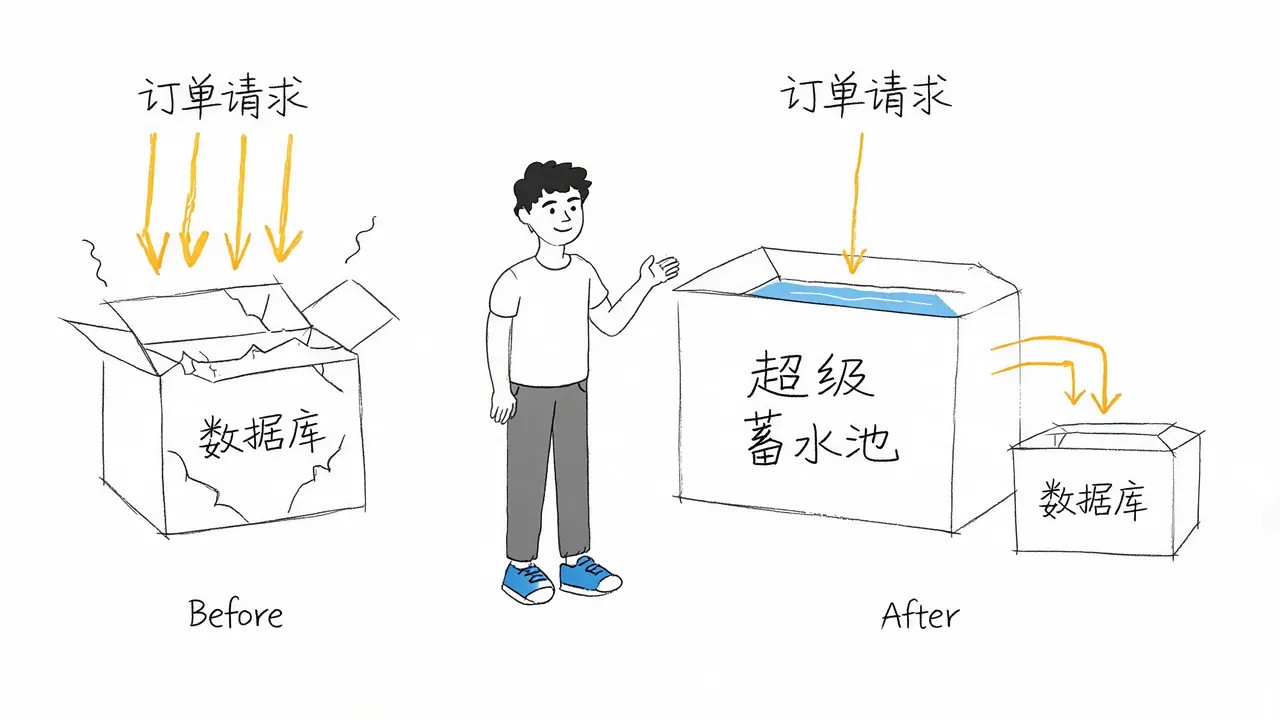
想象一下“双十一”零点抢购的场景:几亿用户同时点击提交订单,海量请求如洪水般涌向服务器。如果让这些请求直接操作数据库,数据库瞬间就会崩溃。
为了解决这个问题,聪明的架构师在用户和数据库之间增加了一个“超级蓄水池”。所有订单请求先进入这个池子排队,数据库再按照自身的处理能力,有序地从池中取出订单进行处理。这样既保护了数据库不被冲垮,也确保了订单数据不丢失。
这个“超级蓄水池”在技术世界中最典型的代表,就是 Kafka。
为什么需要 Kafka?
在 Kafka 出现之前,系统间的数据传递主要面临两种困境:
- 直接调用:一旦下游系统宕机或处理缓慢,上游系统会被直接拖累,甚至导致整个系统瘫痪。此外,系统间强耦合,修改一处可能引发连锁反应。
- 传统消息队列:虽然能实现解耦,但性能往往难以满足每秒几十万条消息的海量并发场景。
Kafka 的诞生正是为了填补这一空白:它既能解耦系统,又能扛住超高并发,支持数据持久化存储,确保消息不丢失,并允许重复消费。
什么是 Kafka?
官方定义 Kafka 为“开源的分布式事件流平台”。通俗来说,它具备三个关键特征:
- 消息队列:像蓄水池一样缓存海量数据,起到削峰填谷、解耦系统的作用。
- 分布式系统:由多台服务器组成的集群共同工作,具备极高的数据吞吐量和容错能力。
- 流平台:不仅能存储数据,还能对持续流入的数据进行实时处理和分析。
Kafka 的核心角色
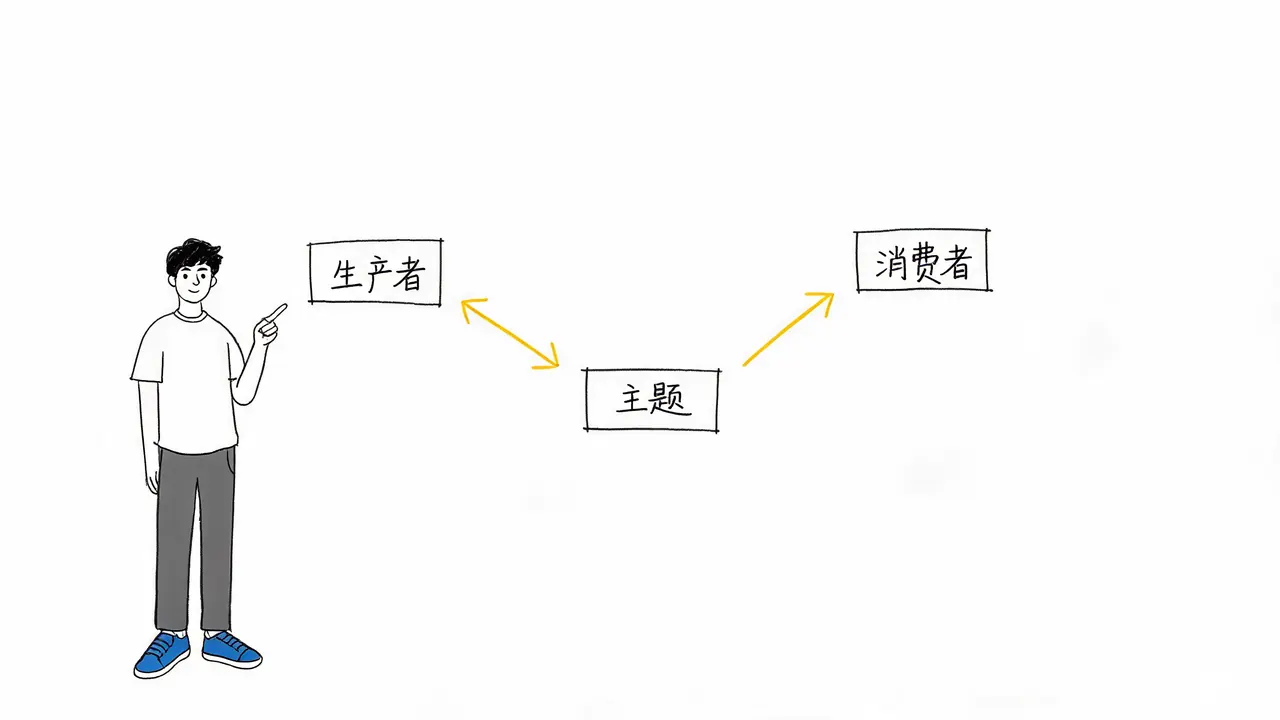
要理解 Kafka 的工作机制,需要认识以下三个核心角色:
1. 生产者 (Producer)
数据的源头。例如,当你在外卖 APP 上下单时,APP 就是生产者,负责将订单数据发送到 Kafka 这条“传送带”上。
2. 消费者 (Consumer)
数据的处理者。例如,外卖平台的订单管理系统、骑手派单系统等,它们从 Kafka 中读取数据并进行相应处理(如商家接单、骑手取餐)。
3. 主题 (Topic)
数据的分类货架。不同类型的数据存放在不同的 Topic 中。例如,订单数据放入“订单主题”,用户评价数据放入“评价主题”。这种分类机制让消费者能精准获取所需数据,避免在海量数据中盲目翻找。
Kafka 为何如此快?
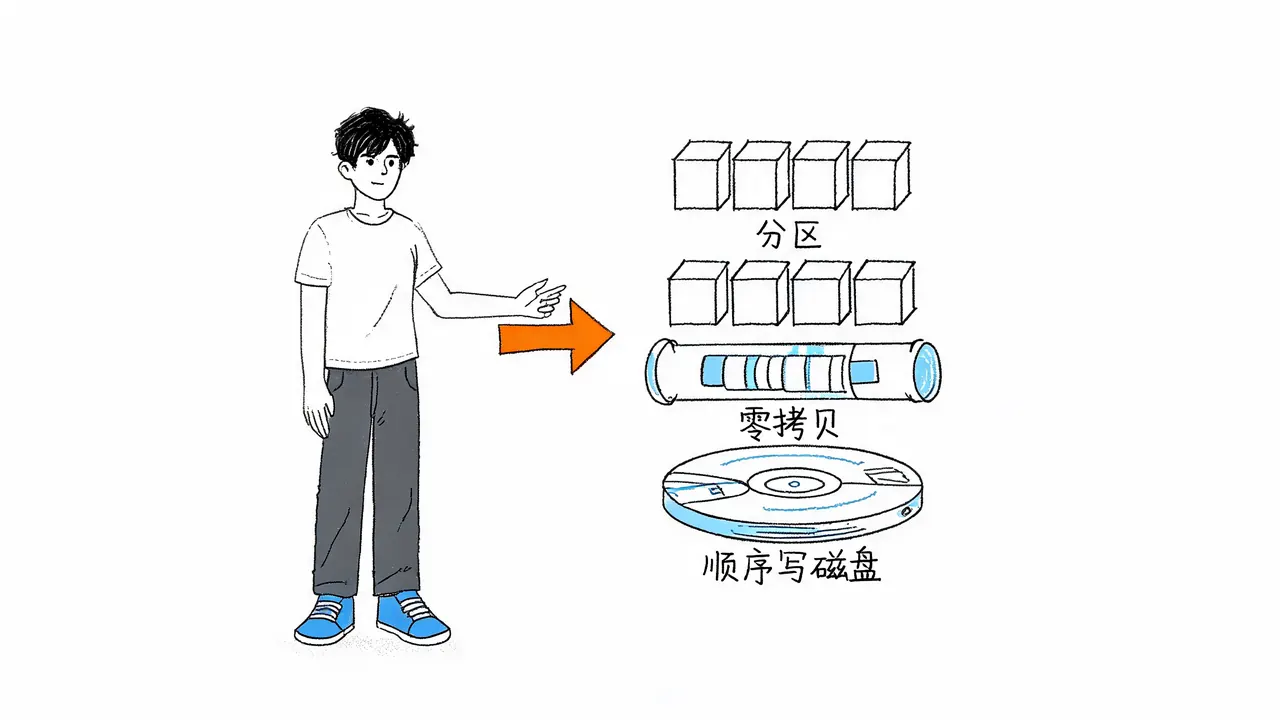
Kafka 的吞吐量可达每秒数百万条消息,其高性能主要得益于以下四点技术设计:
- 顺序写磁盘:Kafka 的消息写入是顺序进行的,类似于往笔记本一页页书写。现代硬盘的顺序写速度甚至优于随机写内存。
- 零拷贝 (Zero Copy):在发送数据时,Kafka 无需在内存中多次拷贝数据,而是直接将文件从磁盘通过网卡发送,极大减少了 CPU 开销。
- 分区 (Partition):当单个队列无法处理海量数据时,Kafka 会将一个 Topic 切分为多个 Partition。每个 Partition 是独立有序的队列,多个消费者可以并行从不同分区读取数据,大幅提升处理效率。
- 水平扩展:随着数据量增长,只需向集群添加更多的 Broker(服务器节点),Kafka 即可自动平衡负载,几乎无性能瓶颈。
Kafka 的高可靠性设计
在金融和电商场景中,“消息不能丢”是最高准则。Kafka 通过以下机制保障数据可靠性:
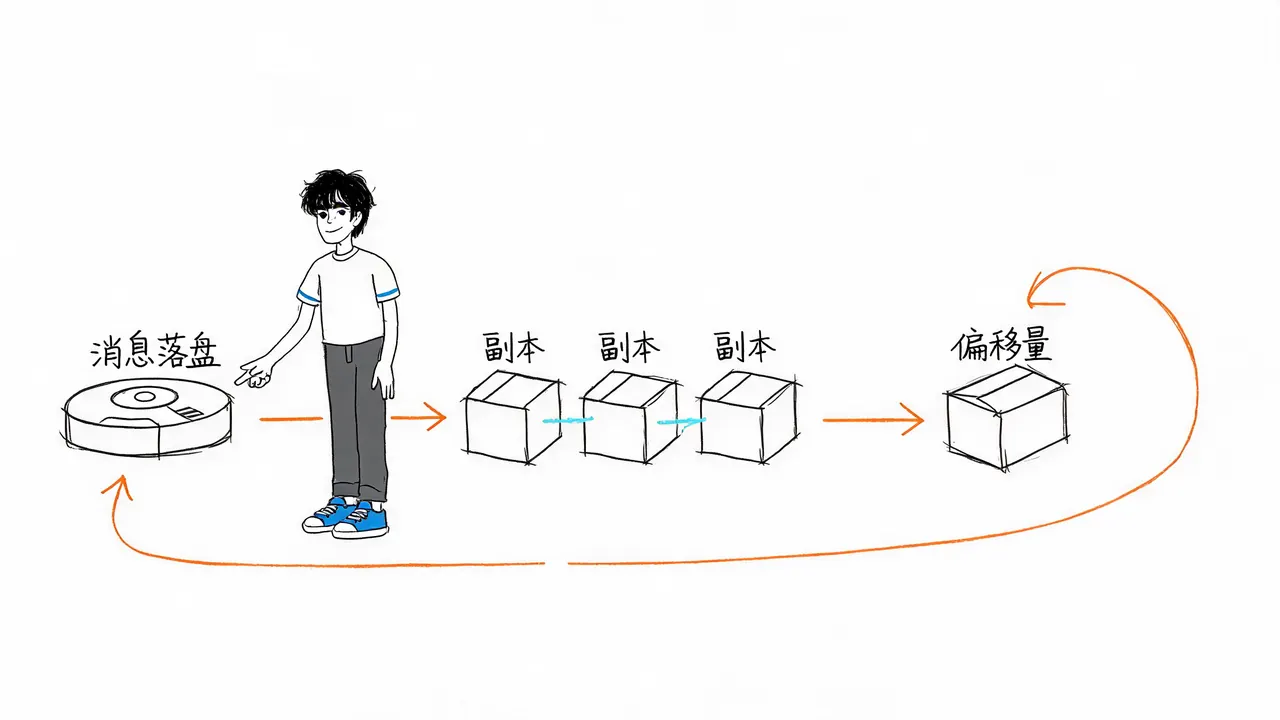
- 消息落盘持久化:消息到达 Kafka 后会立即写入磁盘,即使发生宕机或断电,数据也不会丢失。
- 高可用集群:Kafka 集群由多个 Broker 组成,每个分区的数据都会在多个 Broker 上保存副本。当某个节点故障时,其他副本会自动接管服务,确保业务不中断。
- 偏移量 (Offset) 机制:每条进入 Partition 的消息都会被分配一个递增的序号(Offset)。消费者会记录自己读取到的最新序号,下次继续从该位置读取,从而保证消息既不重复也不遗漏。
Kafka 的实际应用场景
Kafka 在现代互联网架构中无处不在,典型应用包括:
- 电商实时库存更新:用户下单后,Kafka 将订单数据实时传输至库存系统,确保前端能即时显示库存状态。
- 共享单车定位追踪:单车的位置数据通过 Kafka 实时上传至后台,用户打开 APP 即可看到附近的车辆分布。
- 个性化推荐系统:新闻 APP 通过 Kafka 实时收集用户的浏览行为数据,传输给推荐算法,从而计算出你可能感兴趣的内容。
掌握 Kafka,意味着你拥有了处理海量实时数据的核心能力,这是构建现代高并发互联网架构不可或缺的技能。