什么是雪崩效应?一个小服务怎么拖垮整个系统?
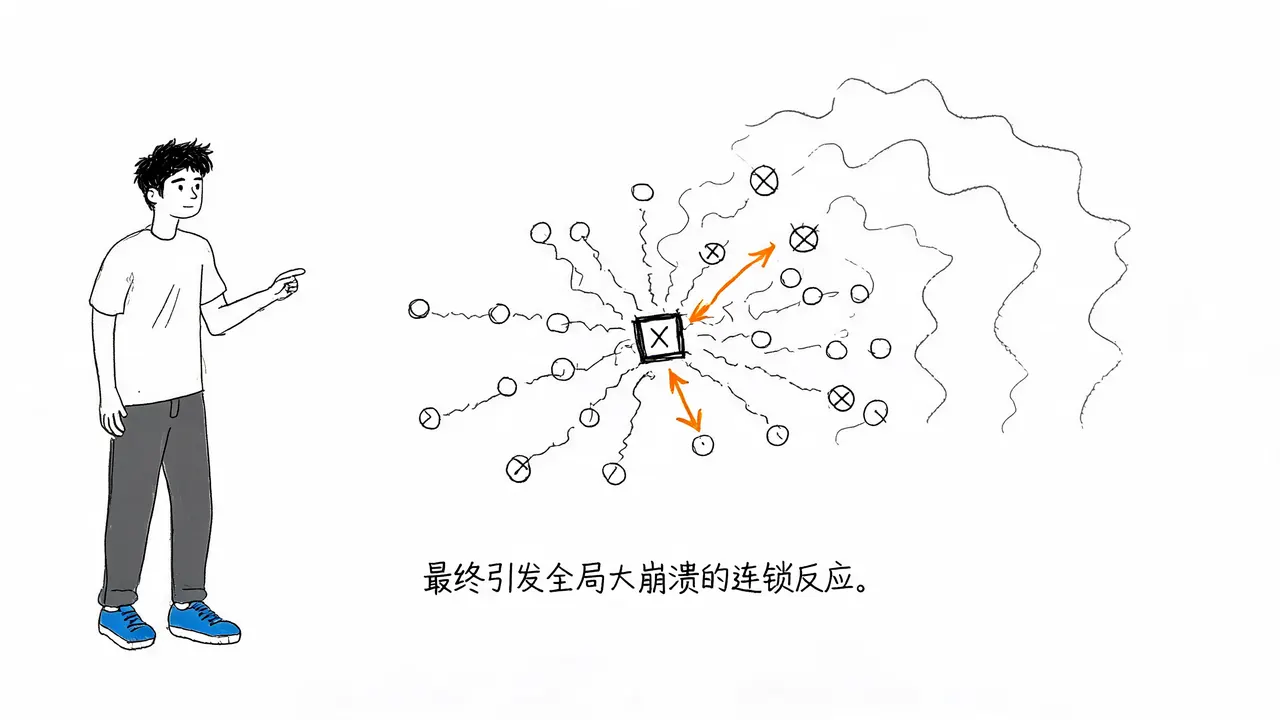
在现代技术架构中,一个看似不起眼的边缘小服务,为何能将整个庞大的系统拖垮?
在技术圈,“雪崩效应”指的是一个局部的小故障,通过系统内部的依赖关系,最终引发全局大崩溃的连锁反应。随着 APP 和网站逐渐从单体架构演变为由几十甚至上百个微服务拼装而成的复杂系统,“牵一发而动全身”的风险也随之增加。
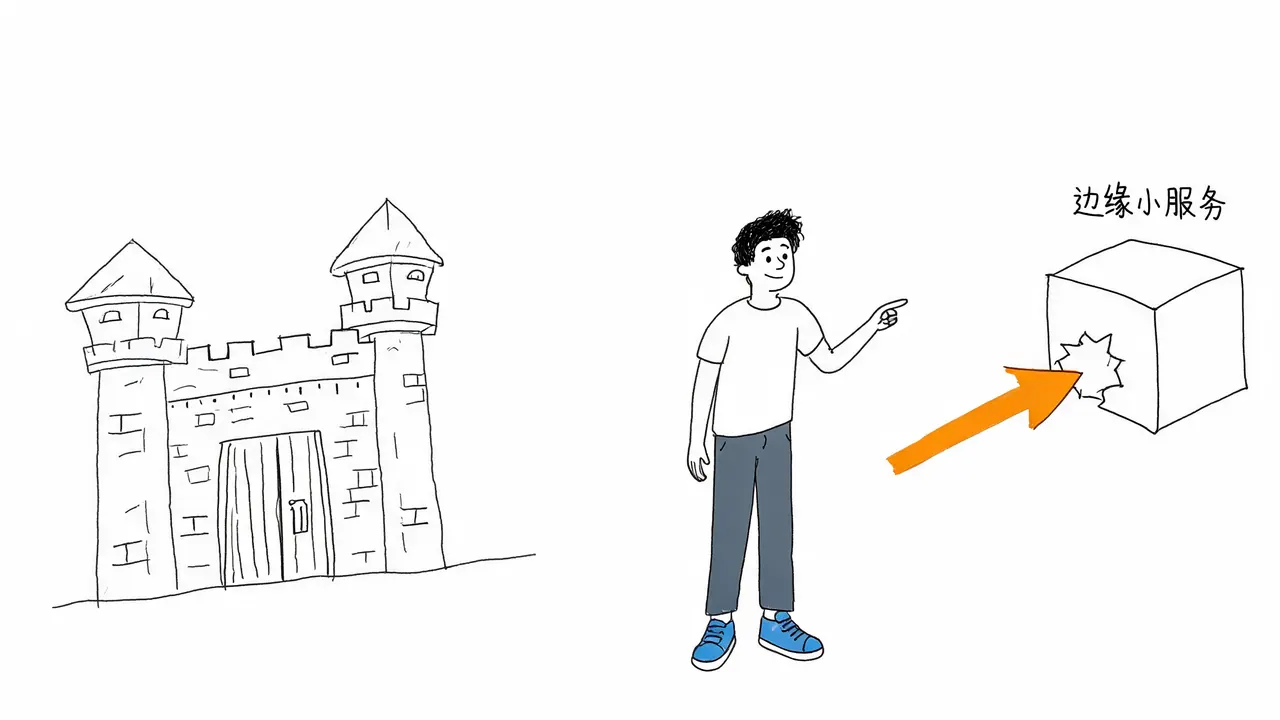
很多人存在一个误解,认为只有支付、登录等核心大服务宕机,系统才会瘫痪。事实上,恰恰相反:很多时候拖垮全局的,往往是一个极其边缘的小服务,例如 APP 里的用户头像加载或非核心的消息推送。
本文将深入剖析雪崩效应的形成机制,并探讨如何通过技术手段阻断这种灾难性的连锁反应。
为什么边缘小服务更具破坏力?
核心服务通常拥有最顶级的服务器配置和最充足的资源保护,具备较强的抗压能力。相比之下,边缘小服务往往资源有限,一旦遭遇流量突增或性能瓶颈,反而成了系统中最容易被突破的缺口。
当这个“小缺口”出现时,它是如何一步步撕裂整个系统的?整个过程通常分为三个阶段:
1. 资源耗尽:上游服务的盲目等待
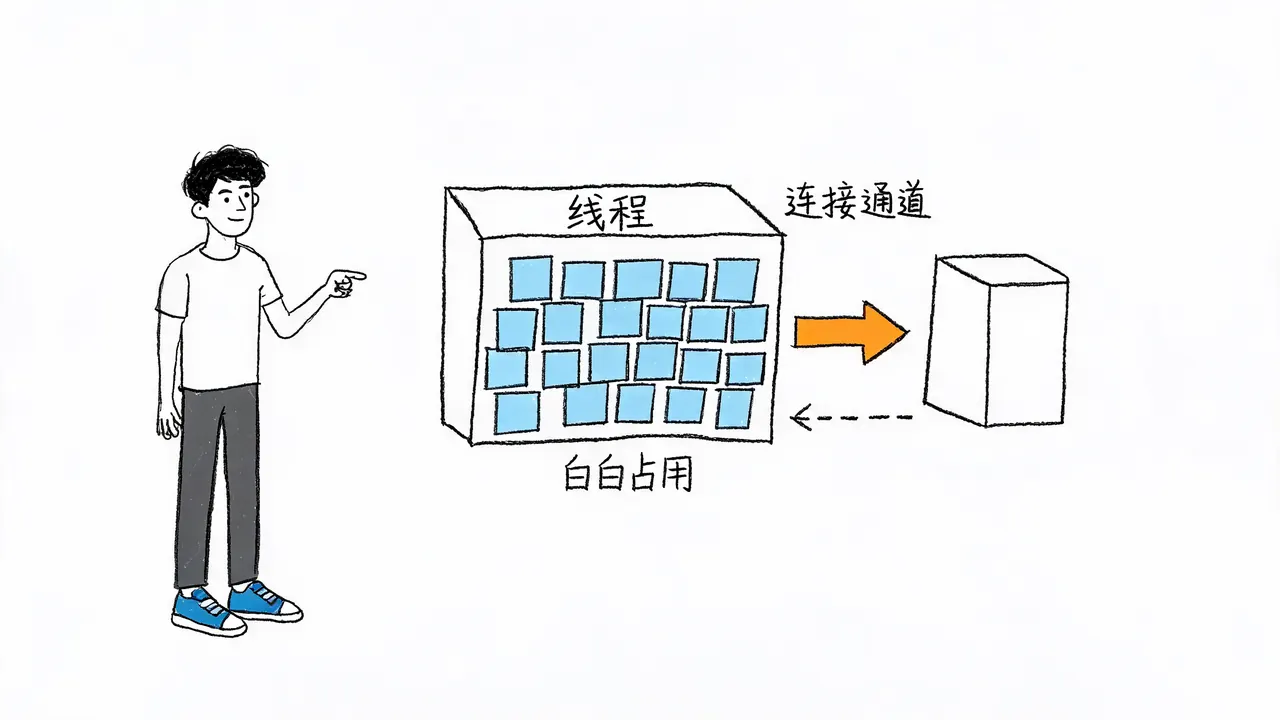
当边缘小服务因流量突增而响应变慢时,调用它的上游服务并不会立刻放弃,而是会停留在原地等待,直到超时。
在这个等待过程中,上游服务用来处理任务的线程和连接通道被白白占用。随着等待时间的延长,上游服务自身的资源也被占满,导致其处理其他正常请求的速度随之变慢。这种资源的无效占用,是雪崩的起点。
2. 重试风暴:灾难的放大器
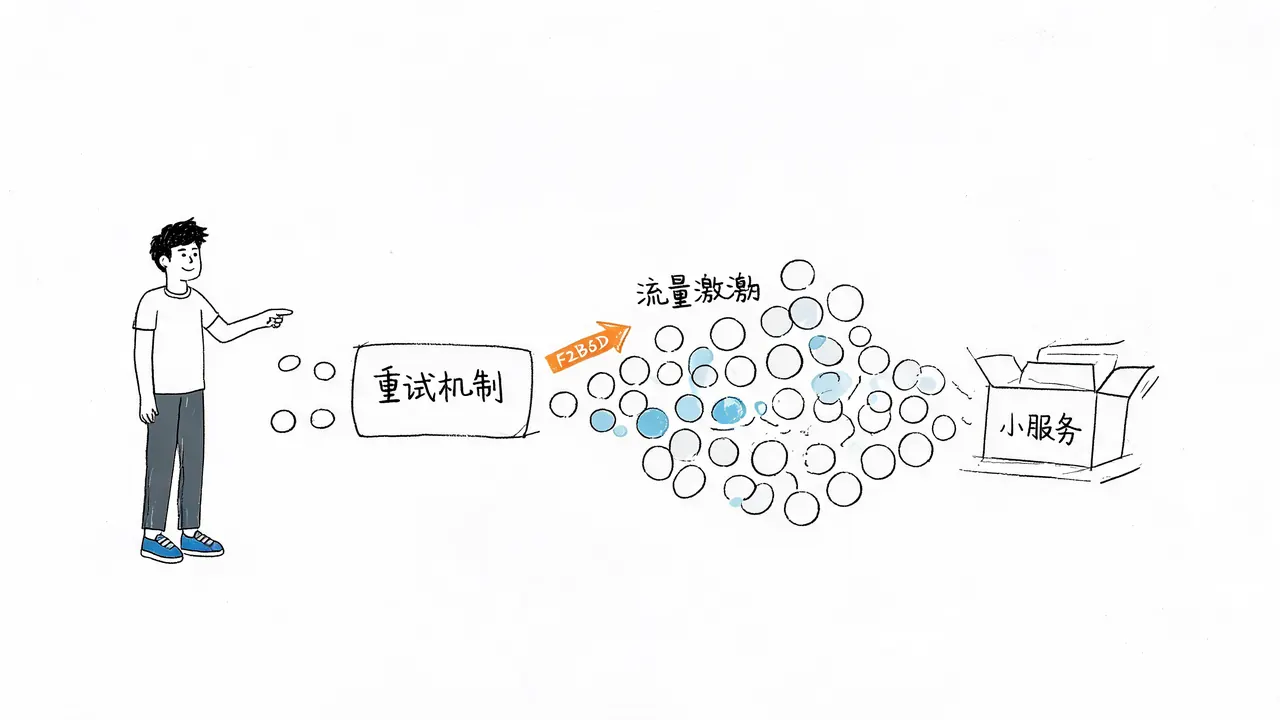
当上游服务发现请求超时失败,或者用户发现页面无法加载时,系统通常会触发自动重试机制,用户也会下意识地反复刷新页面。
原本一个正常的请求,瞬间变成十个、一百个,甚至更多,全部砸向那个本来就响应缓慢的小服务。这不仅无法“救活”小服务,反而用巨大的垃圾流量将其彻底压死。这种由重试机制引发的流量激增,被称为“重试风暴”,它极大地放大了初始故障的影响。
3. 级联故障:跨服务的蔓延
当小服务彻底宕机后,灾难开始跨服务蔓延,这在技术上称为“级联故障”(Cascading Failure)。
上游服务因为等不到小服务的回应,自己也跟着卡死;接着,上游的上游也因为等待资源而瘫痪。这就像高速公路上的连环追尾:最前方只是一辆小车抛锚,但因为后方车辆都在同一条车道上等待,最终导致整条高速大堵车。
一个边缘接口的超时,就这样顺着依赖链条,把整个 APP 拖到白屏,导致全局不可用。
如何阻断雪崩效应?
并不是所有的小故障都会必然引发雪崩。雪崩效应成立的前提,是系统内部缺乏有效的隔离机制。如果在系统设计时加入了熔断和降级机制,雪崩就能被有效拦住。
熔断机制:系统的“保险丝”
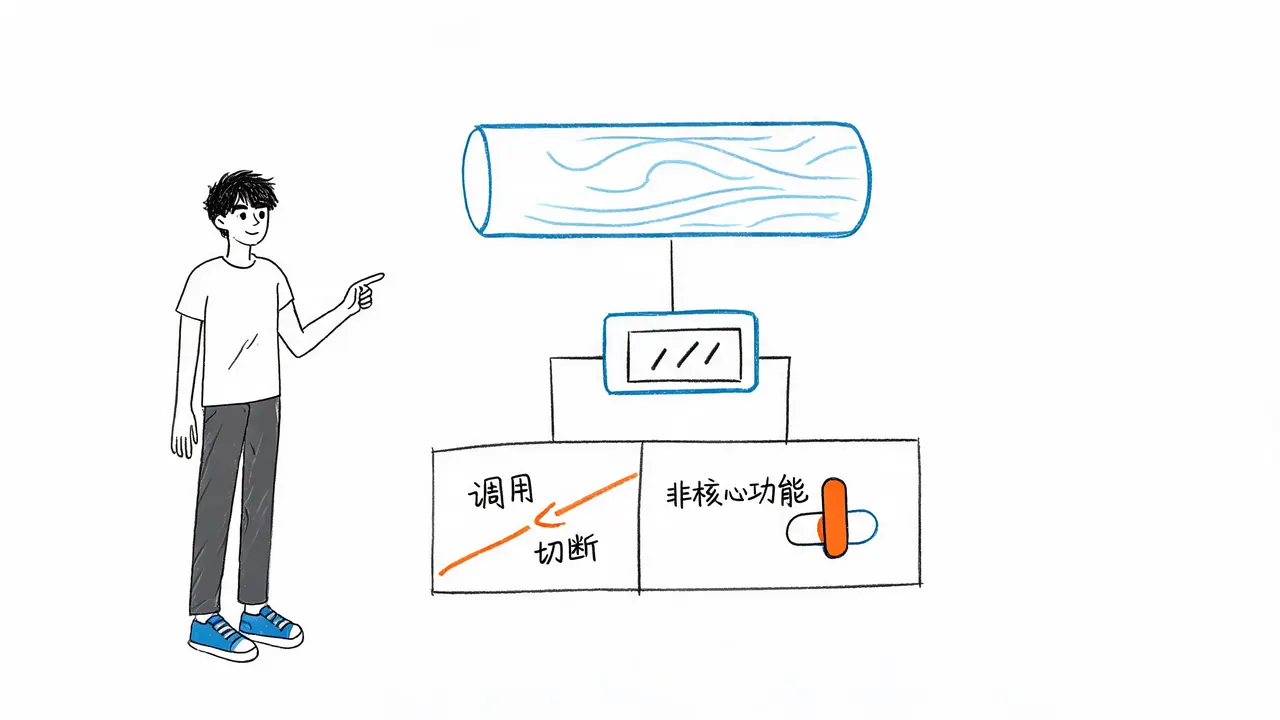
熔断就像电路里的保险丝。当上游服务发现某个下游小服务响应太慢或失败率过高时,会直接切断对它的调用,不再进行无意义的等待。
此时,上游服务会直接返回一个默认结果或错误提示,绝不让自己“傻等”。这种快速失败(Fail-Fast)的策略,保护了上游服务的资源不被耗尽。
降级策略:保全主流程
降级则是暂时关闭非核心功能,以保全主流程的通畅。例如,在系统压力大时,暂时停止加载用户头像或关闭非关键的消息推送,确保核心的交易或浏览功能不受影响。
有了这些机制,小故障就会被限制在局部范围内,无法扩散至整个系统。
结语
雪崩效应揭示了复杂系统的一个残酷真相:系统越庞大,内部连接越紧密,局部的脆弱就越容易演变成全局的灾难。
理解雪崩效应,其实就是理解现代技术世界的一个核心原则:在追求高效的同时,必须时刻为意外留有余地。通过合理的架构设计、资源隔离以及熔断降级策略,我们才能构建出真正具备高可用性的系统。