MySQL 长事务的三大隐蔽危害与优化策略
在 MySQL 数据库运维与开发中,长事务(Long Transaction)常被称为“潜伏的性能杀手”。许多开发者存在一个误区,认为只要单条 SQL 执行速度快,系统就不会出现问题。然而,长事务与慢查询是两个完全不同的概念。长事务并非指单条 SQL 执行缓慢,而是指事务开启后,在明显超过正常业务所需时间的情况下,迟迟没有提交(Commit)或回滚(Rollback)。
这种“占着资源不释放”的行为,会通过多种隐蔽的方式拖垮服务器,甚至导致整个数据库系统崩溃。本文将深入剖析长事务的本质,解析其引发的三大核心性能危害,并给出相应的优化策略。
``长事务与慢查询的本质区别
首先需要澄清一个常见误解:长事务不等于慢查询。
- 慢查询:指单条 SQL 语句本身执行耗时较长,通常涉及全表扫描、复杂计算或缺乏索引。
- 长事务:指事务的生命周期过长。事务内的每一条 SQL 可能都执行得非常快,但如果在两条 SQL 之间调用了耗时的外部接口(如 HTTP 请求、RPC 调用)或进行了复杂的业务逻辑计算,导致事务无法及时提交,就会形成长事务。
类比理解: 这就好比在超市收银台结账。扫码(执行 SQL)很快,但如果你突然接了一个十分钟的电话(调用外部接口/复杂计算)而不付钱(提交事务),后面排队的人(其他并发请求)就会全部被堵死。这种“站着位置不提交”的行为,是长事务危害的根源。
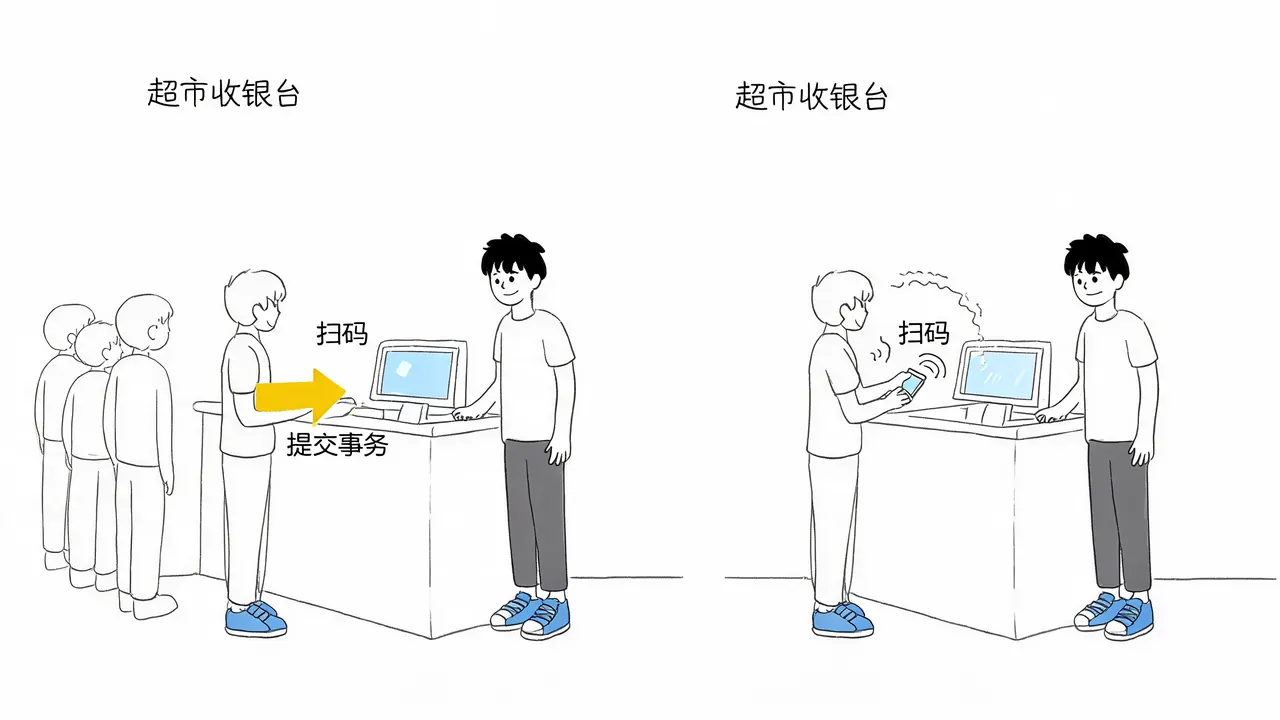
危害一:锁竞争与阻塞
长事务引发的第一个致命问题是锁竞争与阻塞。
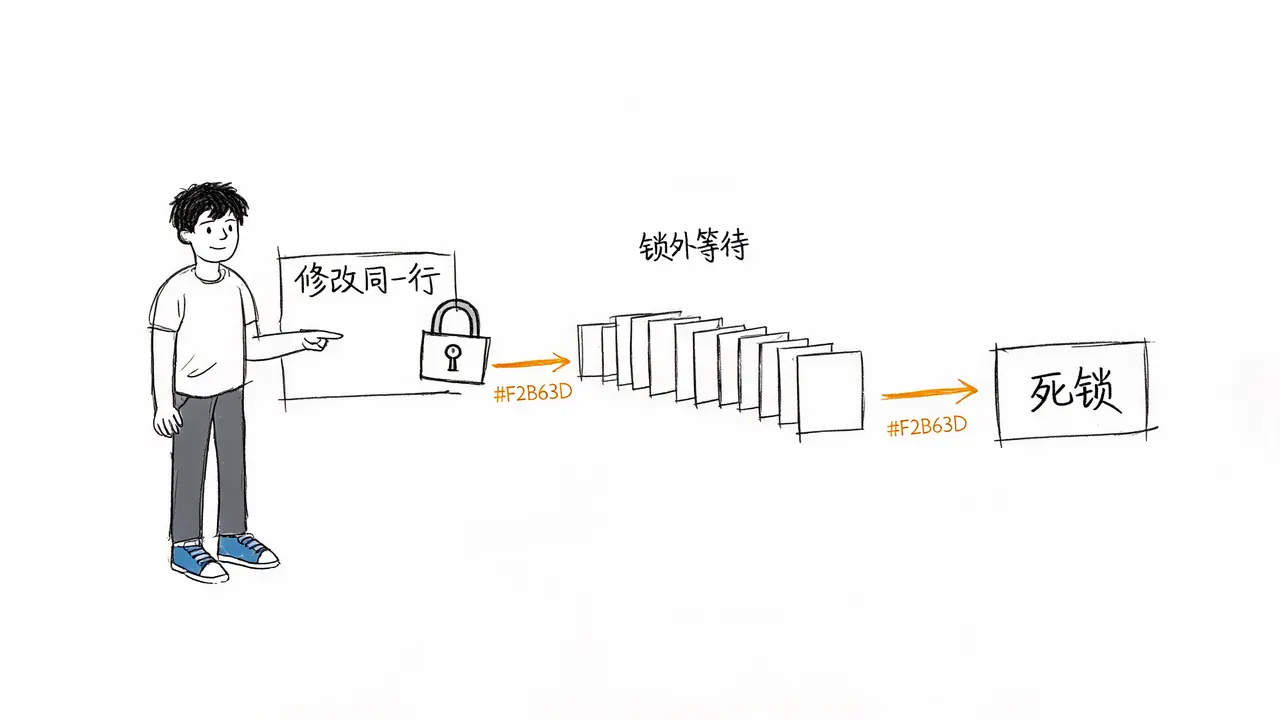
在 MySQL 中,修改数据通常需要对相关行或表加锁。长事务一旦修改了某行数据,相关的锁就会一直持有,直到事务提交或回滚。
- 阻塞机制:如果其他业务也需要修改同一行数据,它们只能在锁外等待。
- 连锁反应:随着并发量的增加,等待的队伍会越来越长。这不仅导致系统响应时间变慢,还会显著增加死锁(Deadlock)发生的概率。
- 最终后果:大量请求超时,整个业务链路出现连锁阻塞,甚至导致服务不可用。
危害二:Undo Log 与历史版本堆积
第二个问题更为隐蔽,即 Undo Log 和历史版本的不断堆积。
MySQL 通过 MVCC(多版本并发控制)机制保证事务隔离性。为了实现回滚和让其他查询看到一致的历史数据,MySQL 会将修改前的旧版本数据保存在 Undo Log 中。
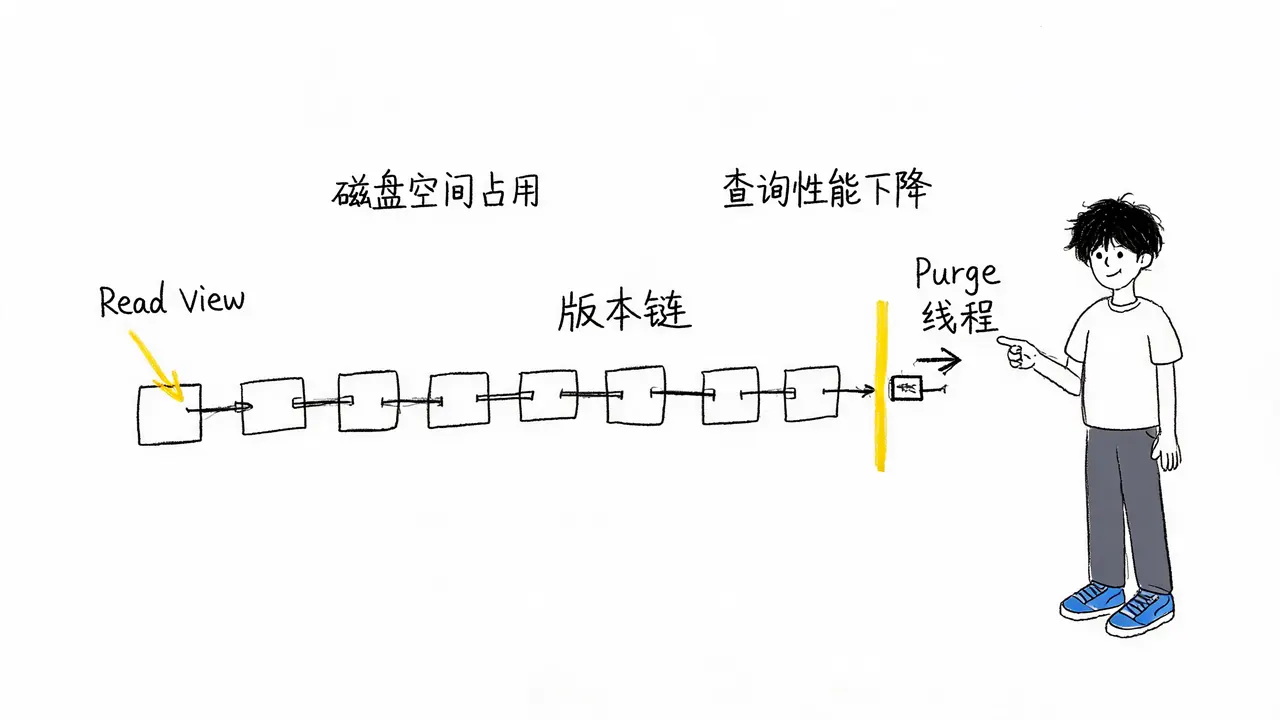
- 正常流程:当历史版本不再被任何活跃事务需要时,后台的 Purge 线程会逐步清理这些旧版本。
- 长事务影响:如果存在一个长事务,其 Read View 可能一直需要访问较老的数据版本。这会导致部分历史版本无法及时回收。
- 性能隐患:
- 磁盘空间占用:Undo Log 和版本链越积越多,占用大量磁盘空间。
- 查询性能下降:查询历史版本的成本越来越高,因为需要遍历更长的版本链才能找到可见版本。
危害三:加剧主从延迟
第三个问题在长事务同时包含大量写操作时尤为突出,即加剧主从延迟。
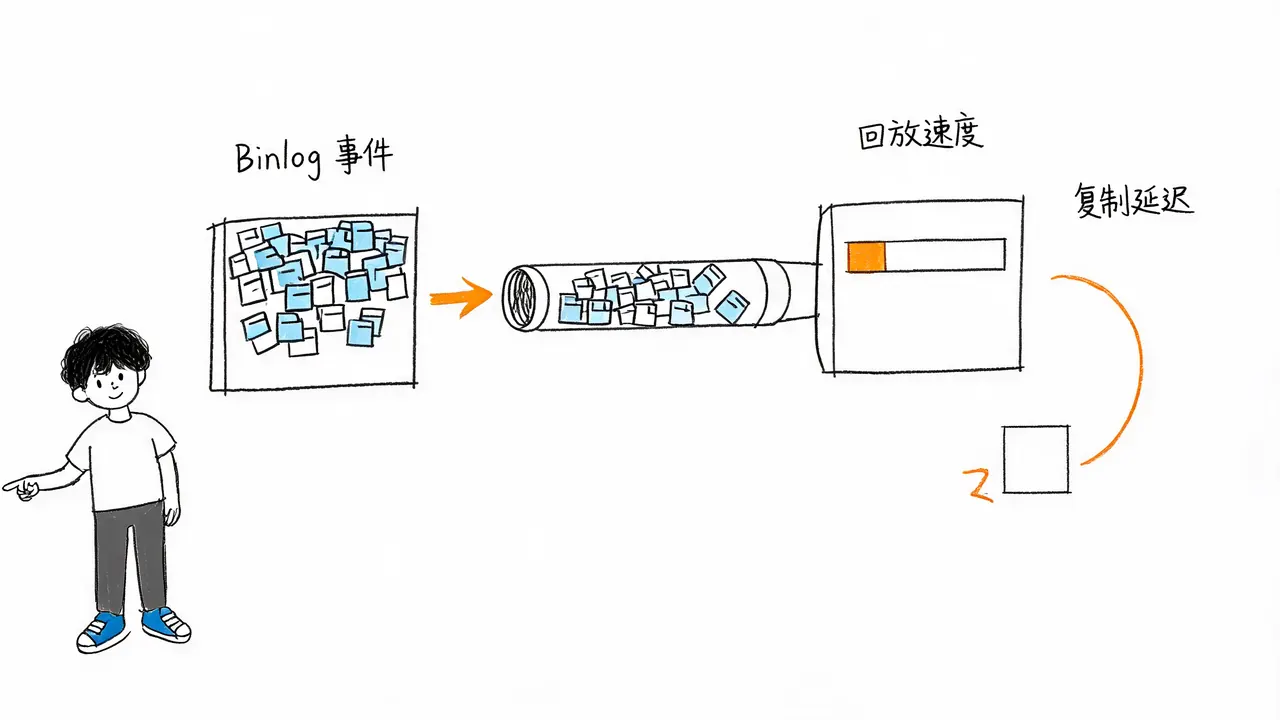
在许多生产环境中,采用“主库写、从库读”的架构。主库事务提交后,会将对应的 Binlog 发送给从库进行同步和回放。
- 大事务场景:如果一个事务一次性更新或删除了数十万甚至数百万行数据,虽然主库执行可能较快,但提交后产生的 Binlog 事件量巨大。
- 回放瓶颈:从库需要处理大量的 Binlog 事件。如果从库的回放速度跟不上主库的写入速度,就会出现几秒甚至几分钟的复制延迟。
- 业务影响:用户刚下完单去查询订单,由于从库数据尚未同步,可能查不到最新数据,直接影响用户体验和数据一致性感知。
优化策略:让数据库轻装上阵
理解长事务的危害,本质上是要明白:数据库事务是为了保证数据一致性,而不是用来包裹整个业务流程的。
要解决长事务问题,核心思路是缩短事务持有资源的时间:
- 拆分大事务:将包含大量数据操作的事务拆分为多个小事务,避免单次事务处理过多数据。
- 移出耗时操作:将耗时的网络调用(如 HTTP、RPC)和复杂的业务计算逻辑移出事务范围。先完成外部调用和计算,再开启事务执行数据库操作。
- 及时提交:确保事务在业务逻辑完成后立即提交或回滚,避免在事务中穿插非数据库操作。
通过上述措施,可以有效避免锁竞争、Undo Log 堆积和主从延迟等问题,让数据库系统保持高效、稳定的运行状态。