MySQL 锁机制详解:从粒度到模式的并发控制体系
MySQL 锁机制详解:从粒度到模式的并发控制体系
在数据库开发中,锁是控制并发访问、防止数据冲突的核心机制。许多开发者面对“表锁”、“行锁”、“共享锁”、“间隙锁”等名词时往往感到困惑,难以建立清晰的认知体系。实际上,如果没有锁机制,当多个用户同时修改同一条账户余额时,数据一致性将立即被破坏。
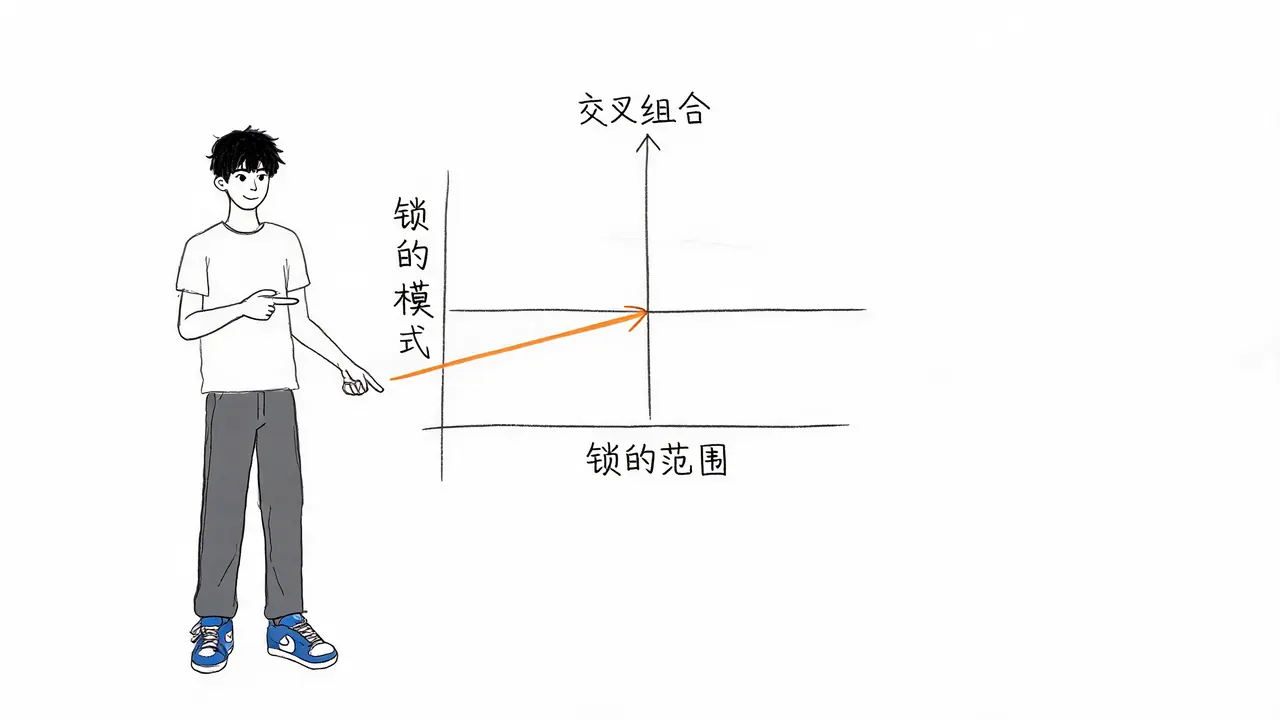
为了理清 MySQL 的锁机制,我们需要打破“锁是一个平铺长名单”的误解。MySQL 的锁并非简单的列表,而是基于两个不同维度的交叉组合:
- 锁的范围(粒度):决定锁住的数据量大小。
- 锁的模式:决定锁的排他性程度,即是否允许其他事务靠近。
理解这两个维度,所有锁类型都能对号入座,从而掌握数据库并发控制的底层逻辑。
维度一:锁的范围(粒度)
锁的范围决定了并发影响面。范围越大,并发性能越低,但数据一致性保障越强;范围越小,并发性能越高,但实现复杂度也越高。
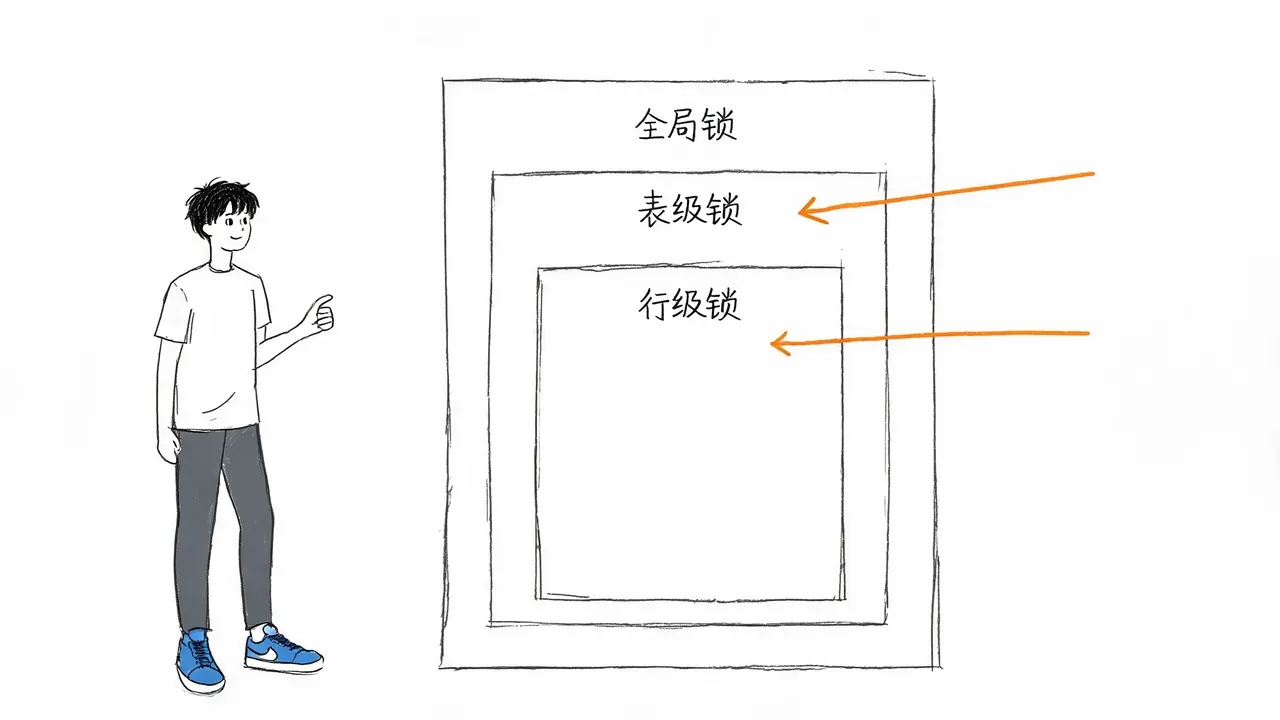
1. 全局锁 (Global Lock)
- 定义:相当于锁住整个数据库的大门,所有用户只能读不能写。
- 典型场景:全库数据备份。
- 作用:保证备份出来的数据在逻辑上是一致的,避免备份过程中数据发生变化导致备份文件不可用。
2. 表级锁 (Table Lock)
- 定义:相当于锁住某个房间的门,针对整张表进行锁定。
- 典型场景:DDL 操作(如增加字段、修改表结构)。
- 机制:当执行
ALTER TABLE等结构变更操作时,系统会自动加上元数据锁(MDL)。此时其他事务必须等待,防止在表结构变更过程中有数据写入,从而保证结构变更的安全性。
3. 行级锁 (Row Lock)
- 定义:相当于只锁住房间里的某一把具体椅子,仅锁定特定的数据行。
- 典型场景:高并发下的数据更新(如更新某条用户订单)。
- 优势:这是 InnoDB 引擎能支撑高并发的核心原因。当更新某一行数据时,其他用户对该表其他行的操作完全不受影响,极大提升了系统的吞吐量。
维度二:锁的模式
锁的模式决定了事务之间的交互规则,主要分为共享锁和排他锁。
1. 共享锁 (Shared Lock, S Lock)
- 别名:读锁。
- 特性:类似阅览室,多个事务可以同时持有共享锁,互不干扰。
- 适用操作:普通的
SELECT查询(在特定隔离级别或显式加锁时)。
2. 排他锁 (Exclusive Lock, X Lock)
- 别名:写锁。
- 特性:类似单人密室,一旦某个事务持有排他锁,其他事务无论是要读还是写,都必须在门外排队等待。
- 适用操作:
INSERT、UPDATE、DELETE等写操作。系统在执行这些操作时会自动加上排他锁,以确保数据修改的原子性和一致性。
InnoDB 行锁的三种形态
当我们将行级锁与排他锁结合时,就进入了高并发场景中最容易出问题的“深水区”。InnoDB 引擎为了实现更细粒度的并发控制,将行锁细分为三种形态:
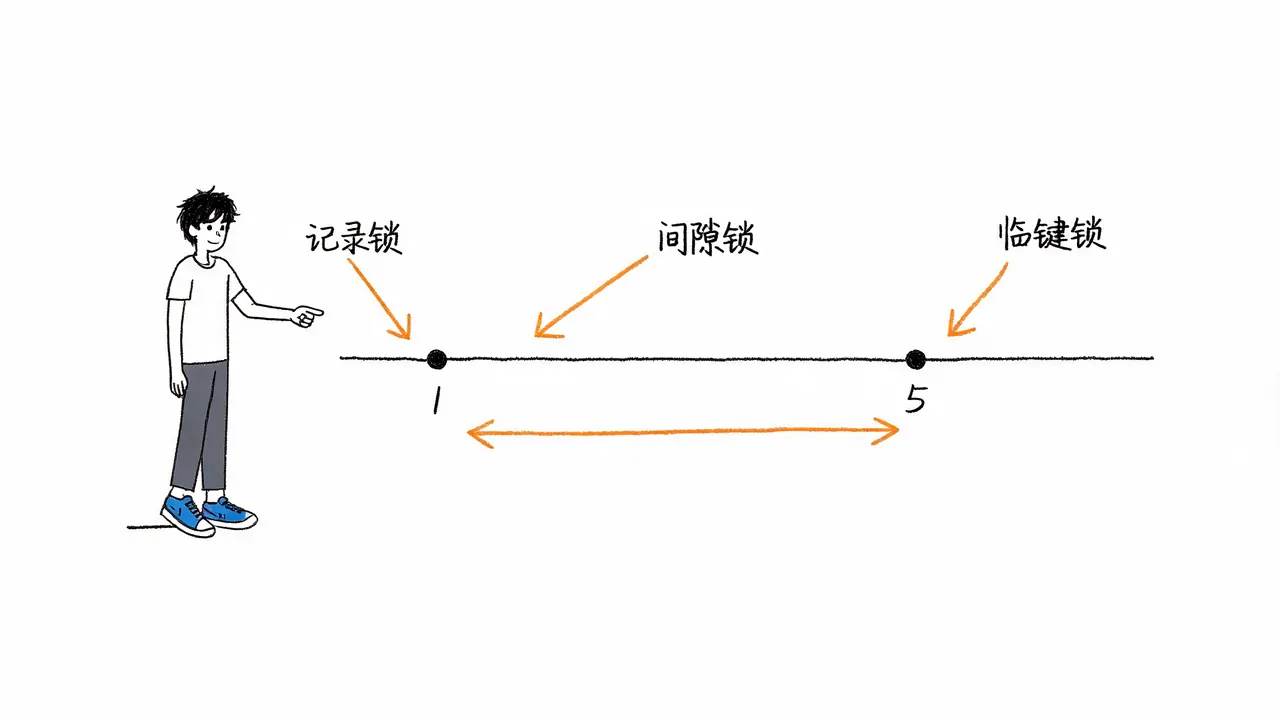
1. 记录锁 (Record Lock)
- 机制:只锁住当前这一行数据。
- 作用:防止其他事务修改这一行数据。
2. 间隙锁 (Gap Lock)
- 机制:不仅锁数据,还锁住数据之间的“空隙”。
- 示例:假设表中存在 ID 为 1 和 5 的数据,间隙锁会锁定 ID 2 到 4 的区间。
- 作用:防止其他事务在这个空隙中插入新数据。这解决了著名的幻读 (Phantom Read) 问题——即你查询时发现某条数据不存在,准备插入时,却发现其他事务刚好插入了该数据。
3. 临键锁 (Next-Key Lock)
- 机制:记录锁和间隙锁的组合。
- 作用:既锁住当前行,又锁住它前面的间隙。
- 地位:这是 MySQL 在默认隔离级别(可重复读,Repeatable Read)下防止幻读的终极武器。
关键陷阱:行锁失效与锁升级
虽然行锁性能优越,但它有一个至关重要的失效边界:InnoDB 的行锁是加在索引上的,而不是直接加在数据行上。
索引失效导致的锁升级
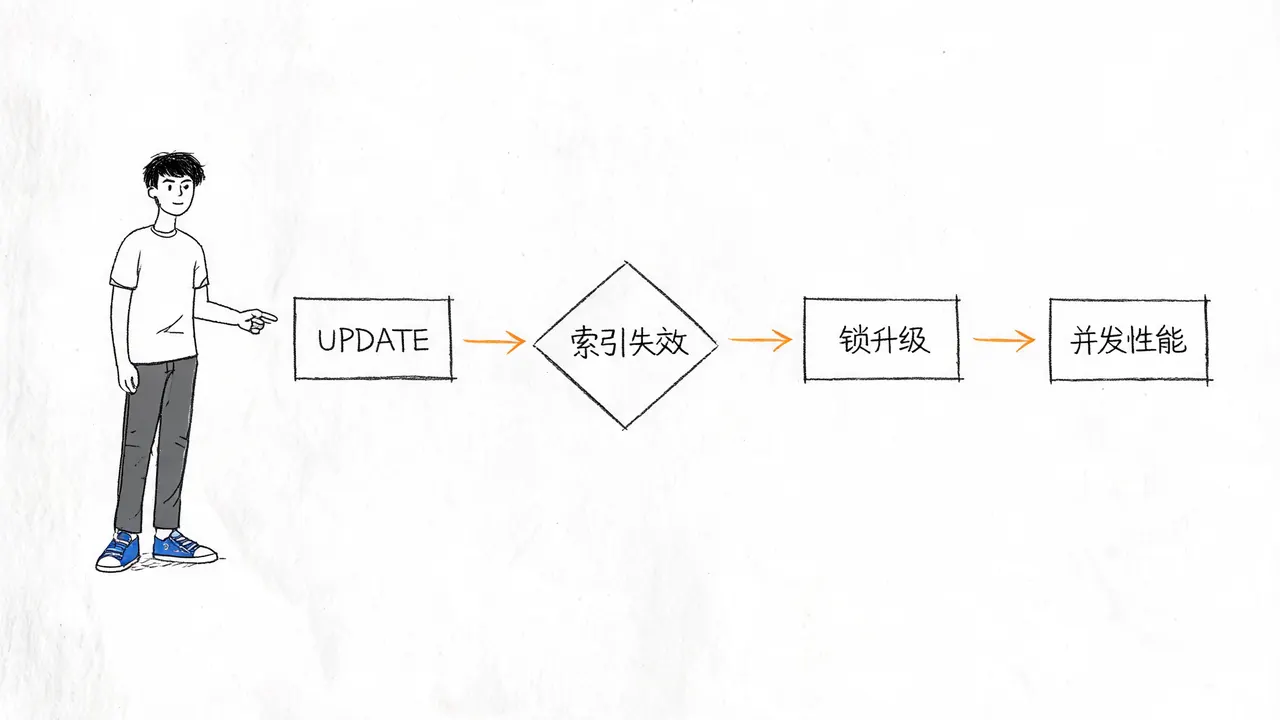
如果在执行 UPDATE 或 DELETE 操作时,WHERE 条件中没有使用索引,MySQL 将无法定位到具体的索引记录。此时,为了找到需要修改的行,MySQL 被迫将行锁升级为表锁。
- 后果:你以为自己只锁了一行,实际上把整张表都锁死了。
- 影响:整个系统的并发性能会瞬间跌到谷底,所有针对该表的读写请求都会阻塞。
总结
理解 MySQL 的锁机制,关键在于看清它保护数据的两层逻辑:
- 用粒度控制影响范围:尽量使用行级锁以支持高并发。
- 用模式控制读写冲突:理解共享锁与排他锁的互斥关系。
最佳实践建议:
- 确保所有的更新和删除条件都能走索引。
- 避免在
WHERE子句中使用函数或隐式类型转换,导致索引失效。 - 通过合理的索引设计,让数据库的并发处理始终保持在最佳状态。