什么是 Elasticsearch?与 MySQL 的核心差异及协作模式
Elasticsearch(简称 ES)是一个专门用于海量数据搜索和分析的分布式引擎。虽然它与 MySQL 都是数据存储系统,但两者的核心分工截然不同。
本文将深入探讨 ES 如何在数亿条数据中实现秒级搜索,剖析它与 MySQL 的核心差异,并揭示在实际业务架构中,这两者是如何协同工作的。
`` 是摘要与正文的分隔标记,请保留。本质差异:严谨的档案柜 vs 聪明的图书管理员
要理解两者的区别,首先需看清它们的本质定位:
- MySQL 是关系型数据库:它像一个严谨的档案柜,擅长将数据一行行规整地存储,确保每一笔账目、每一次交易都准确无误,强调整体的一致性和安全性。
- Elasticsearch 是搜索引擎:它更像一个聪明的图书管理员,其绝活是在海量的文章、商品或日志中,瞬间找出包含特定关键词的内容,强调搜索的速度和灵活性。
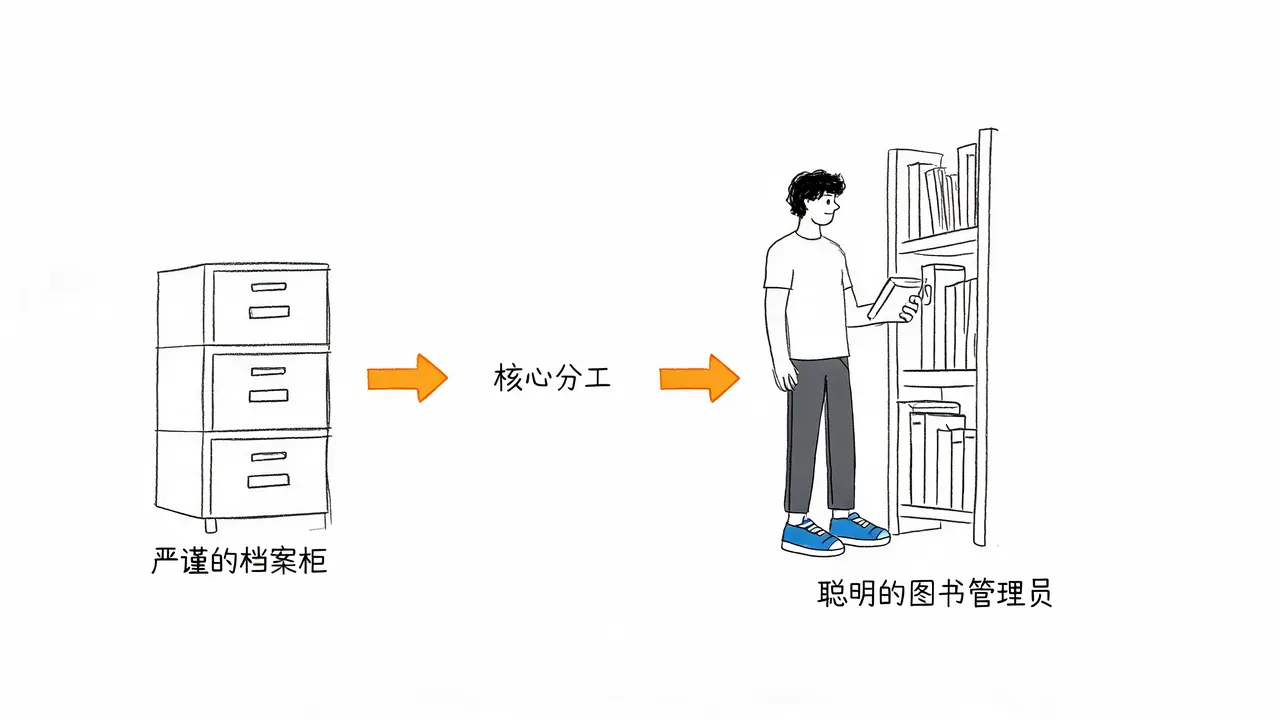
这种能力差异的根源,在于它们底层查找数据的方式完全不同。
核心原理:B+ 树索引 vs 倒排索引
MySQL:精确查找的利器
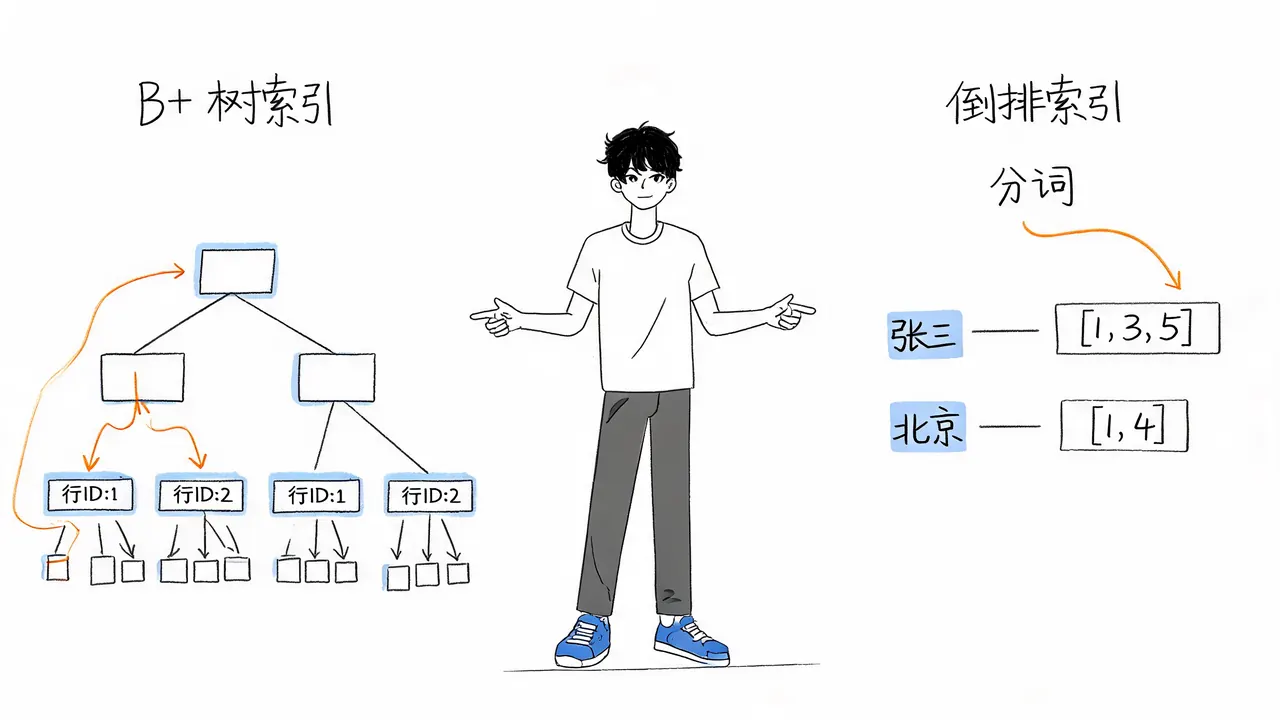
MySQL 查询数据主要依赖 B+ 树索引。这就像查字典的拼音目录,非常适合精确查找。例如,找出 ID = 100 的用户,MySQL 能迅速定位。
然而,如果要在几千万篇文章中搜索同时包含“苹果”和“手机”的内容,MySQL 往往需要逐行扫描(全表扫描),速度会非常慢,难以满足复杂文本搜索的需求。
Elasticsearch:海量文本的秒级响应
ES 使用的是 倒排索引(Inverted Index) 机制。它在存入数据时,会提前将文章拆分成一个个独立的词(分词),并记录下每个词具体出现在哪些文档中。
当你发起搜索时,ES 直接去查这个词对应的文档列表,通过集合运算快速得出结果。因此,无论数据量多大,ES 都能实现近乎瞬间的响应。
数据结构:固定模式 vs 灵活文档
除了搜索方式,两者对数据格式的要求也存在显著差异:
- MySQL 要求预定义结构:在存入数据前,必须提前定义好表结构(Schema)。如果想增加一个新字段,通常需要修改表结构,这在大规模系统中可能涉及锁表等风险。
- ES 存储基于文档(Document):ES 的基本存储单位是类似 JSON 格式的文档,结构非常灵活。一条数据可以有 10 个字段,另一条可以有 20 个字段,ES 都能直接存入。
这种灵活性使得 ES 特别适合处理商品详情、用户行为日志等字段经常变化或非结构化的数据。
常见误区:能用 ES 替代 MySQL 吗?
由于 ES 搜索速度极快,很多人产生了一个误解:干脆把所有数据都存进 ES,淘汰 MySQL。这在多数情况下是行不通的。
ES 的强项在于搜索和复杂分析,但它存在以下短板:
- 不支持强一致性事务:ES 不擅长处理像财务转账那样需要严格 ACID 特性的复杂事务。
- 单条数据修改效率较低:在频繁更新单条数据的场景下,ES 的性能不如 MySQL。
因此,在真实的系统架构中,它们通常是搭档关系,而非替代关系。
最佳实践:MySQL 与 ES 的协作模式
在典型的互联网架构中,两者的分工如下:
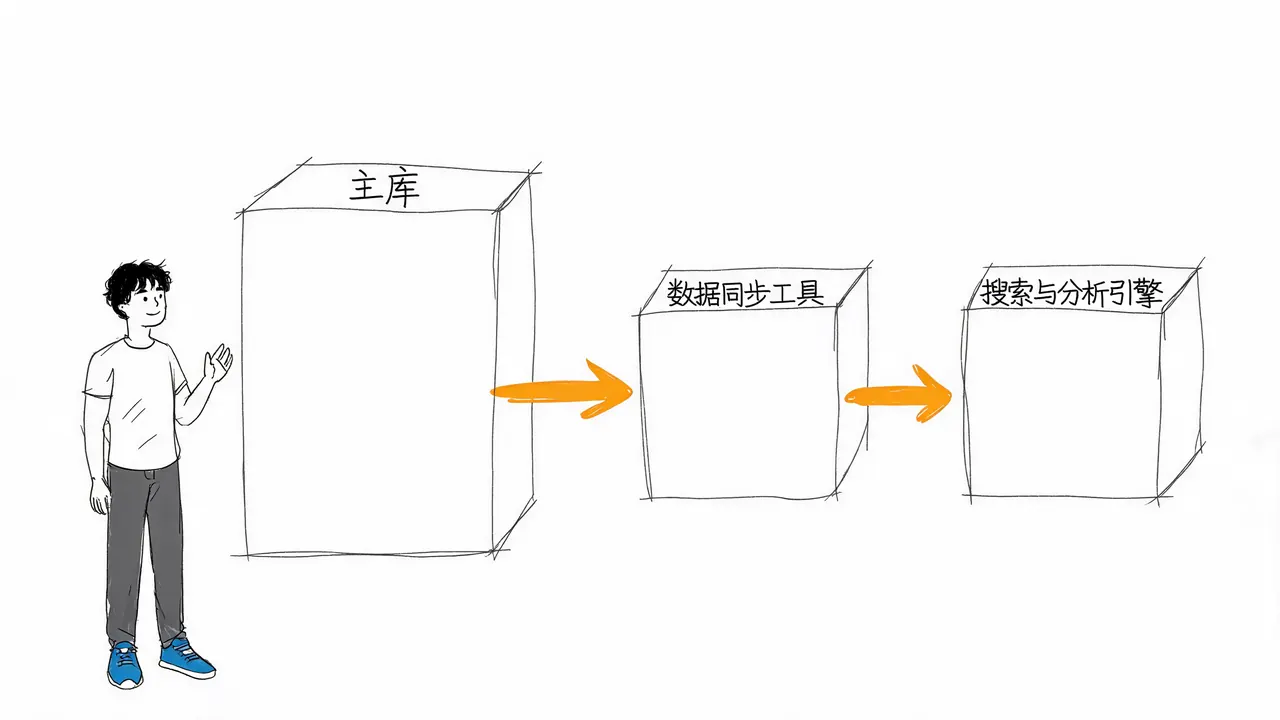
- MySQL 作为主库:负责核心业务数据的安全存取、修改和事务处理,确保数据的准确性和一致性。
- ES 作为搜索与分析引擎:通过数据同步工具(如 Canal、Logstash 等),将 MySQL 中的数据实时复制给 ES。ES 专门负责为用户提供搜索框、全文检索以及数据分析大屏。
需要注意的边界:近实时性
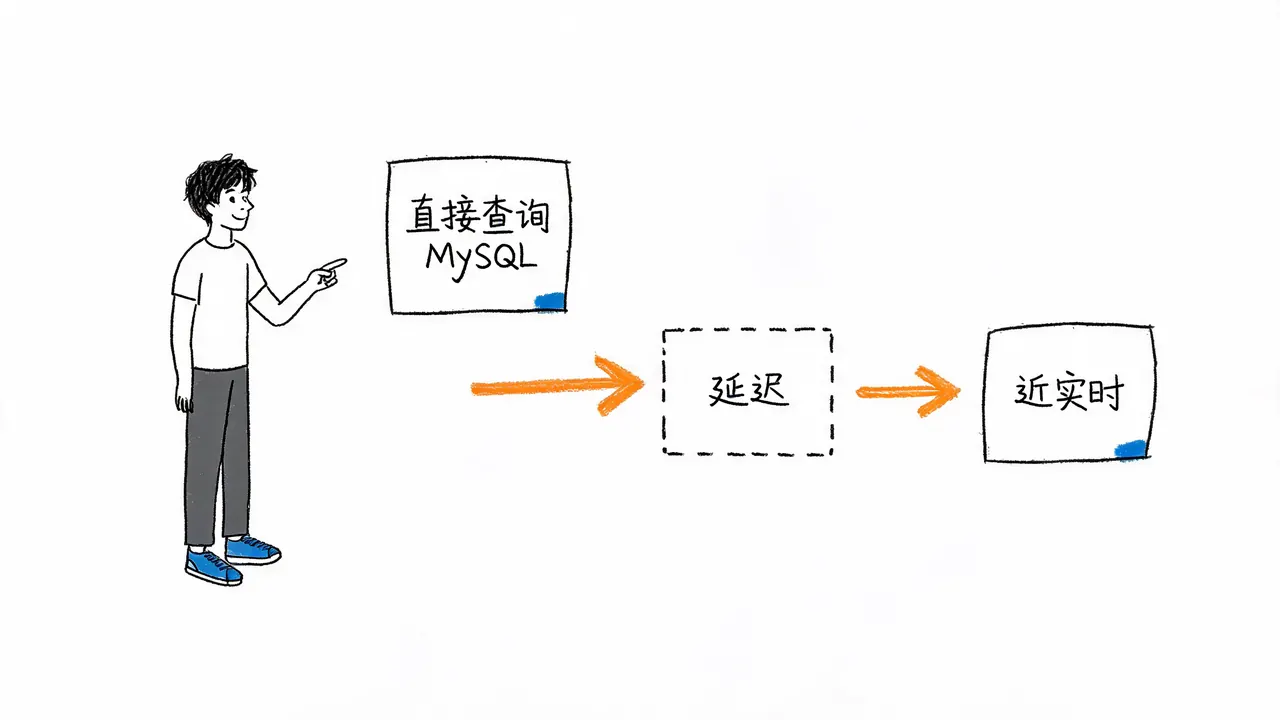
在这种搭档模式下,有一个必须留意的技术边界:ES 的搜索是“近实时”的。
数据写入 MySQL 后,再同步到 ES 并建立索引,通常会有毫秒到秒级的延迟。如果你的业务场景对实时性要求极高(例如:用户刚下完单,立刻就要在搜索列表里看到订单状态更新),则不能依赖 ES,而应直接查询 MySQL。
总结
- MySQL 守住数据的准确和安全,擅长事务处理和精确查询。
- Elasticsearch 撑起搜索的速度和灵活,擅长海量数据的全文检索和复杂分析。
看懂它们各自的能力边界,就能在系统设计中明确“该让谁去干什么活”,从而构建出既稳定又高效的业务架构。