有了定时任务,为什么还要延迟队列?
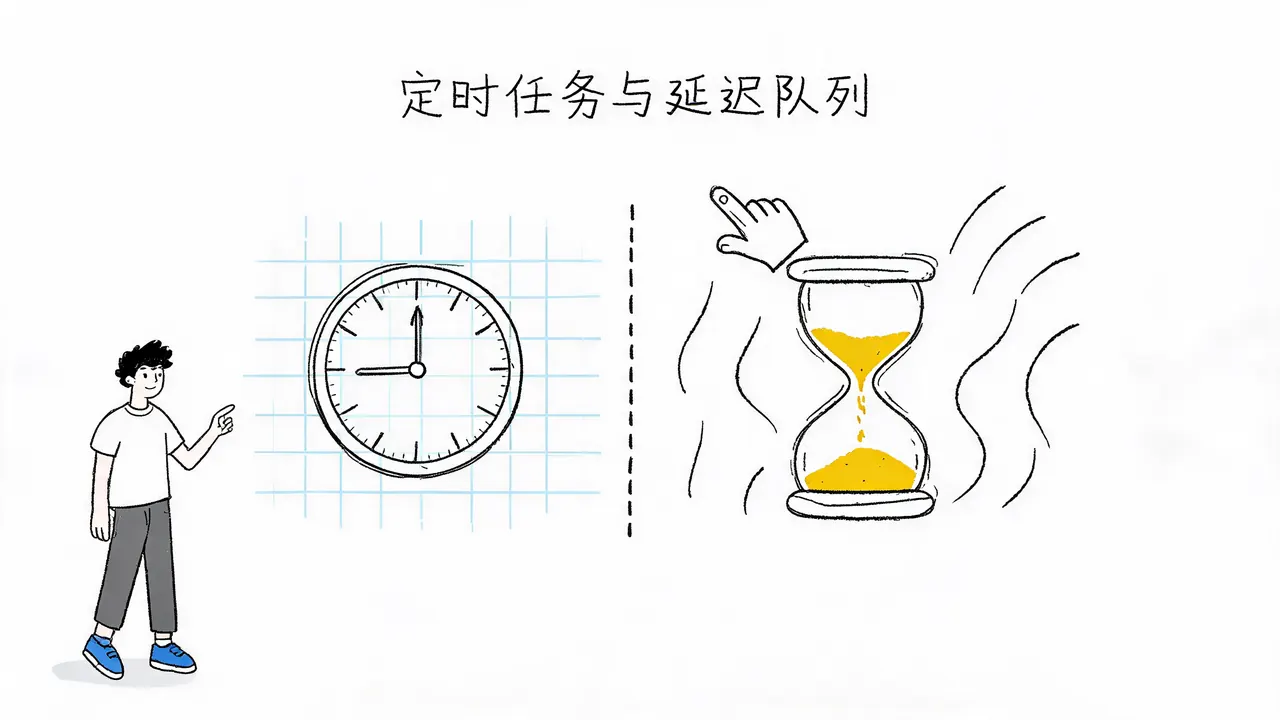
很多刚接触后端开发的工程师常有一个疑问:既然定时任务和延迟队列都能实现“过一会儿再执行”的功能,为什么系统里还要专门搞一个延迟队列?两者看起来相似,但底层逻辑截然不同。
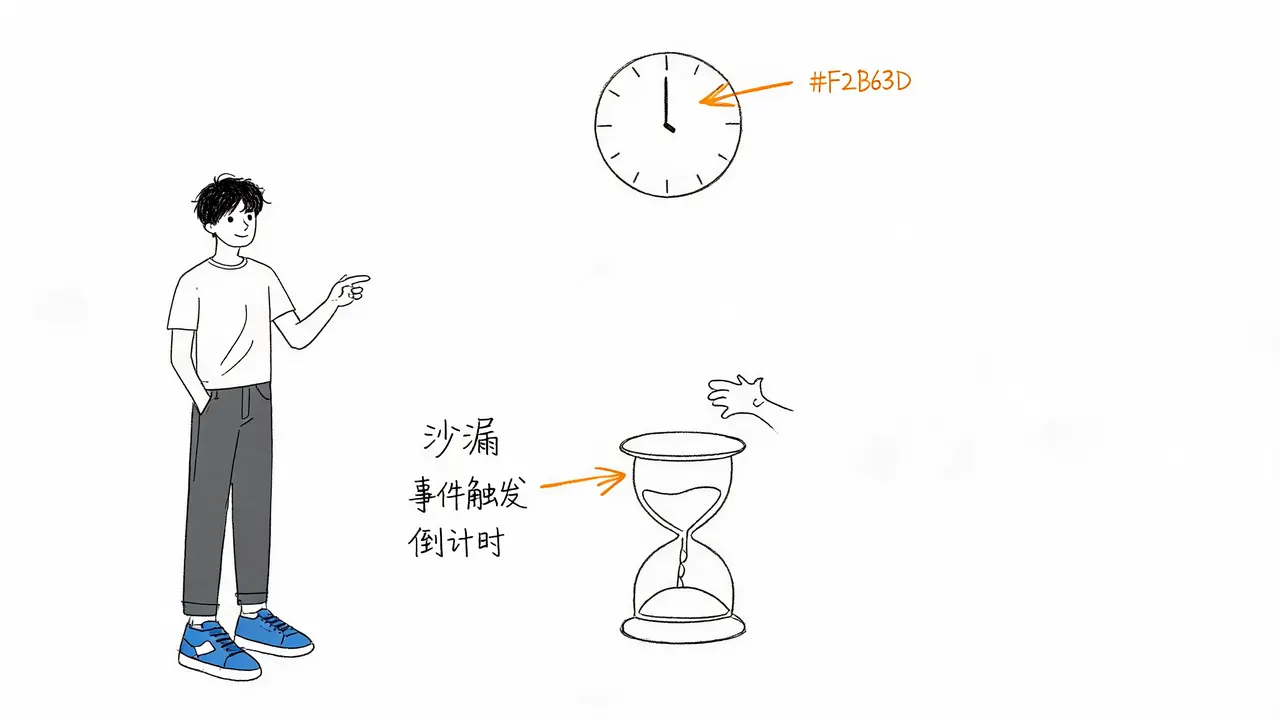
简单来说,定时任务是一个按固定时间表运行的闹钟,而延迟队列是一个由事件触发的倒计时沙漏。
搞清楚这两者的区别,不仅能帮你避开系统性能卡顿的坑,还能让你在设计业务时选对工具。本文将从执行逻辑、性能影响及适用场景三个维度,深入剖析为什么有些场景下,定时任务搞不定,非得靠延迟队列来救场。
核心区别:触发条件与执行周期
定时任务与延迟队列最本质的区别,在于触发条件和执行周期完全不同。
1. 定时任务:固定的“挂钟”
定时任务有明确的触发时间和固定的执行周期。
- 特点:它就像墙上的挂钟,时间一到,不管有没有具体事件发生,它都会准点响铃。
- 示例:每天凌晨 2 点执行数据备份,或者每隔 10 分钟同步一次配置。
2. 延迟队列:动态的“沙漏”
延迟队列没有固定的开始时间,它是由某个具体事件触发的。
- 特点:它更像是一个沙漏,只有当特定动作(如用户下单)发生,把沙漏倒过来,倒计时才真正开始。
- 示例:用户下单后,延迟 30 分钟执行取消未支付订单的操作。
为什么强行用定时任务处理动态延迟会“翻车”?
如果尝试用定时任务去处理“下单后 30 分钟取消”这种需求,通常会采用以下做法:
写一个定时脚本,每隔一分钟去数据库里扫一遍,查询是否有超时未付款的订单。
这种做法在数据量小时看似可行,但在高并发或大数据量场景下,会暴露出两个严重问题:
- 性能压力巨大: 数据库每分钟都要被反复全表或索引查询。一旦遇到大促等高流量场景,这种轮询机制会导致数据库负载瞬间拉满,甚至引发系统卡顿。
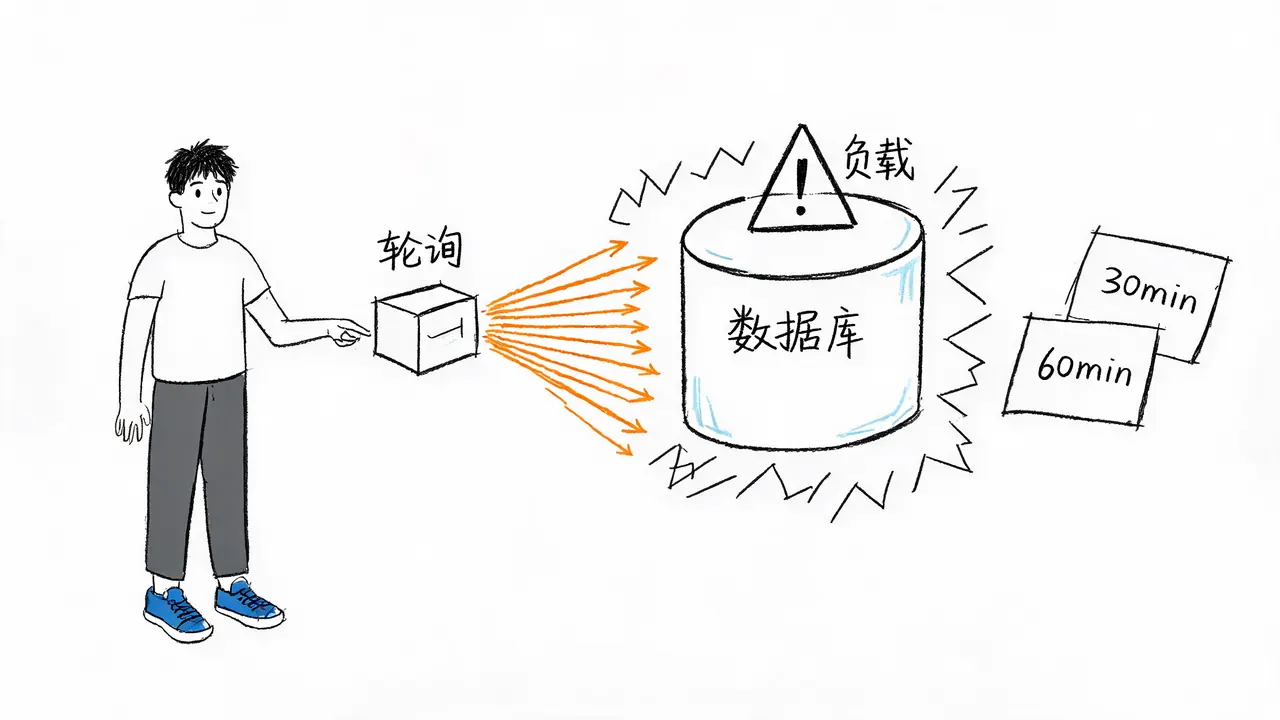
- 难以处理动态延迟: 如果业务规则变得复杂,例如“普通用户超时 30 分钟取消,VIP 用户超时 60 分钟取消”,定时任务很难灵活处理这种每个对象延迟时间都不相同的动态需求。你需要为不同的延迟时间设置多个定时任务,或者在轮询时进行复杂的逻辑判断,代码维护成本极高。
延迟队列的优势:精准且高效
延迟队列的本质是一个能控制消息释放时间的容器。其工作流程如下:
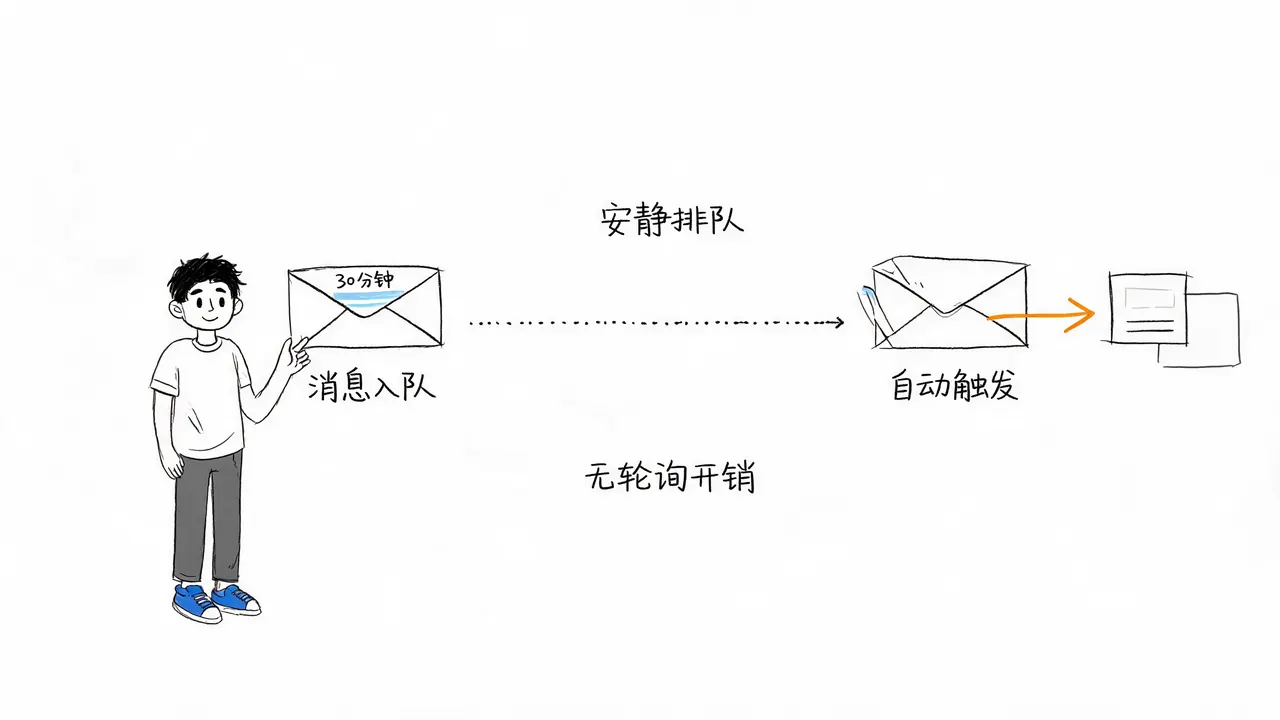
- 消息入队:当用户下单时,系统不需要去数据库写命令,而是往延迟队列里扔一条消息,并给它贴上一个“30 分钟后生效”的标签。
- 安静排队:这条消息会在队列中等待,消费者在时间未到之前,根本拿不到它。
- 自动触发:只有当 30 分钟的倒计时结束,这条消息才会自动弹出,交给系统去执行取消订单的操作。
优势总结:
- 无轮询开销:整个过程不需要反复查询数据库,极大降低了数据库压力。
- 资源节约:不浪费计算资源进行无效扫描。
- 灵活精准:每个消息可以独立设置延迟时间,轻松应对 VIP 与普通用户的差异化需求。
场景对比:该请谁出场?
在真实的业务分工中,这两者各有各的主场。看懂了这层分工,下次再遇到需要“等一会儿再执行”的需求,你就能做出正确选择。
✅ 适合使用【定时任务】的场景
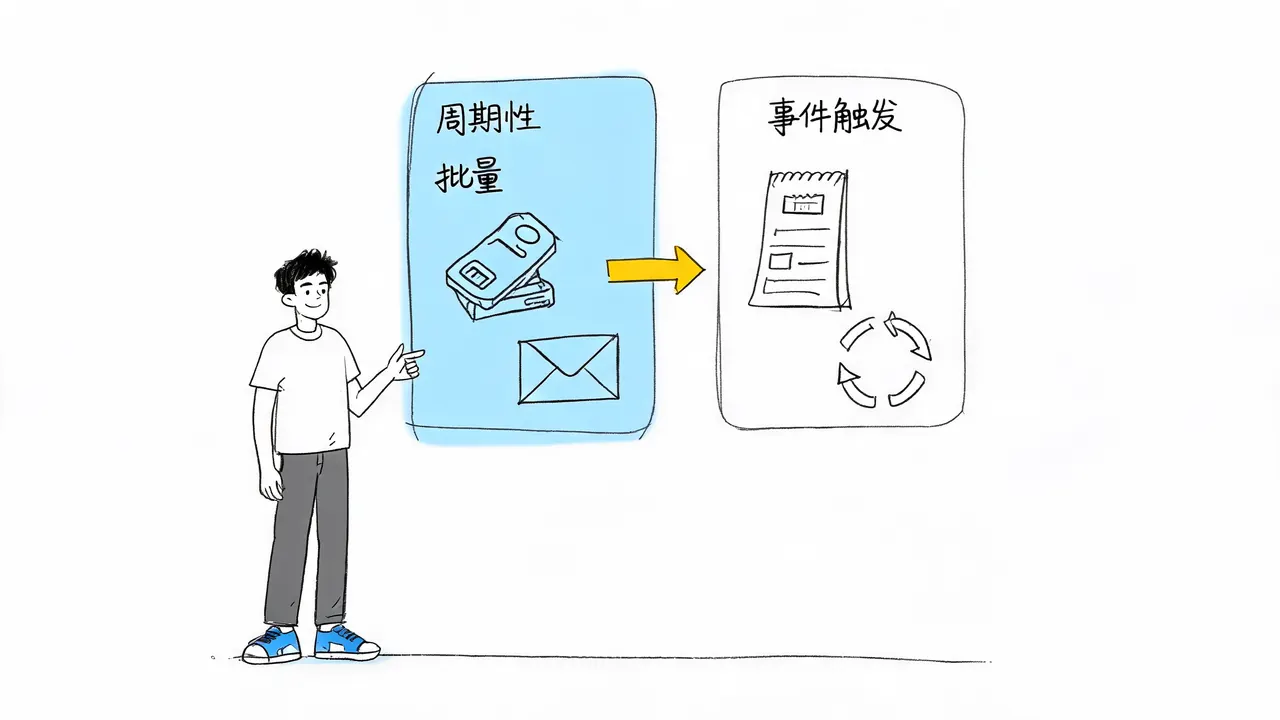
这类任务通常具有周期性和批量处理的特征,解决的是“什么时间该做什么事”的规律性问题。
- 每天凌晨 3 点备份数据库。
- 每周一早上发送周报邮件。
- 定期清理日志文件。
✅ 适合使用【延迟队列】的场景
这类任务通常由单个事件触发,且每个任务的延迟时间可能不同,解决的是“某件事发生后隔多久去收尾”的精确倒计时问题。
- 订单 30 分钟未支付自动关闭。
- 接口调用失败后,1 分钟后重试。
- 用户注册后,24 小时发送欢迎邮件。
- 预约服务开始前 10 分钟发送提醒。
总结
- 定时任务:基于固定时间表的周期性执行,适合批量、规律性的后台作业。
- 延迟队列:基于事件触发的精确倒计时,适合动态、个体化的延迟处理。
不要试图用定时任务去模拟延迟队列的功能,这不仅代码复杂,更会拖垮系统性能。根据业务需求选择合适的工具,才是构建高性能后端系统的关键。