分布式定时任务可靠性设计:从脑裂防护到故障转移的完整方案
在分布式系统中,定时任务(Scheduled Tasks)是处理对账、数据同步、报表生成等核心业务的关键组件。然而,随着集群规模的扩大,简单的单机定时任务框架(如 Spring Task)已无法满足高可用需求。许多开发者在面试或实际生产中常面临一个核心难题:如何保证分布式定时任务既不会因节点故障而漏执行,也不会因网络分区或并发调度而重复执行?
本文基于生产环境实战经验,深入剖析分布式定时任务面临的典型失效场景,并构建一套涵盖调度层、执行层及监控层的完整可靠性设计方案。
分布式定时任务的典型失效场景
在引入分布式调度框架(如 XXL-JOB、Elastic-Job)之前,必须明确“可靠性”的定义:保证任务在正确的时间,以正确的次数,执行正确的逻辑。
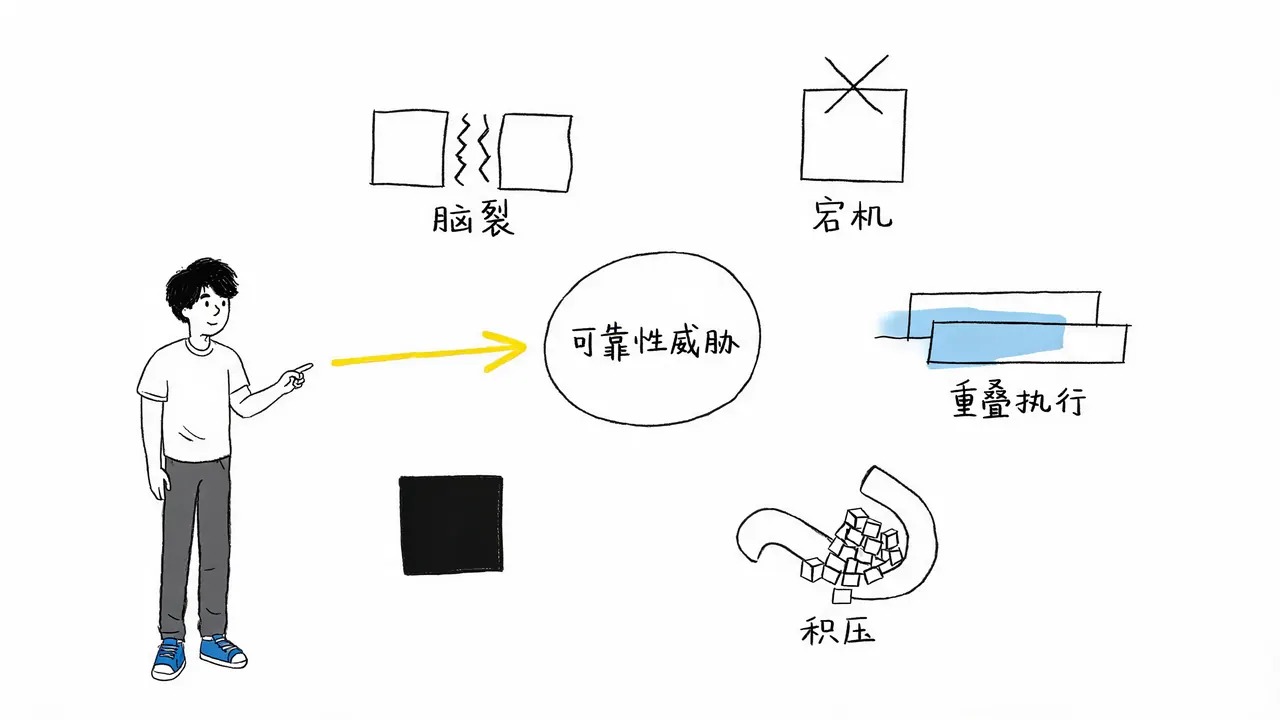
在实际生产环境中,以下五类失效场景是定时任务可靠性的主要威胁:
- 调度中心脑裂(Split-Brain): 当调度中心集群发生网络分区时,可能出现两个节点同时认为自己是“主节点”的情况。这会导致同一任务被同时触发,造成重复调度。
- 执行节点宕机导致任务遗漏: 如果执行任务的节点在任务运行中途突然宕机,且调度中心未能及时感知到执行结果,该任务将处于“丢失”状态,导致业务数据不一致(如对账漏单)。
- 任务耗时超过调度间隔(重叠执行): 若任务执行时间(如 30 分钟的对账任务)长于调度间隔(如 15 分钟一次),上一个任务尚未执行完毕,下一个任务实例已被触发。这会导致并发执行,引发数据混乱和资源耗尽。
- 任务积压与阻塞: 当大量任务排队等待执行,且存在慢任务或死锁任务时,后续的高优先级任务(如核心对账)可能被阻塞,导致关键业务延迟。
- 执行异常无感知: 任务执行失败或超时,但缺乏有效的监控和告警机制,导致问题长期潜伏。
核心可靠性设计:三层架构模型
要解决上述问题,不能仅依赖框架的默认配置,而需要从调度层、执行层和运维监控层三个维度构建防御体系。
第一层:调度层——防止脑裂与重复调度
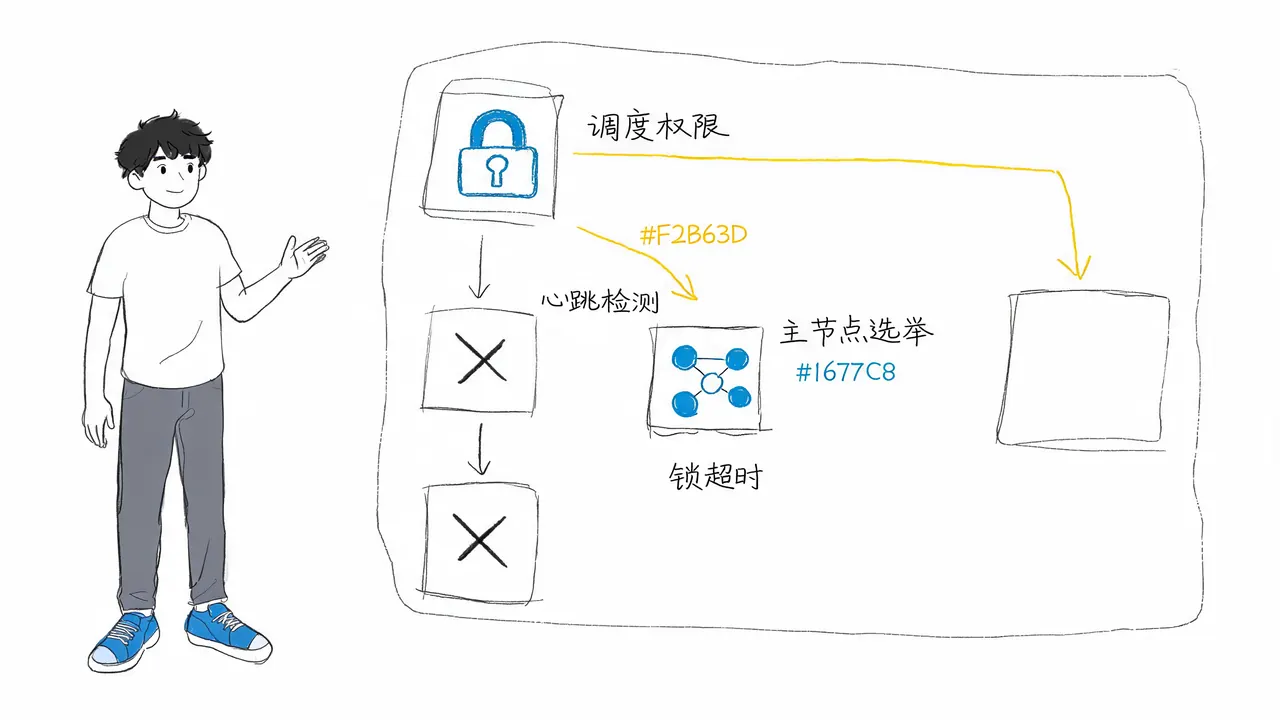
调度层的核心目标是确保同一时刻只有一个活跃调度中心在触发任务。
- 主从仲裁机制: 采用数据库分布式锁或 ZooKeeper 等协调服务进行主节点选举。只有持有锁的节点才具备调度权限。
- 心跳检测与锁超时:
主节点定期更新心跳(如更新数据库中的
last_heartbeat时间戳)。若主节点宕机,锁将在超时后自动释放,其他从节点竞争成为新主节点。 - 避免双主调度: 在获取锁失败时,从节点应停止调度行为,仅作为备份。新主节点接管后,需重新加载任务状态,确保调度连续性。
第二层:执行层——幂等、防重叠与故障转移
执行层的核心目标是确保任务执行的原子性、唯一性和可恢复性。
1. 任务幂等性设计
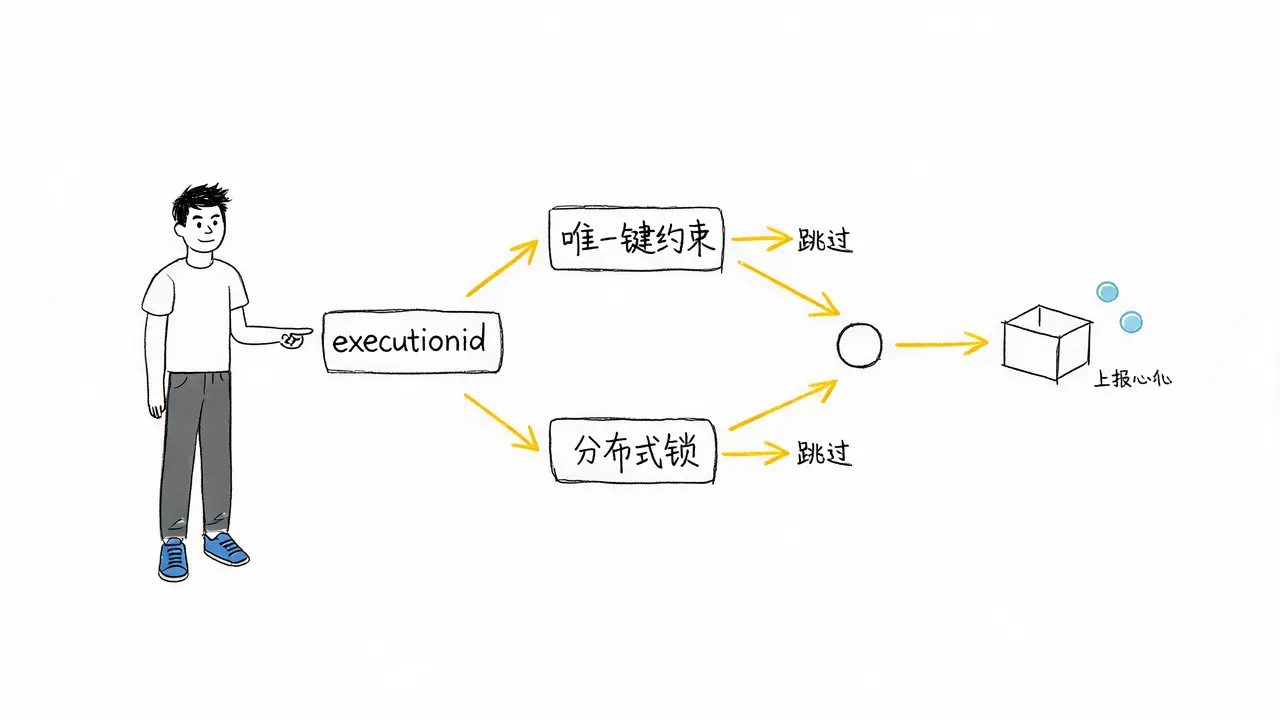
- 唯一执行 ID:
每次任务触发时,生成全局唯一的
execution_id。 - 数据库唯一键约束:
在执行任务逻辑前,先向数据库插入一条包含
execution_id的记录。若插入失败(违反唯一键约束),则说明该任务已执行过,直接跳过。这是防止重复出账、重复写入的最底层保障。
2. 防止任务重叠执行
- 分布式锁控制: 在任务执行前获取分布式锁(如 Redis 锁或数据库锁)。
- 锁时长策略: 锁的过期时间应大于任务的最大预期执行时间。若获取锁失败,说明上一个任务仍在执行,本次调度应直接跳过(Skip),而非排队等待,以避免资源堆积。
3. 故障转移与重试
- 超时检测: 执行节点需定期向调度中心上报心跳。若超过最大执行时间未上报,调度中心标记该任务为“失败”或“超时”。
- 自动转移: 调度中心检测到任务失败后,可将其重新分配给其他健康节点执行。
- 位点恢复(Checkpoint): 对于增量同步类任务,应在执行过程中记录处理位点(如最后处理的 ID 或时间戳)。失败重试时,从位点继续执行,而非从头开始,避免数据重复处理。
第三层:运维监控层——分级隔离与降级兜底
生产环境的稳定性不仅取决于代码逻辑,还取决于资源管理和异常兜底。
1. 任务分级与资源隔离
- 线程池隔离: 将任务分为“核心任务”(如支付对账)和“非核心任务”(如日志清理)。核心任务使用独立的线程池,非核心任务共用线程池。
- 防止阻塞: 若非核心任务出现死锁或慢查询,仅影响其所属线程池,不会阻塞核心任务的执行。
2. 监控与告警
- 关键指标:
- 任务成功率
- 执行超时率
- 任务积压数量(等待时长)
- 调度中心节点状态
- 多级告警: 设置阈值告警,如任务等待时长超过 5 分钟、执行时长超过预期 2 倍时,触发即时告警。
3. 极端场景降级方案
- 调度中心全挂:
若调度中心集群完全不可用,执行节点应启用本地备用调度。
- 基于本地数据库锁保证单节点执行。
- 降级为低频执行(如从 1 分钟一次降为 10 分钟一次)。
- 优先保障核心任务不中断,非核心任务暂停。
纯数据库实现方案:不依赖框架的可靠性设计
如果面试中被问到“不使用任何分布式调度框架,仅用数据库和业务代码如何实现”,可参考以下设计思路:
- 调度表设计:
创建
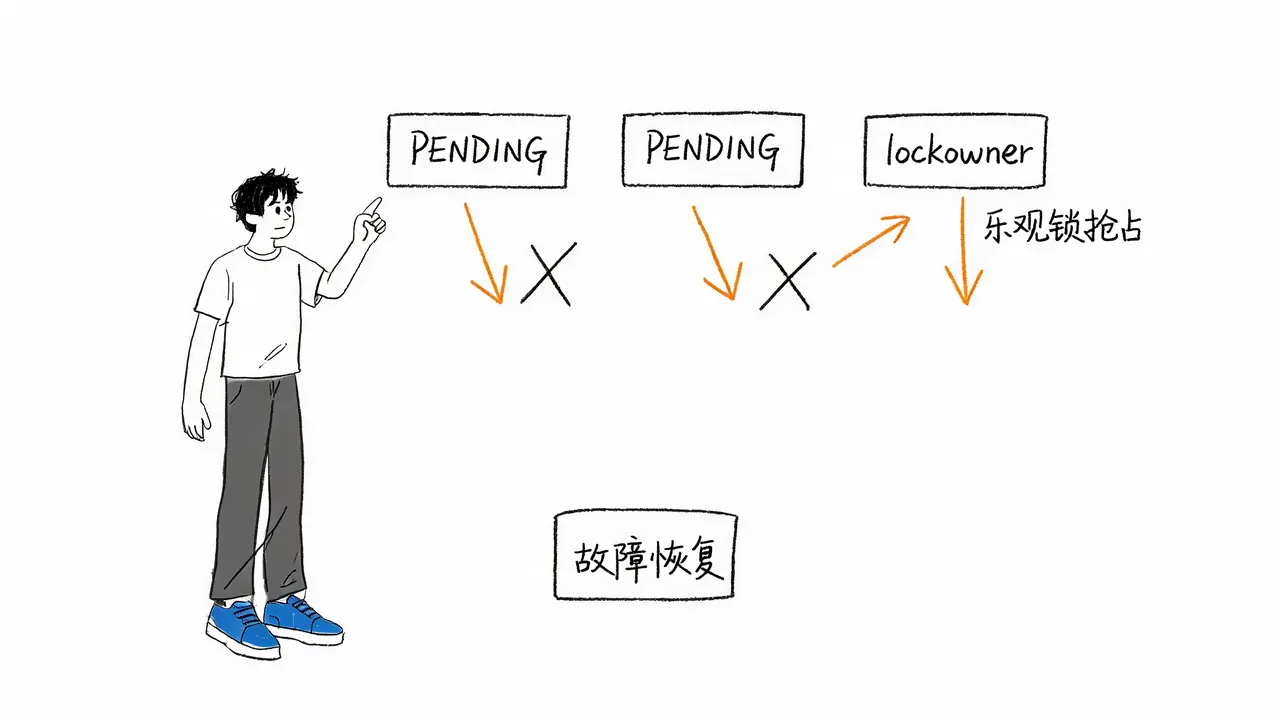
task_schedule表,包含task_id,next_run_time,status,lock_owner,lock_expire_time等字段。 - 调度逻辑:
- 所有节点定期查询
next_run_time <= now()且status = 'PENDING'的任务。 - 使用
UPDATE ... WHERE id = ? AND status = 'PENDING'进行乐观锁抢占。 - 更新
lock_owner为当前节点 ID,lock_expire_time为当前时间 + 超时阈值。 - 仅更新成功的节点执行任务。
- 所有节点定期查询
- 执行与状态更新:
- 执行成功后,更新
status = 'SUCCESS',计算并更新next_run_time。 - 执行失败后,更新
status = 'FAILED',记录错误信息,并设置重试策略。
- 执行成功后,更新
- 故障恢复:
- 定期扫描
status = 'RUNNING'且lock_expire_time < now()的任务,将其重置为PENDING,以便其他节点重新抢占。
- 定期扫描
总结:从“会用框架”到“设计可靠性”
分布式定时任务的可靠性设计,是区分初级后端与资深后端的重要分水岭。
- 初级后端:通常只关注如何配置 XXL-JOB 或 Quartz,认为“配置了集群就不会重复”。
- 资深后端:能够识别脑裂、节点宕机、任务重叠、积压等真实生产痛点,并能从调度仲裁、执行幂等、超时转移、分级隔离、故障降级等多个维度,徒手设计出一套完整的可靠性方案。
在实际工作中,建议遵循以下原则:
- 幂等是底线:无论调度层如何设计,执行层必须保证幂等。
- 监控是眼睛:没有监控的定时任务等于盲飞。
- 降级是兜底:极端情况下,保证核心业务可用比完美执行更重要。
通过深入理解这些核心逻辑,开发者不仅能从容应对面试中的“夺命连环问”,更能构建出真正稳定、可靠的分布式任务调度系统。