有了MySQL,为什么AI还需要向量数据库?
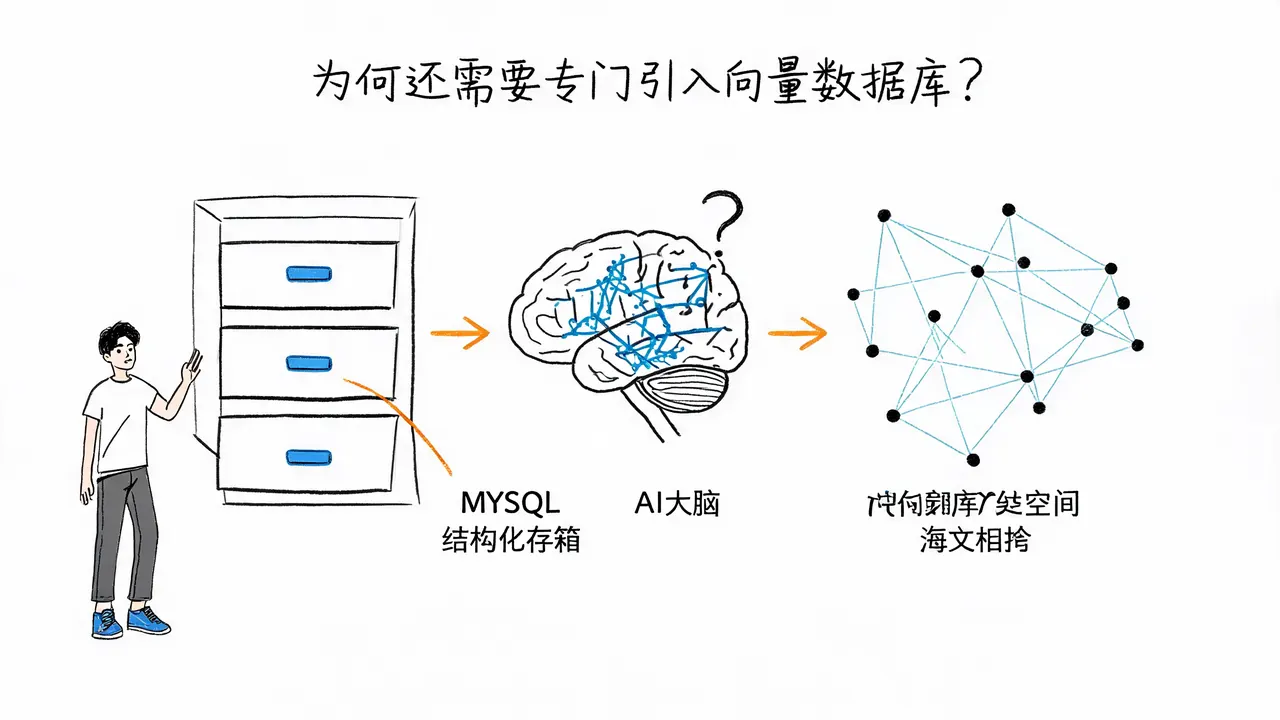
在AI时代,我们依然广泛使用MySQL,但为何还需要专门引入向量数据库?简单来说,MySQL是存储纯结构化事实的“货架”,而向量数据库则更擅长存储向量并寻找最相似的内容。
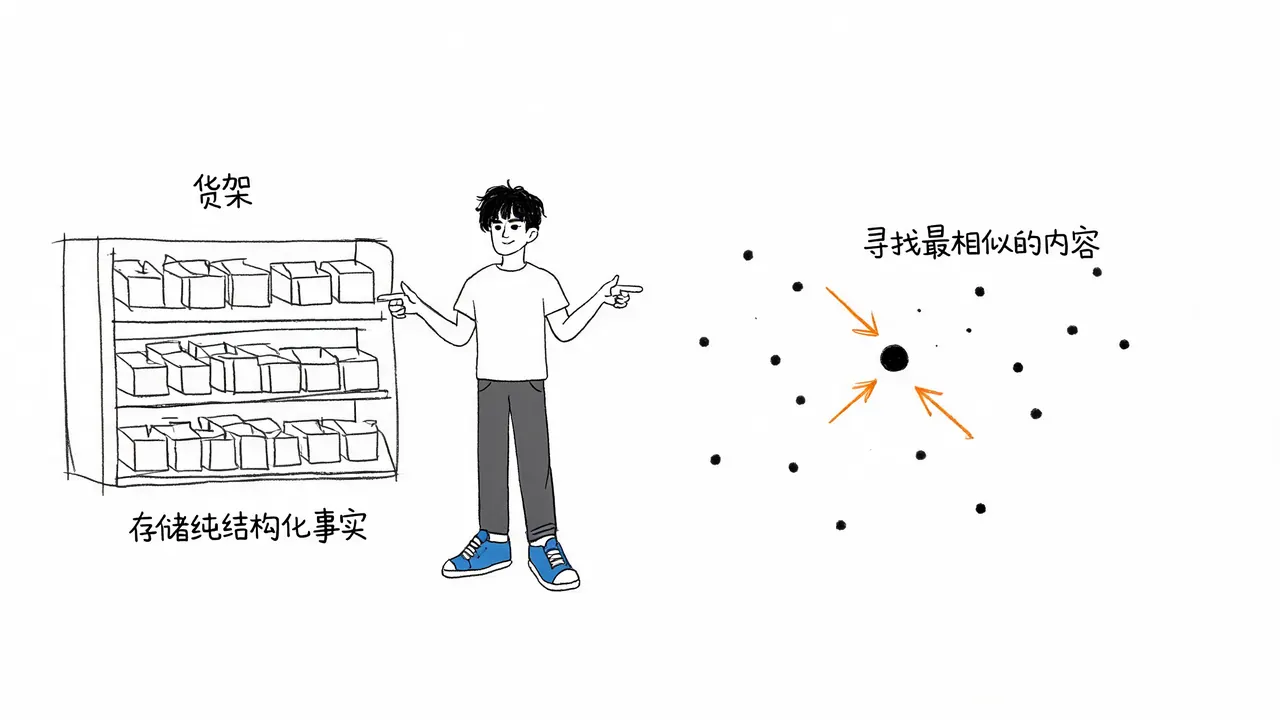
理解这两者的本质区别,是看懂现代AI大模型如何检索知识、如何找到相关资料来回答问题的关键。本文将深入探讨它们存储数据的差异、AI语义查询场景下传统数据库的局限性,以及语义是如何转化为可计算数字的。
``MySQL:严谨的结构化数据档案柜
你可以将MySQL想象成一个极其严谨的超级档案柜或电话簿。它最核心的优势在于处理结构化数据,例如用户的年龄、商品的价格、订单的时间等。
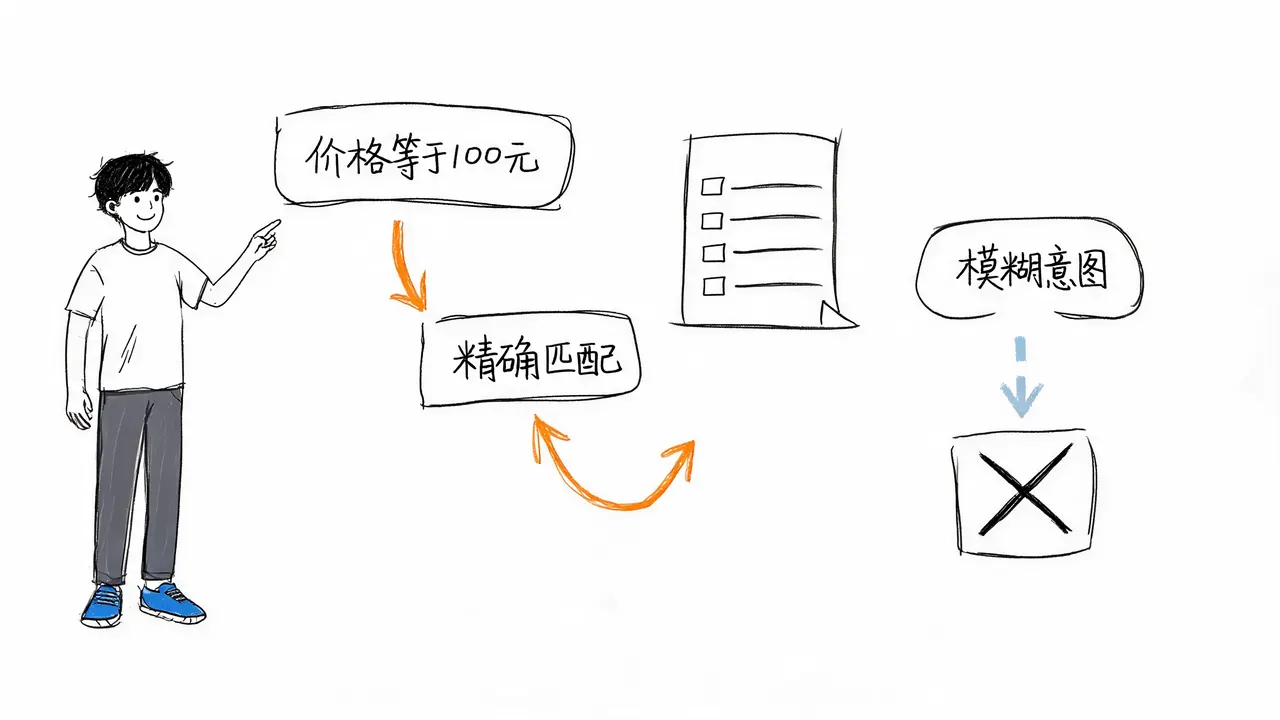
当你进行查询时,MySQL擅长按照明确的字段和条件进行精确匹配。例如,查询“价格等于100元的商品”,它能瞬间将符合条件的详细记录提取出来。
然而,MySQL的局限性在于它无法理解自然语言背后的语义。如果你直接询问“百元左右的宝贝”,MySQL本身并不知道这句话的含义,因为传统关系型查询处理的是明确的条件匹配,而非自然语言中的模糊意图。
AI面临的挑战:非结构化数据与语义检索
AI处理的世界远不止严丝合缝的表格。图片、声音、长篇大论的文章等非结构化数据构成了AI的主要输入。
当你在AI助手中询问“怎么退货”时,你希望它能找出包含“退换货流程”、“商品寄回”等意思相近的文档,而不是死板地只搜索包含“退货”这两个字的句子。这种寻找“意思最像”的需求,被称为语义检索。
如果仅将这些内容转换为向量并存入普通数据库,却缺乏适合向量检索的索引,面对数百万条数据时,系统可能需要进行海量的距离计算,导致查询成本极高,效率低下。
向量数据库:寻找“最像”的邻居
这时,向量数据库便登场了。它不关心数据“是谁”,更关心数据“像谁”。其核心工作流程如下:
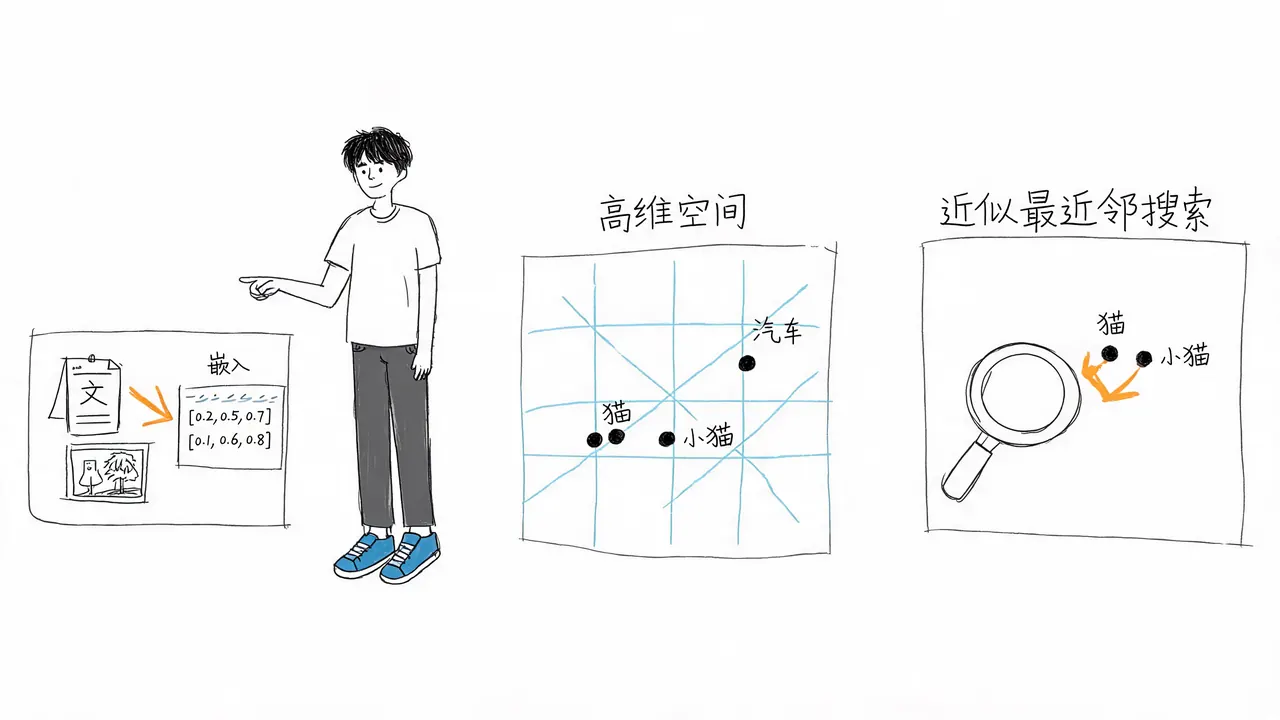
- 嵌入(Embedding): 通过AI的嵌入模型,将文字、图片等非结构化数据“翻译”成一串包含几百甚至上千个数字的数组。这串数字代表了数据的特征。
- 高维空间中的邻近性: 在合适的Embedding模型下,语义相近的内容,其对应的向量在数学空间中也会彼此接近。例如,“猫”和“小猫”的向量可能紧紧挨着,而离“汽车”的向量则较远。
- 近似最近邻搜索(ANN): 当你在向量数据库中搜索时,系统先将你的问题通过Embedding模型转化为向量,然后在高维数学空间中快速找出距离最近的那些点(即最相似的内容)。
这种技术不要求字面完全一致,在合适的模型支持下,甚至可以处理不同表达方式、不同语言之间的语义关联,从而将最相关的知识快速返回给大模型。
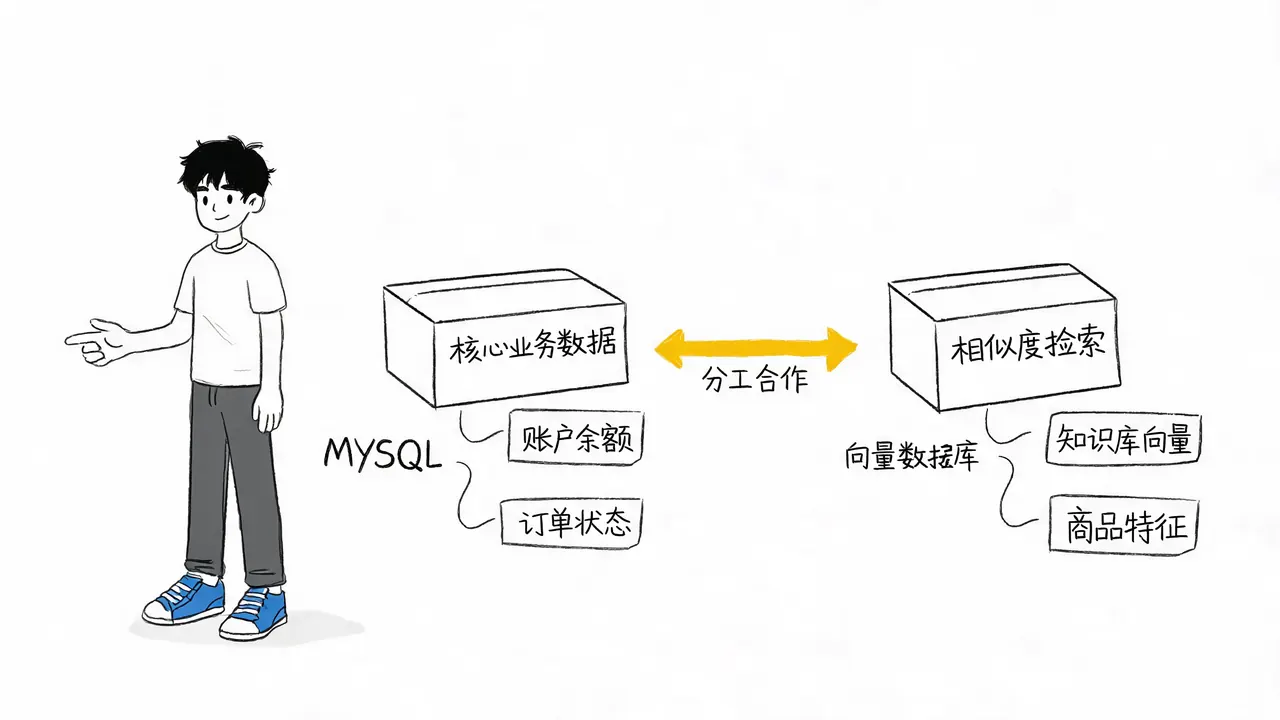
分工合作:MySQL与向量数据库的协同
听到这里,你可能会问:向量数据库如此智能,是否会淘汰MySQL?
答案是否定的。两者是分工合作的关系:
- MySQL:负责管理核心业务数据,如账户余额、订单状态等。这些数据需要严格的结构化查询和事务能力(ACID),是现代业务系统的重要基石。
- 向量数据库:更适合管理知识库向量、商品特征等需要相似度检索的数据,用于智能推荐、语义搜索等场景,是AI知识库和语义搜索系统的重要组件。
结语:看清AI应用的数据运转逻辑
目前,许多新的技术架构甚至将这两种能力融合在一个系统中,实现结构化查询与向量搜索的同时完成。
- MySQL 擅长解决“按明确条件找到数据”的问题。
- 向量数据库 擅长解决“从海量数据里找到最相似内容”的问题。
看清这条分工线,你就能更好地理解现代AI应用底层的数据运转逻辑。