面试官:线程池配置优化与生产环境卡死排查实战
在近期的后端面试中,一位拥有四年经验的候选人面对“线程池如何配置优化”的问题,给出了看似标准的答案:核心线程数匹配 CPU 核数,最大线程数留足冗余,使用有界队列缓冲流量,设置非核心线程超时回收,并配置拒绝策略。他认为这样既能控制资源又能扛住并发。
然而,当面试官抛出一个真实的线上事故场景时,这位候选人陷入了沉默。
线上事故复盘:无声的线程池瘫痪
假设你们的核心订单服务,其异步处理线程池严格按照“最佳实践”配置。压测时峰值任务处理平稳,日常运行也一切正常。但在大促期间,下单接口响应逐渐变慢,最终导致大面积超时。
排查发现以下诡异现象:
- 资源占用正常:服务实例 CPU 占用率不高,数据库也没有压力。
- 任务堆积严重:异步任务处理不过来,队列中堆满了待处理任务。
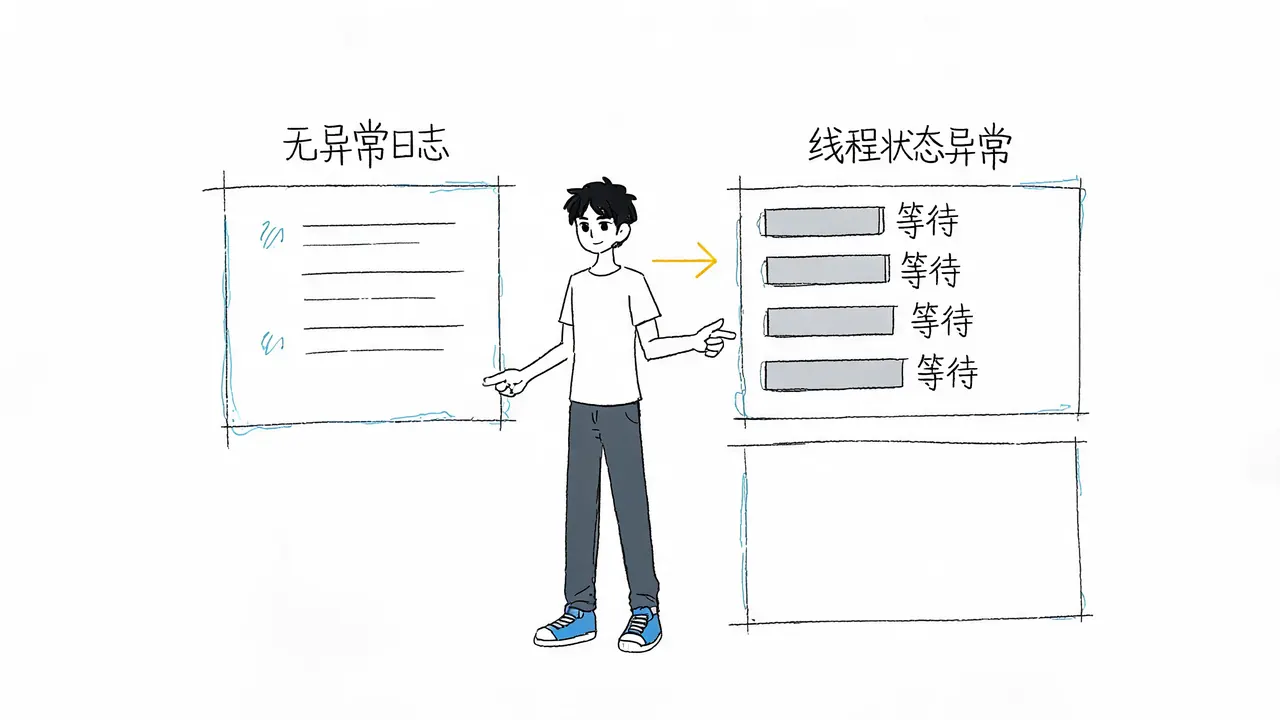
- 线程状态异常:线程池内的所有线程都卡在“等待”状态,既不干活也不报错。
- 无异常日志:核心线程未被销毁,也没有抛出任何错误日志,整个异步链路彻底瘫痪。
- 临时恢复手段:只能依靠重启服务来临时恢复。
面对这种“线程池悄无声息集体卡死”的场景,候选人猜测可能是任务内有阻塞操作。但面试官追问:任务逻辑自测无误,也没有慢 SQL,为何线上偶发全池线程集体卡住?流量一冲,队列迅速堆满,系统越积越慢。
核心问题:在线上遇到这种线程池集体卡死时,如何快速定位根因、止损,并设计真正稳定可靠的线程池方案?难道每次都要靠重启服务来“续命”吗?
为什么这个问题能筛出高手?
这道题考察的不仅仅是“会不会配线程池参数”,而是生产视角下的线程资源全生命周期管控与风险排查思维。
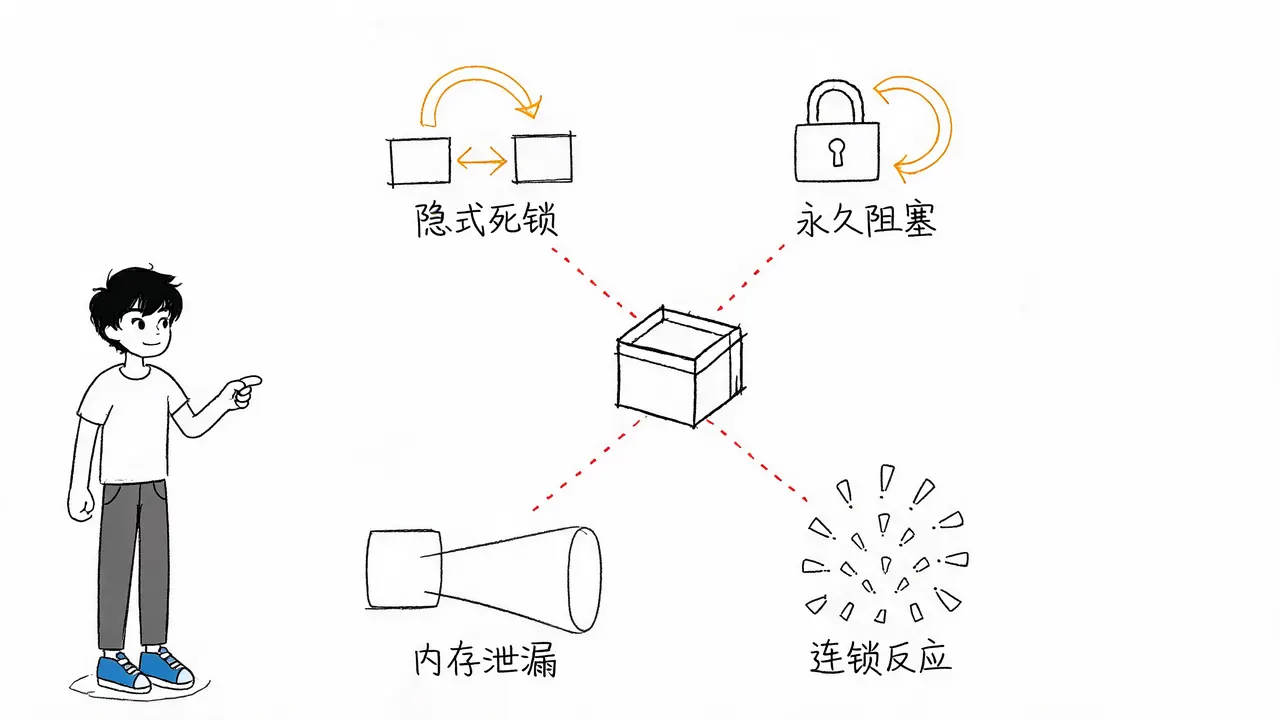
许多开发者背熟了线程池的七大参数,认为配置好核心线程数和最大线程数就万事大吉。然而,线程池是一个隐蔽的“幽灵陷阱”。以下因素可能在低并发时毫无感知,一旦到达峰值就会引发灾难:
- 任务内隐式死锁:逻辑复杂导致的死锁。
- 线程永久阻塞:未设置超时的远程调用或锁等待。
- ThreadLocal 内存泄漏:导致线程无法复用或内存溢出。
- 拒绝策略连锁反应:不当的拒绝策略导致上游雪崩。
一个能稳住服务并发能力的后端工程师,必须建立三层防御体系。
第一层防御:业务分级与精细化池隔离
避免单一任务类型拖垮全服务线程资源,核心在于隔离与管控。
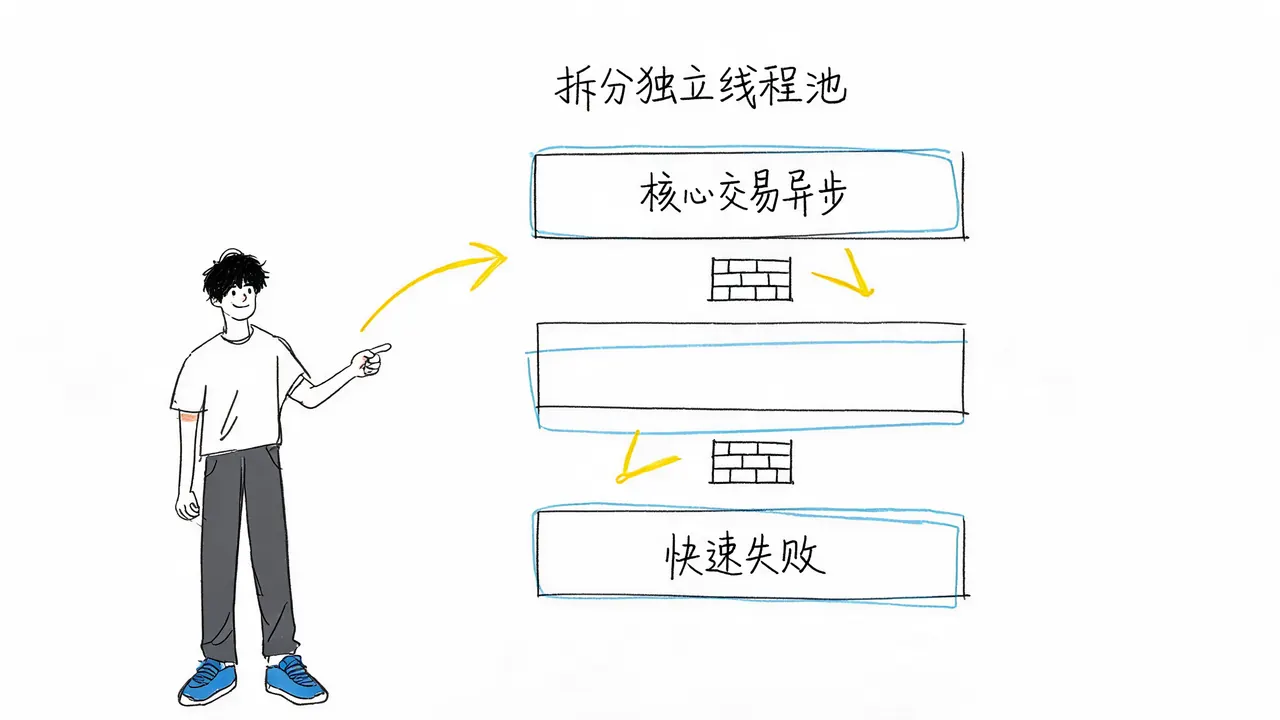
1. 拆分独立线程池
将不同优先级的业务拆分到独立的线程池中,各自独立配置参数与拒绝策略:
- 核心交易异步:高优先级,独立资源池。
- 后台运营任务:中优先级,独立资源池。
- 日志上报/非核心任务:低优先级,独立资源池。
2. 核心任务严格管控
- 禁止无超时远程调用:在线程池任务内执行远程调用必须设置合理的超时时间。
- 禁止嵌套线程池提交:避免线程互相等待导致死锁。
- 禁止无线等待锁:所有锁操作必须有超时机制。
- 目标:从根源避免线程永久阻塞。
3. 非核心任务降级策略
- 快速失败:当队列满时,直接丢弃任务或快速失败。
- 资源保护:绝不挤占核心线程资源,确保核心链路可用。
第二层防御:兜底监控与故障熔断
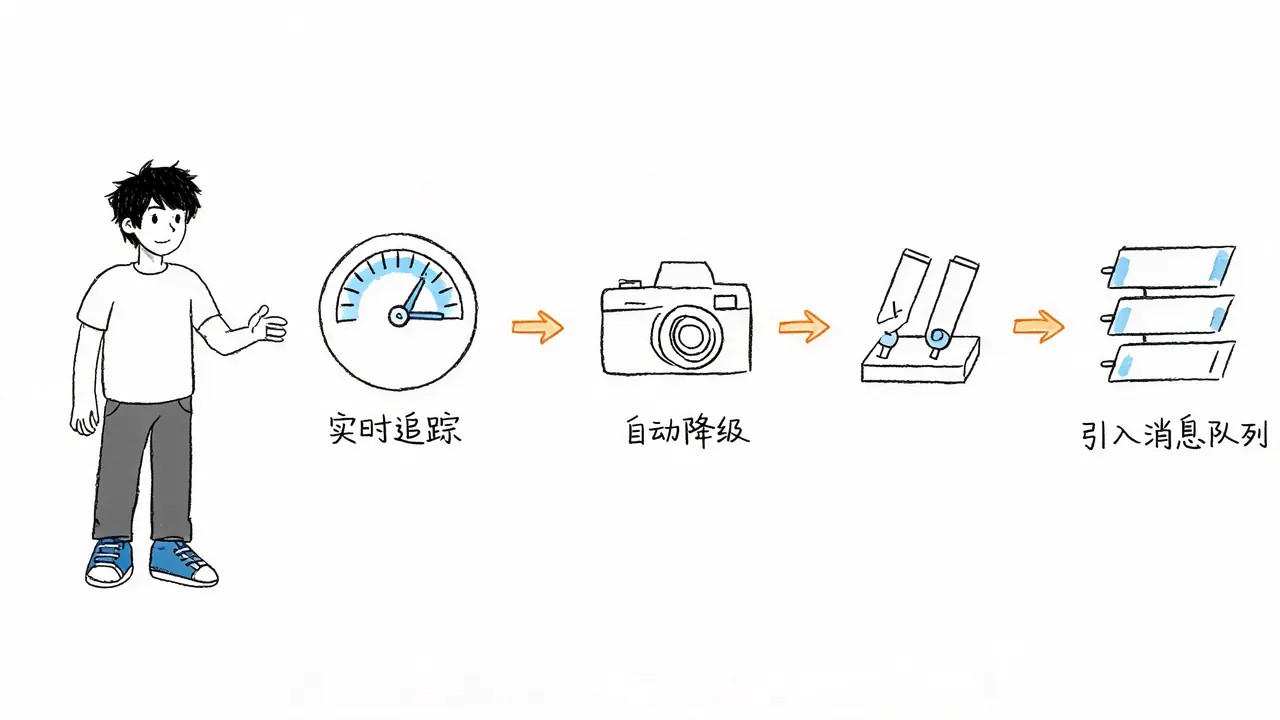
建立线程池全维度监控体系,实现从“被动重启”到“主动防御”的转变。
1. 实时追踪核心指标
- 活跃线程数:监控当前正在执行任务的线程数量。
- 队列堆积长度:监控待处理任务的数量,预警积压。
- 任务执行时长:追踪平均和最大执行时长,识别慢任务。
- 拒绝次数:监控任务被拒绝的频率。
- 线程阻塞占比:关键指标,用于发现线程卡死。
2. 自动告警与快照留存
- 当核心指标超过预设阈值时,自动触发告警。
- 自动留存线程栈快照:在异常发生时自动 dump 线程栈,为事后排查提供第一手证据。
3. 接入熔断机制
- 自动降级:当任务阻塞率或超时率超过阈值,自动降级非核心任务的提交。
- 停止入队:在极端情况下,临时停止新任务入队,避免持续堆积拖垮整个服务。
4. 长任务强制中断
- 配置长任务强制中断机制,对超时长运行的任务主动终止,避免单任务永久占用线程资源。
第三层防御:架构层优化
从架构层面降低卡死风险,实现根本性的稳定性提升。
1. 引入消息队列(MQ)
- 压力转移:在核心异步链路中引入 MQ,将线程池内部队列的压力转移到外部 MQ。
- 解耦削峰:从架构上避免单服务内线程池堆积引发的级联故障。
2. 线程池统一托管与标准化
- 统一配置:避免各业务随意创建线程池,导致资源失控。
- 统一监控:集中监控所有线程池状态。
- 统一策略:标准化拒绝策略和异常处理逻辑,消除风险遗漏。
3. 专项压测与排查
- 大促前演练:在核心时段前进行线程池专项压测。
- 阻塞点排查:重点排查潜在的阻塞点。
- 预留冗余:宁可预留少量线程冗余,也绝不允许线程池集体卡死引发核心链路瘫痪。
总结:从参数配置到工程思维
这道面试题的本质,是考察开发者是否从“会配七个参数”升级为“设计全生命周期线程资源管控体系”的工程思维。
- 普通开发:认为调整核心线程数就是线程池优化的全部。
- 高级工程师:深知在复杂的业务任务与并发场景面前,线程池是一把双刃剑。一个任务阻塞的细节没把控好,就可能引发线程池卡死,进而导致全面瘫痪的严重生产事故。
真正的专业,不在于背诵参数,而在于建立业务分级、监控熔断、架构优化的三层防御体系,确保在高并发场景下服务的稳定与可靠。