线上频繁 Full GC 排查指南:从命令执行到体系化治理
在 Java 后端面试中,“线上服务频繁 Full GC 导致卡顿,如何排查并优化?”是一道经典的高频考题。许多拥有数年经验的开发者往往能熟练背诵 jstat、jmap 等命令,但在面对“线上核心服务不敢随意 Dump”、“慢速内存泄漏难以溯源”或“流量突增导致 GC 雪崩”等真实生产场景时,却往往缺乏系统性的应对策略。
真正的 GC 排查能力,不仅仅是会敲命令,更在于能否在保障业务连续性的前提下,快速定位根因并落地长效优化方案。本文将从面试考察的核心逻辑出发,拆解 GC 问题的边界、排查手段及生产落地细节,构建一套完整的 JVM 治理体系。
面试考察的核心分水岭
面试官提出“频繁 Full GC”问题时,考察的重点并非候选人是否知道 jmap -dump 或 jstat -gcutil 的用法,而是考察其是否具备体系化的排查思维和生产环境的安全意识。
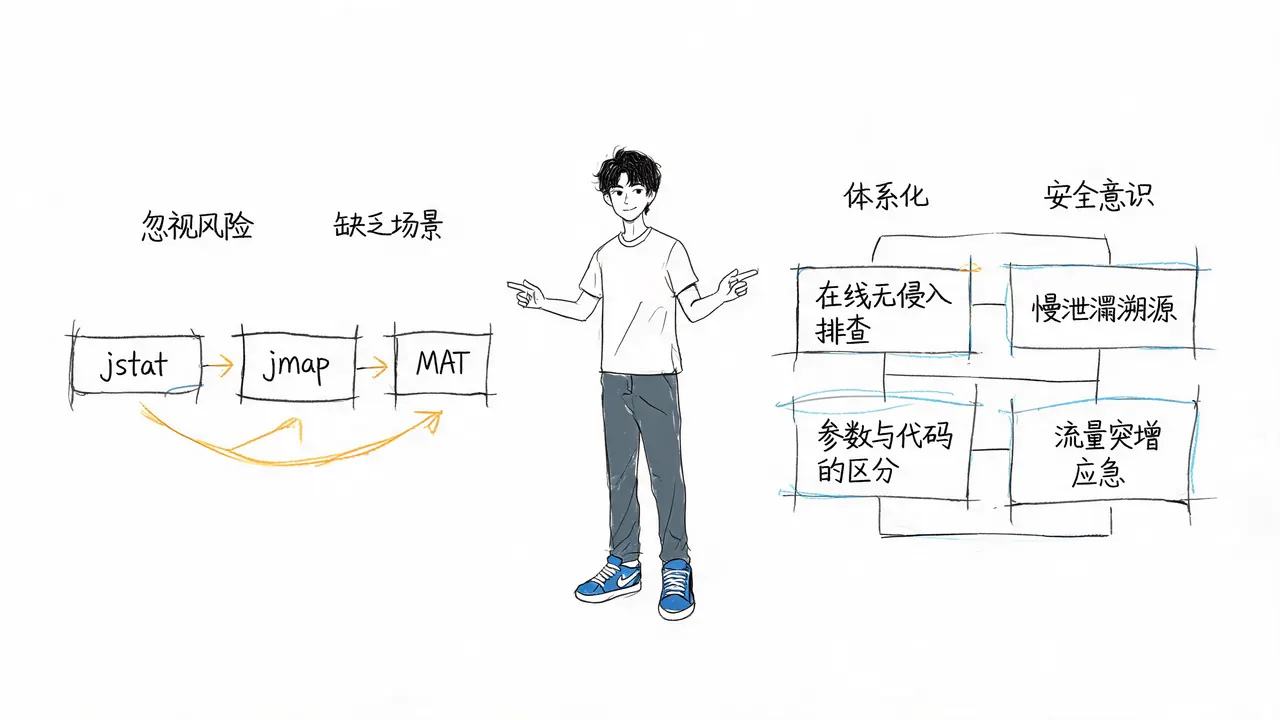
常见的初级回答通常是:“先用 jstat 看 GC 情况,再用 jmap Dump 堆快照,最后用 MAT 分析大对象。”这种回答存在两个致命缺陷:
- 忽视线上风险:在大堆内存场景下,执行
jmap -dump会导致 STW(Stop The World)停顿数分钟,极易引发业务雪崩。 - 缺乏场景覆盖:未考虑偶发大对象、内存泄漏、元空间溢出、GC 参数不合理及第三方包 Bug 等复杂场景。
高阶回答需要体现对以下核心场景的掌控力:
- 在线无侵入排查:如何在不停服、不 Dump 的情况下定位问题?
- 慢泄漏溯源:如何区分业务代码泄漏与中间件依赖包泄漏?
- 参数与代码的区分:如何快速判断是 GC 参数配置不当(如年轻代过小)还是代码逻辑问题?
- 流量突增应急:当对象创建速度超过回收速度时,如何快速止损?
第一层:明确 GC 问题的边界与失效场景
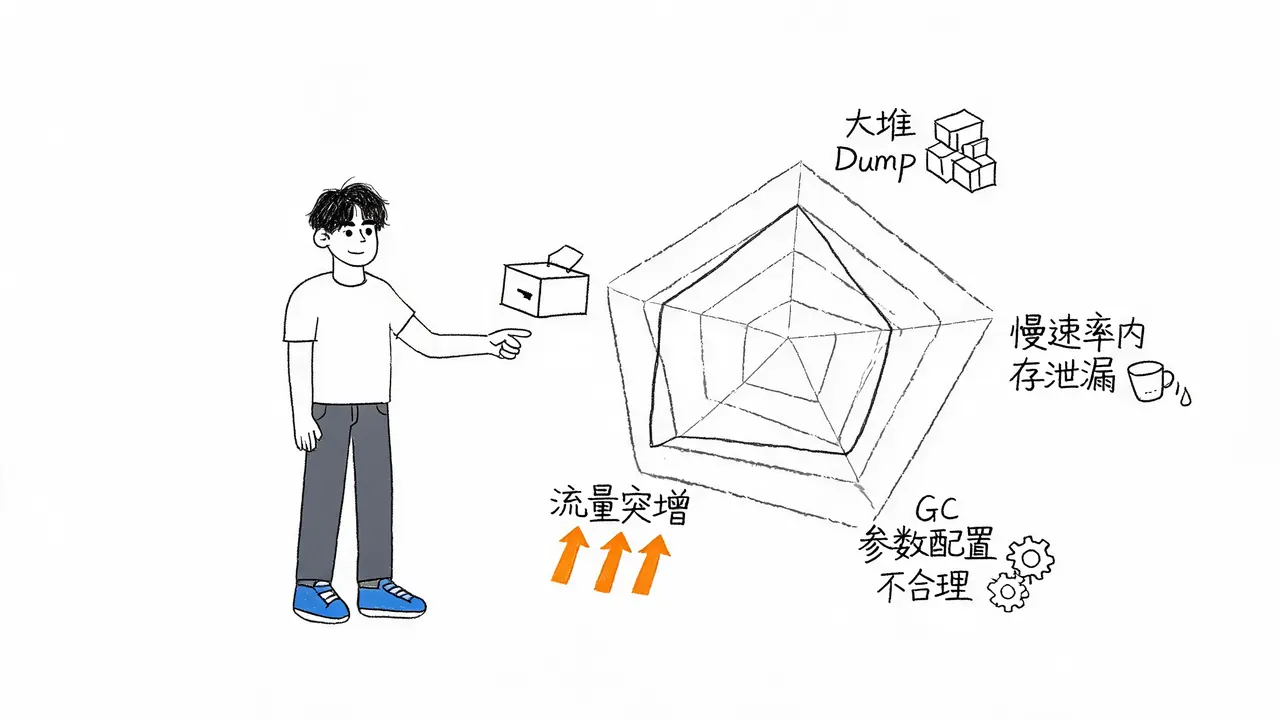
GC 问题的本质是内存占用、GC 耗时与业务吞吐量之间的平衡。解决 GC 问题不能简单依赖“加内存”,必须覆盖以下常见的失效场景:
- 大堆 Dump 导致业务停顿:核心服务禁止随意 Dump,需采用轻量级在线排查手段。
- 慢速率内存泄漏:内存每天增长几百兆,几天才触发一次 Full GC,难以通过单次快照定位。
- GC 参数配置不合理:例如年轻代过小导致对象提前晋升老年代,或元空间未设上限导致动态扩容触发 Full GC。
- 流量突增导致 GC 过载:大促期间对象创建速度远超 GC 回收速度。
- 堆外内存与元空间问题:堆外内存泄漏或元空间溢出常被误判为堆内存问题。
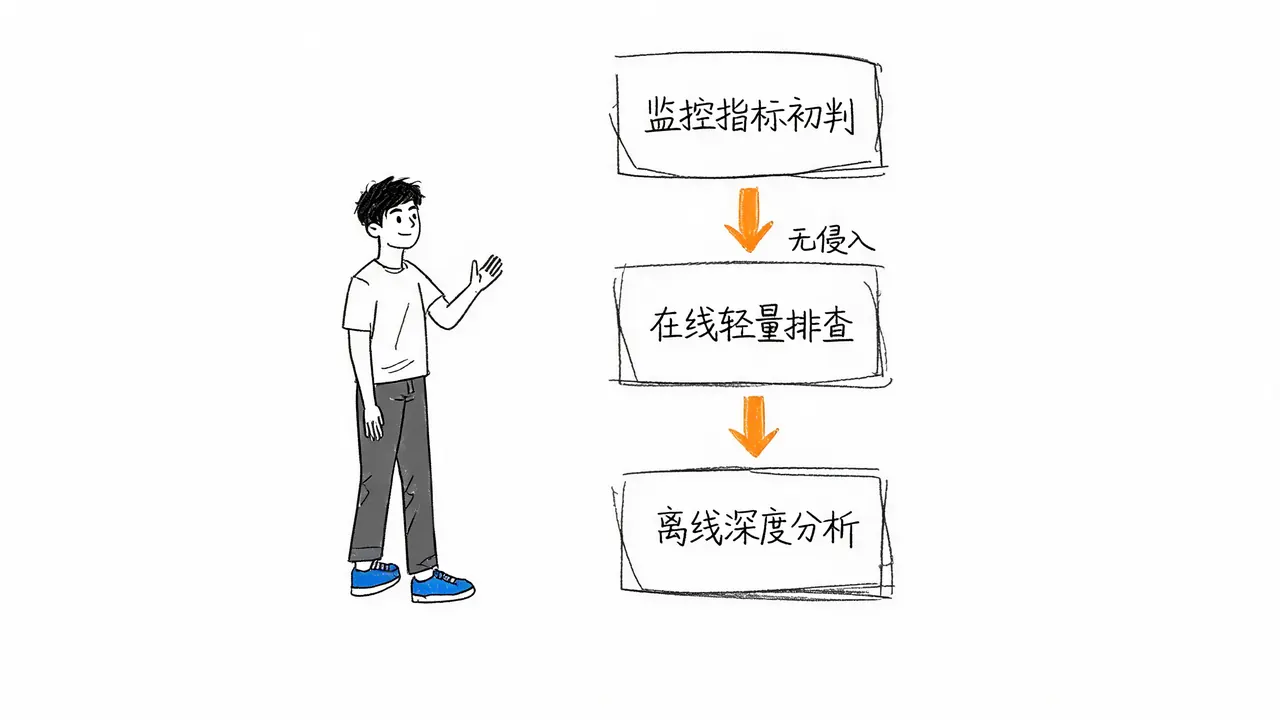
第二层:构建“监控初判 + 在线排查 + 离线分析”的排查基线
针对上述场景,建议建立一套标准化的排查流程,分为三个阶段:
1. 监控指标初判
通过监控平台观察 GC 类型和内存变化趋势,快速缩小问题范围:
- 老年代使用率持续上涨:疑似内存泄漏。
- 老年代单次暴涨:疑似大对象直接进入老年代。
- 元空间持续上涨:疑似类加载泄漏(如动态代理、脚本引擎滥用)。
- YGC 频繁且耗时变长:疑似年轻代设置过小,或 Survivor 区不足导致对象过早晋升。
2. 在线轻量排查(无侵入)
在确认问题方向后,使用轻量级命令进行在线诊断,避免业务中断:
jstat -gcutil <pid>:实时观察各代内存使用率和 GC 频率。jmap -histo:live <pid>:查看存活对象分布,快速识别大对象类型(注意:live参数会触发一次 Full GC,需谨慎使用,或在低峰期执行)。- 无侵入诊断工具:利用 Arthas 等工具查看对象分布、线程状态,不中断业务即可定位热点对象。
3. 离线深度分析
在低峰期或确认问题后,执行 Dump 进行深度分析:
- 区分泄漏源:通过 MAT 分析 Dump 文件,区分是业务代码、中间件还是第三方包导致的泄漏。
- 流量突增优化:若确认为流量问题,需结合代码优化,如使用对象池、字符串复用等技术减少对象创建。
第三层:生产落地的异常处理与长效优化
排查出根因后,生产环境的落地需要关注应急分级、参数标准化及监控告警。
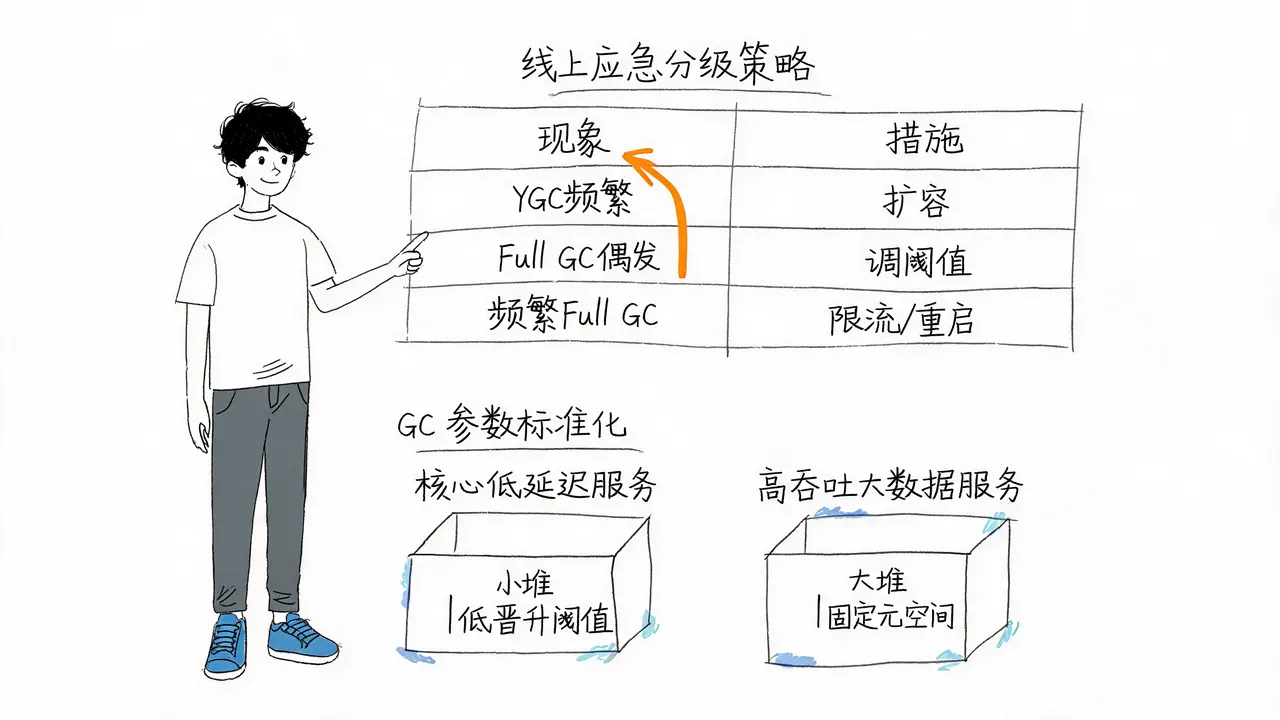
1. 线上应急分级策略
根据 GC 现象采取不同的止损措施:
- YGC 频繁:优先扩容年轻代,或检查是否有大量短生命周期对象。
- Full GC 偶发:调整晋升阈值(
MaxTenuringThreshold),避免对象过早进入老年代。 - 频繁 Full GC:立即限流非核心接口,降低对象创建压力;极端情况下考虑滚动重启服务。
- 慢泄漏溯源:
- 记录每日内存增长曲线。
- 结合发布记录,对比不同版本的内存快照。
- 定位泄漏版本后,逐类排查代码。
2. GC 参数标准化
避免“一刀切”的参数配置,按业务类型制定模板:
- 核心低延迟服务:
- 调小堆内存,减少 GC 停顿时间。
- 设置较低的晋升阈值,保持年轻代活跃。
- 高吞吐大数据服务:
- 调大堆内存,提高吞吐量。
- 增大年轻代,减少 Full GC 频率。
- 元空间设置:
- 设置固定的
MaxMetaspaceSize上限,避免动态扩容触发 Full GC。
- 设置固定的
3. 监控告警与极端降级
- 多级告警:监控 GC 频率、耗时、各代内存增长率及类加载数量。
- 自动降级:当 GC 告警超过预设阈值时,自动关闭非核心业务接口,优先保障核心交易链路的稳定性。
总结
大厂后端工程师与普通后端在 GC 问题上的区别,在于能否徒手设计一套完整的治理方案。这套方案应包含:
- 指标初判:通过监控快速定位问题类型。
- 在线清查:使用无侵入手段安全排查。
- 深度定位:低峰期 Dump 分析根因。
- 应急止损:限流、重启等快速恢复手段。
- 长效调优:参数标准化、监控告警及代码优化。
只有具备这种体系化的思维,才能扛得住线上业务压力、慢泄漏排查、流量突增冲击及参数配置异常等各种复杂场景,真正解决“频繁 Full GC”这一痛点。