完美JSON直接执行?当心AI工程陷阱:格式正确不等于业务正确
大模型返回了一段字段齐全、类型匹配的完美 JSON,但这并不意味着你可以直接调用接口执行。将“格式正确”等同于“业务正确”,是 AI 落地过程中一个极其隐蔽且危险的工程陷阱。
`` 是摘要与正文的分隔标记,请保留。结构化输出的本质:严格的“打字员”
在机制上,大模型的结构化输出(Structured Output)主要充当了一个非常严格的“打字员”角色。
当开发者要求模型必须提供订单号(字符串类型)和金额(浮点数类型)时,结构化输出的核心价值在于强行堵住了大模型“说废话”的嘴。它保证了输出不会包含“好的,这就为您处理”这类无关文本,也不会因为少输出一个右括号导致后端解析器崩溃。
在需要从杂乱对话中提取参数以驱动工具的场景中,将数据按进确定的模具里确实是必不可少的一步。然而,数据能被顺利反序列化,与它能在业务线里安全流转,完全是两码事。
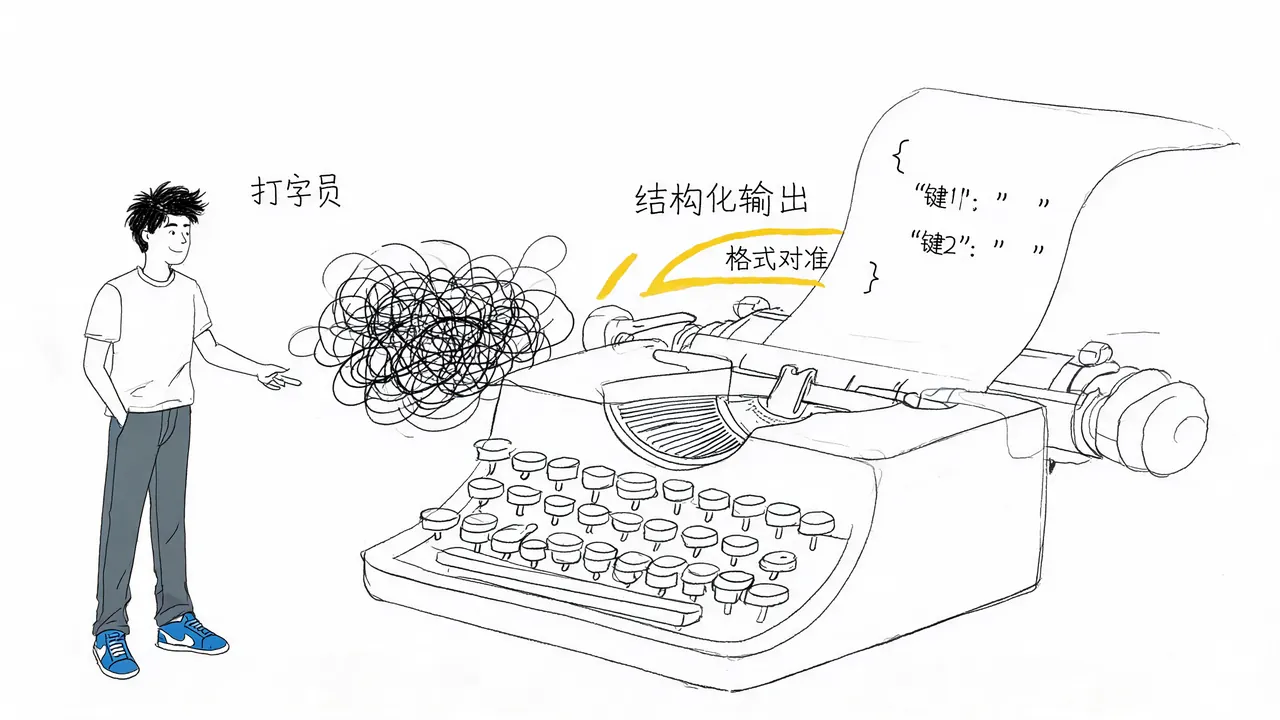
这就好比有人递给你一张格式规范、签字画押齐全的借条,但这并不能证明对方真的有钱还你。
为什么完美 JSON 依然极度危险?
以真实的退款工程场景为例,大模型生成的 JSON 中确实包含了一个合法的订单号,但这只是它根据上下文拼凑出来的一个“长得像订单号”的字符串。
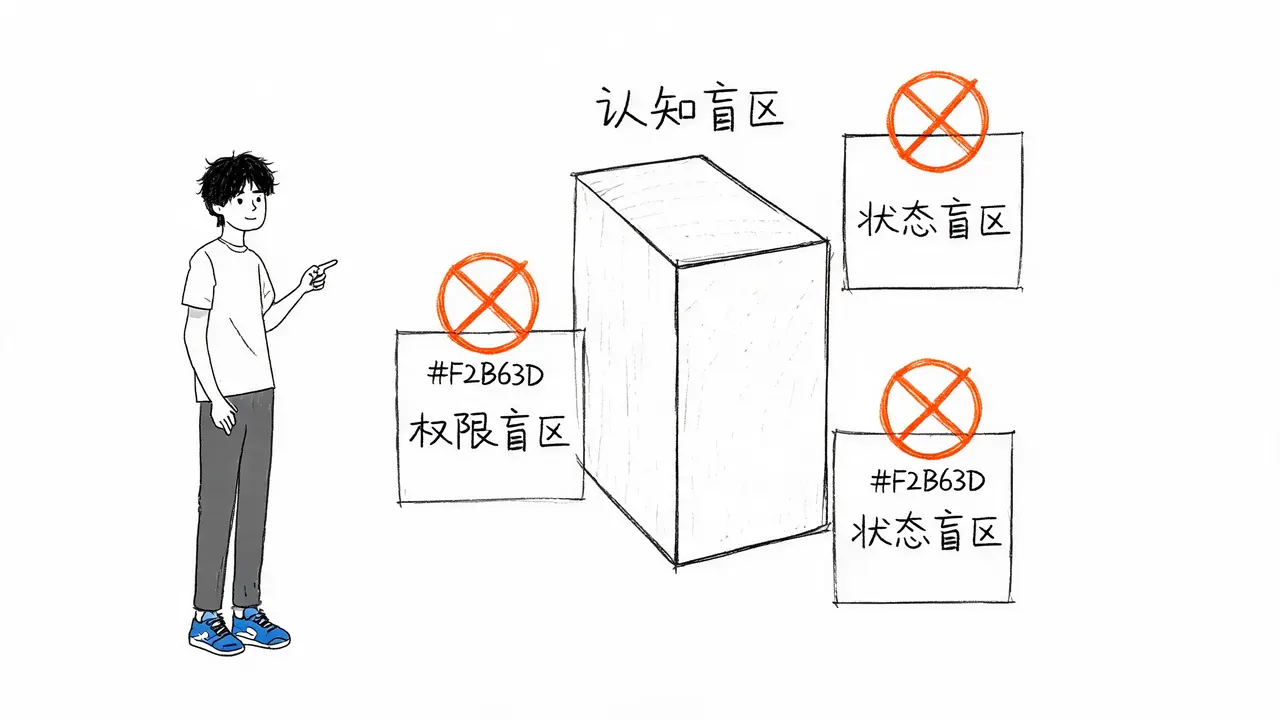
大模型并没有直接连接你的数据库,它存在以下根本性的认知盲区:
- 权限盲区:它不知道当前登录账号是否有权限操作这笔订单。
- 状态盲区:它不知道这笔订单是否已经退过款。
- 事实盲区:它填写的退款金额虽然符合数字类型,但不代表该金额小于用户的实际账户余额。
业务规则的互斥逻辑、系统的权限校验机制以及涉及底层事实的判断,都是大模型无能为力之处。因此,直接执行大模型生成的数据,系统面临着极大的业务风险。
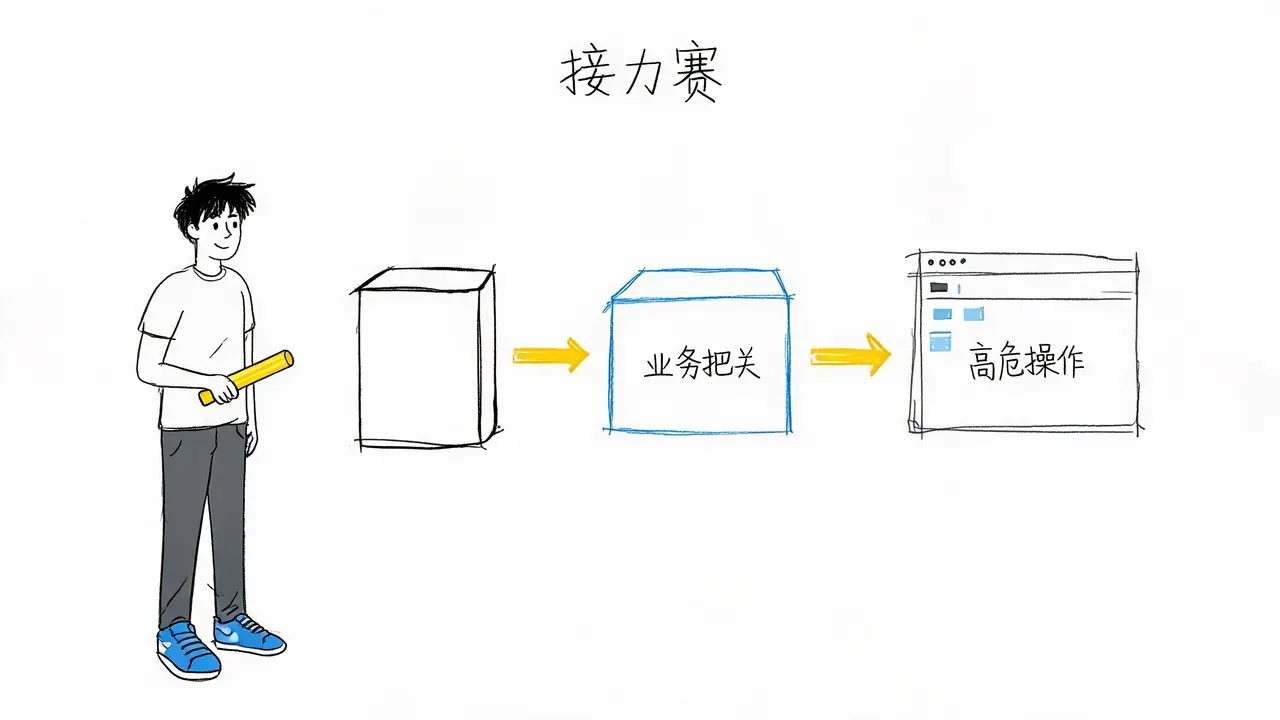
生产环境的安全执行链路:一场接力赛
在真正的生产环境中,稳妥的执行链路不能一步到位,而必须是一场“接力赛”:
第一棒:结构化输出(意图压缩)
- 任务:处理模糊意图,将用户发散的自然语言压缩成确定形状的参数字典。
- 职责:只负责“把话听懂”和“把格式对齐”。
第二棒:后端确定性代码(业务把关)
- 任务:拿到参数字典后,立即走传统的业务校验逻辑。
- 职责:
- 查库比对订单状态。
- 核验当前用户的权限风险。
- 计算金额是否匹配。
- 这是真正的业务把关环节。
第三棒:前端确认(高危操作授权)
- 适用场景:涉及资金流转或删除数据的高危操作。
- 任务:将解析出的关键信息推回前端,生成确认卡片。
- 职责:让用户亲自点击授权,完成最终确认。
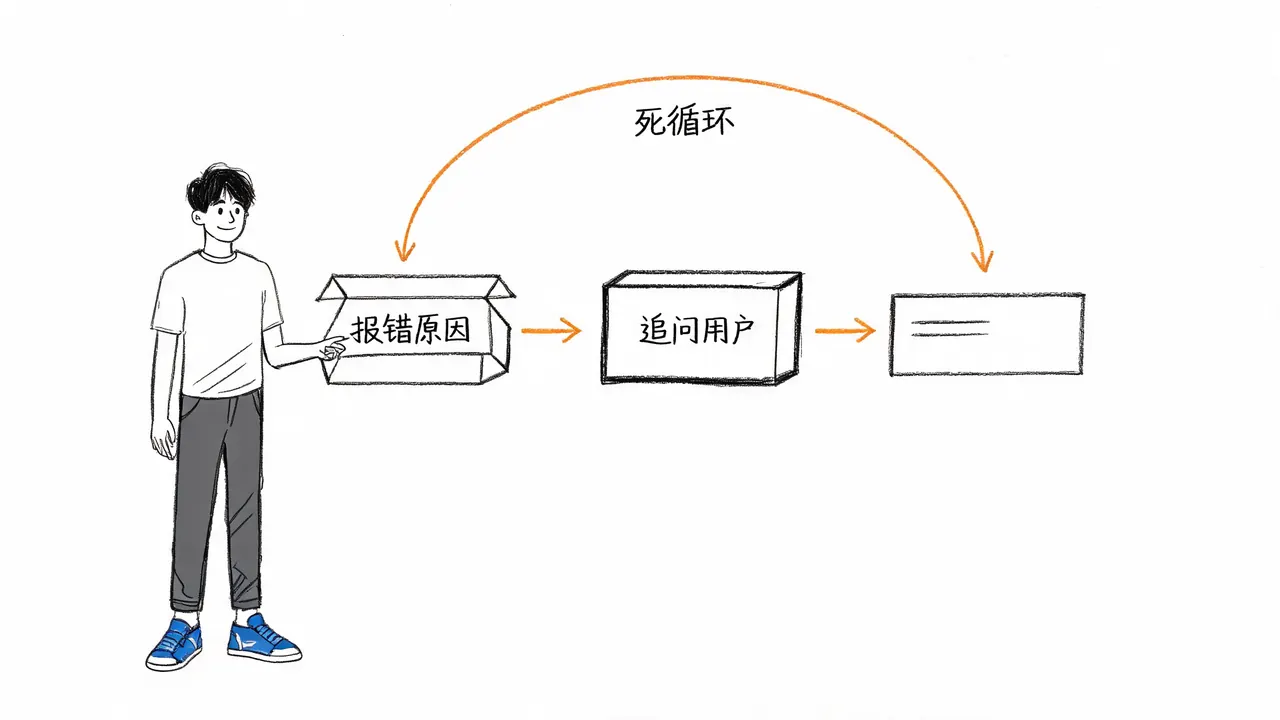
异常处理:避免死循环
如果在接力过程中,第二棒的后端代码发现数据不对劲(例如订单号根本不存在),该如何处理?
千万不要让系统带着原样的数据去死循环重试。
正常的工程做法是:
- 捕获后端拦截到的具体报错原因(如“订单未找到”)。
- 将该报错原因作为一段新的上下文,塞回给大模型。
- 让大模型拿着这个明确的结论去追问用户(例如:“是不是记错了单号?”)。
- 从而获取新的参数,重新进入流程。
结语:重新定义结构化输出的工程意义
我们必须清醒地认识到:结构化输出并没有消灭大模型的幻觉。
它真正的工程意义,只是把过去那种代码连读都读不懂的文本报错,包装成了一种我们可以用传统代码去拦截、去验证的参数错误。
- 工程的起点:让数据能够被成功解析。
- 系统的终点:保证数据能在业务规则里安全落地。
只有厘清这一边界,才能避免在 AI 落地过程中陷入“格式完美但业务崩坏”的陷阱。