Agent 开发实战:超时重试的正确姿势与幂等性设计
在 AI Agent 的开发实践中,工具调用的稳定性是系统可靠性的核心。许多开发者习惯在遇到接口超时或报错时,直接套用简单的重试循环。然而,这种“无脑重试”策略在涉及资金扣款、数据修改等带有副作用的操作时,极易引发重复执行、数据冗余等严重事故。
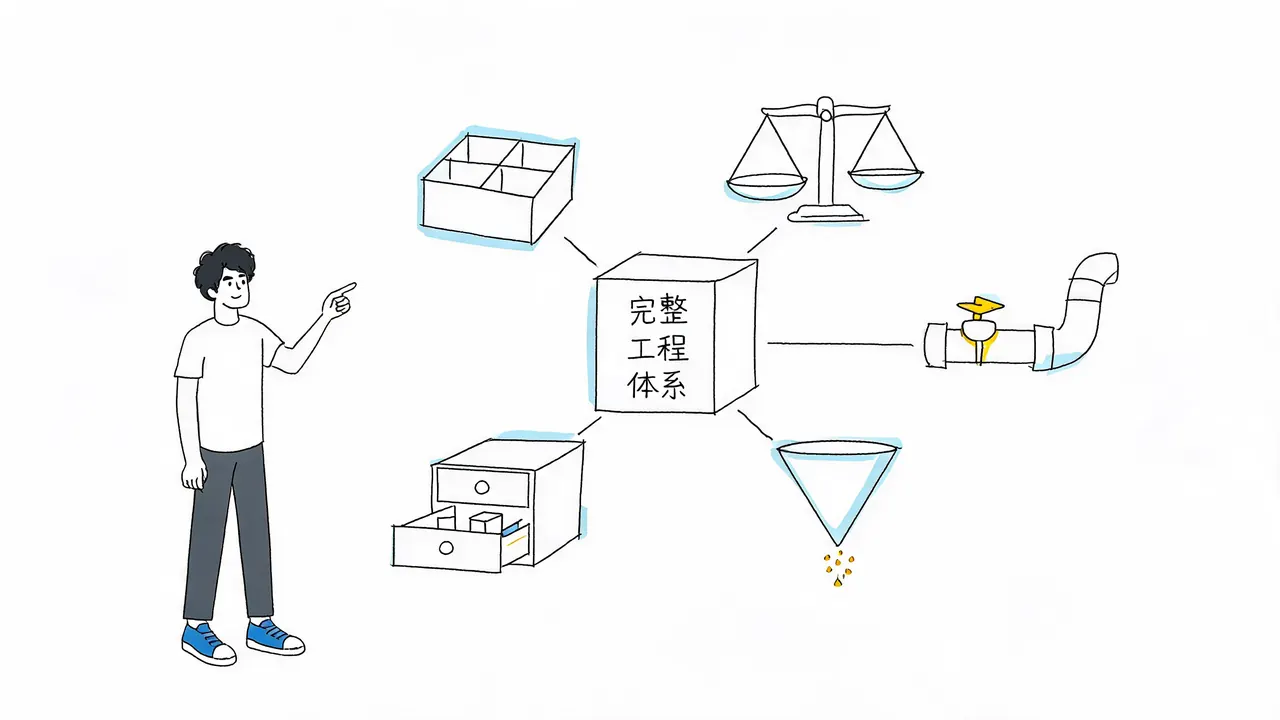
超时并不等同于失败,状态未知才是最危险的边界。要构建一套安全、高效的 Agent 执行链路,必须建立包含错误分类、幂等校验、状态回查、局部补偿以及熔断机制的完整工程体系。
`` 是摘要与正文的分隔标记,请保留。错误分类:重试的前提是明确失败原因
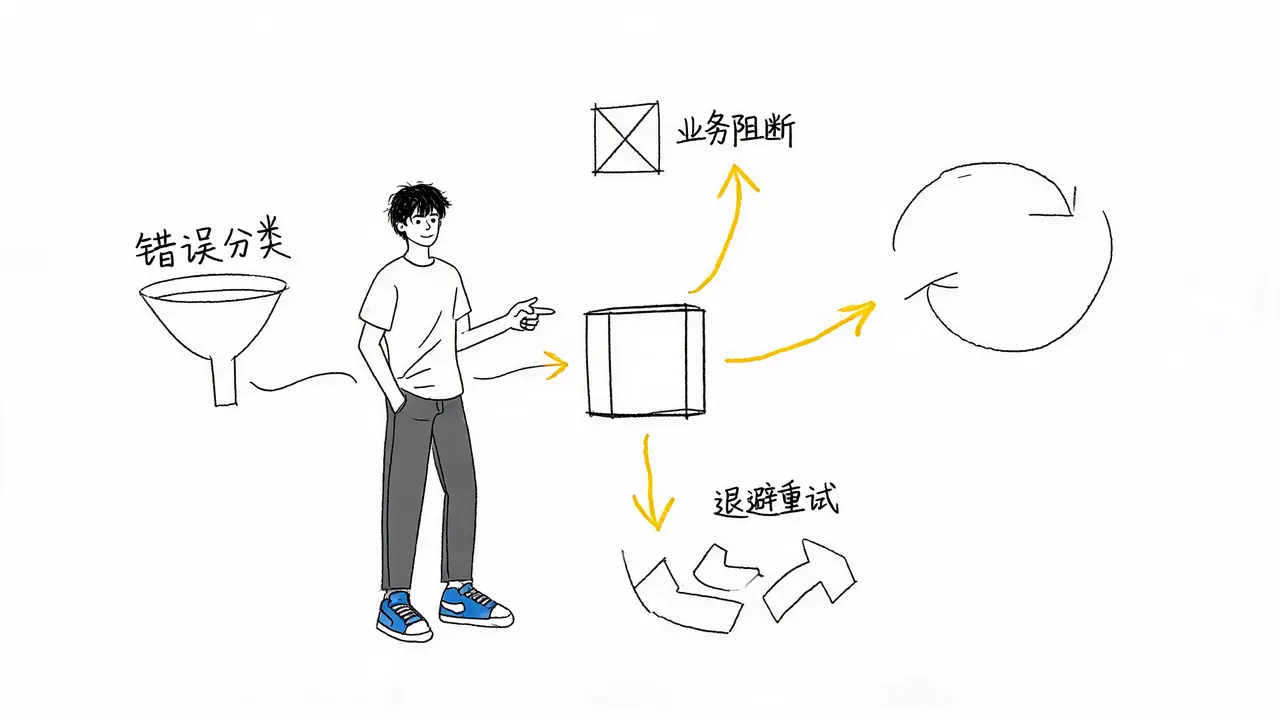
当 Agent 拿到一个调用报错时,第一步不是盲目等待或重试,而是进行错误分类。不同的错误类型需要截然不同的处理策略。
1. 业务阻断类错误
如果下游返回“权限不足”或“库存不足”,这属于明确的业务阻断。
- 处理策略:重试没有任何意义。
- Agent 动作:立即终止当前动作,执行备选路径,或直接向用户报告任务受阻。
2. 参数校验类错误
如果接口返回参数校验错误(例如:对方需要整型变量,而大模型生成了自然语言),死等也无法得到正确结果。
- 处理策略:利用模型的推理能力自我修正。
- Agent 动作:将带有错误断言的详细提示抛回给大模型,让其重新构造参数,然后发起新一轮请求。
3. 环境偶发故障
只有针对环境类的偶发故障(如瞬间网络抖动、接口临时限流),才适合使用退避重试(Backoff Retry)。
- 处理策略:配置合理的重试间隔。
- Agent 动作:让 Agent 等待一小会儿再试,大概率能顺利走通。
超时处理的特殊性:引入幂等机制
在所有网络异常中,超时报错的性质最为特殊。超时意味着 Agent 无法确定对方是否收到请求,也无法确定业务数据是否已落库。
对于发邮件、扣余额、修改核心数据等带有副作用的调用,遇到超时,Agent 的下一步动作绝不能是立刻重发,而必须引入幂等机制(Idempotency)。
幂等机制的工程实现
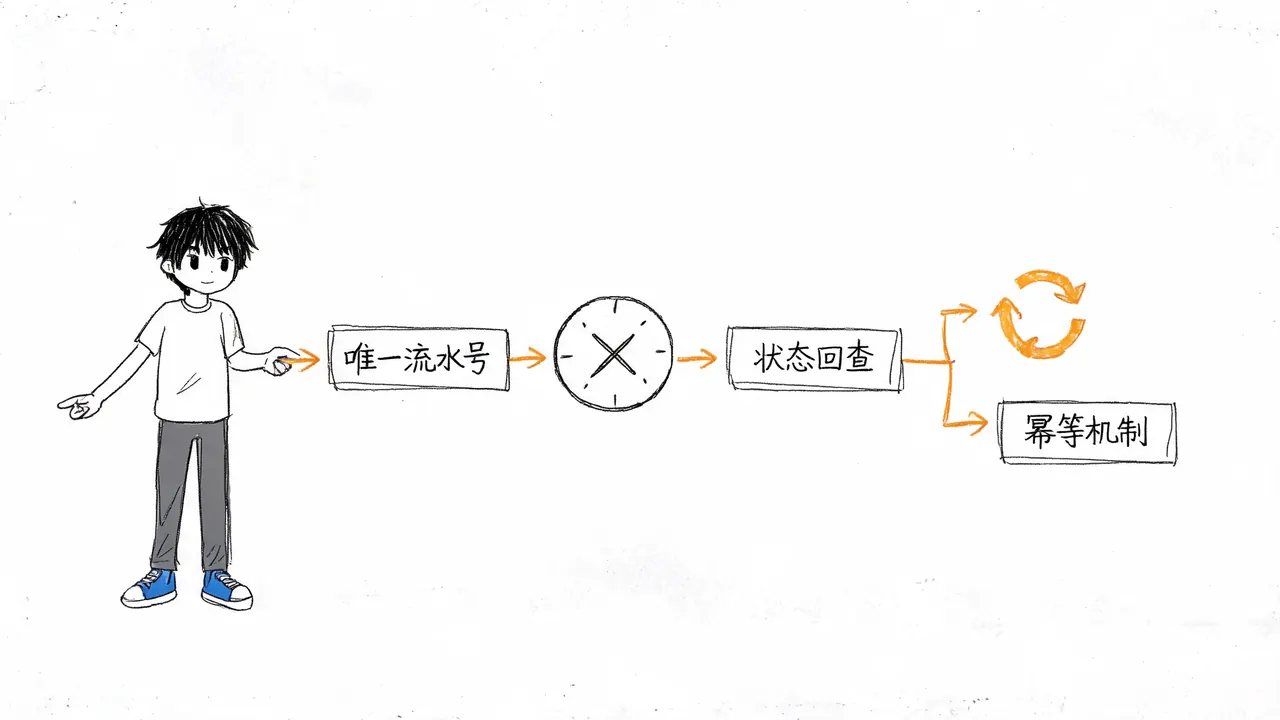
通俗来说,幂等机制的核心在于“全局唯一流水号”与“状态回查”:
- 携带唯一标识:Agent 在第一次发起调用时,必须在请求中带上一个全局唯一的流水号(ID)。
- 状态回查:一旦遇到超时报错,Agent 先使用该流水号向业务方发起状态查询。
- 情况 A:单据不存在
- 说明之前的请求丢在了半路上。
- 动作:此时可以安全地发起重试。
- 情况 B:单据已存在且处理成功
- 说明下游已经完成了业务逻辑。
- 动作:下游直接返回上次的结果,Agent 顺理成章地继续执行后续步骤,从而彻底避开重复执行的风险。
- 情况 A:单据不存在
复合任务的局部补偿机制
很多时候,Agent 执行的不是单一动作,而是由多个步骤串联起来的复合任务。
场景示例: Agent 已成功生成长篇分析报告并存入数据库,但在最后一步“发送通知邮件”时网络中断。
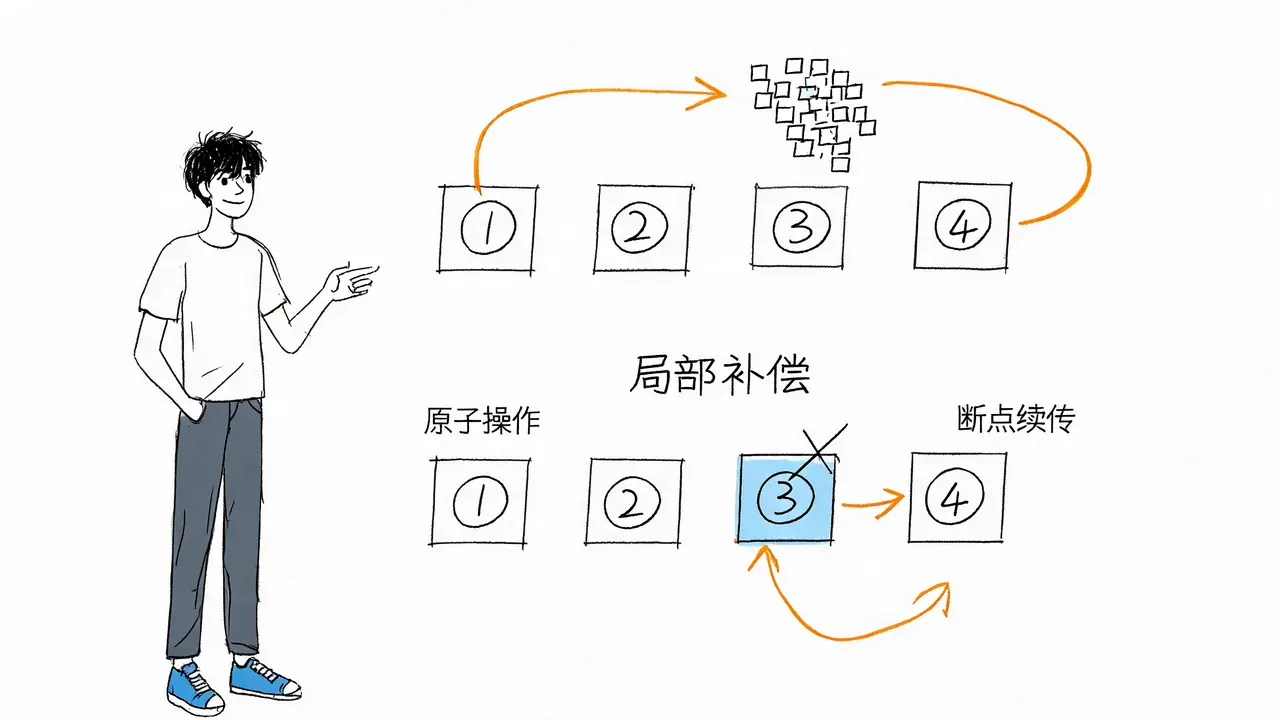
如果此时整个任务直接报错并从头重来,不仅浪费算力,还会导致数据库中产生冗余数据。面对这种多步链路,需要设计局部补偿机制:
- 断点续传:在哪个环节断掉,就从哪个环节重新接上。
- 原子操作重试:既然报告已生成,就仅针对“发邮件”这个特定动作做独立的补偿重发。
- 核心原则:将重试的力度从“整个任务”拆解到“单个原子操作”,系统的容错率才会真正提升。
重试的边界:熔断与优雅降级
即使重试逻辑写得再严密,重试本身也必须有边界。系统需要给 Agent 划定明确的红线:
- 次数限制:最多允许重试 3 次(具体数值视业务而定)。
- 耗时限制:总耗时不能超过预设阈值(如几秒钟)。
- 错误码白名单:只能针对特定的、可重试的错误码进行重发。
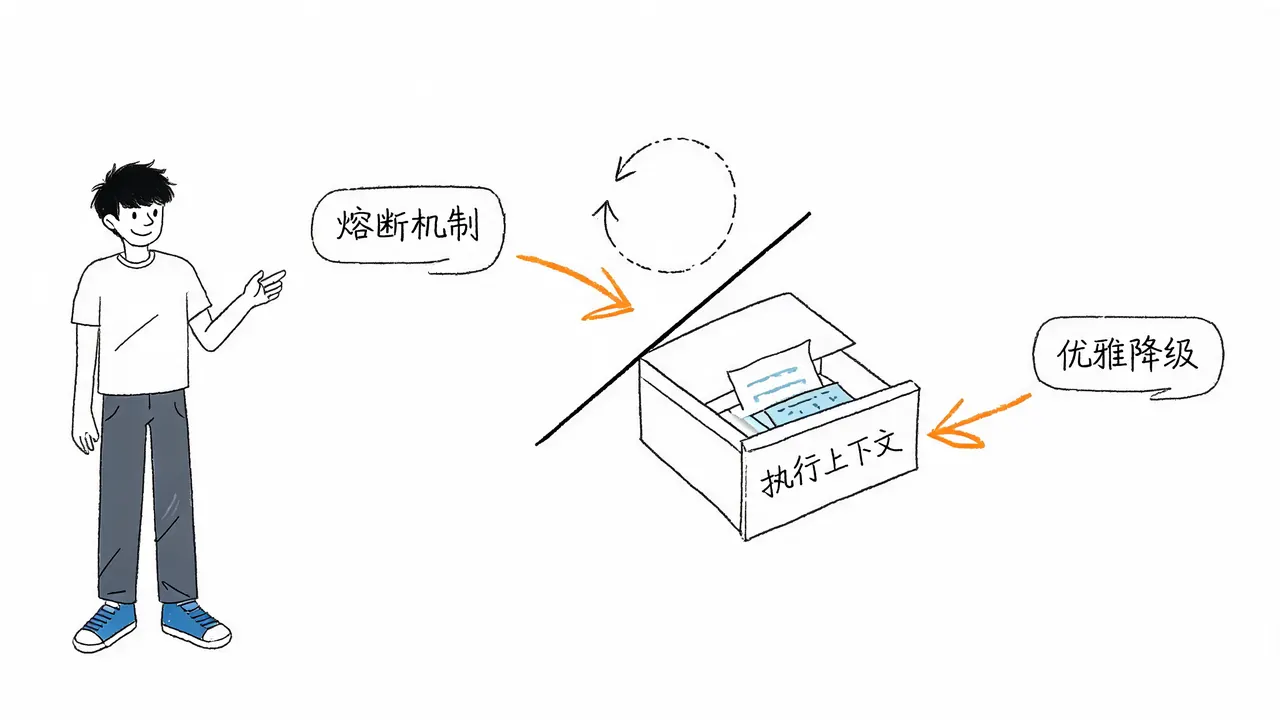
熔断机制
如果在局部重试期间,下游系统彻底当机,必须触发熔断机制。
- 目的:防止 Agent 用源源不断的重试请求,将对方系统最后一点资源拖垮。
优雅降级与上下文保存
当所有重试手段耗尽,或撞上熔断红线时,Agent 需要学会“优雅地停下”:
- 保存执行上下文:将当前任务的执行状态打包保存。
- 记录断点信息:清楚记录当前卡在哪一步,以及已完成哪些前置工作。
- 后续处理:
- 等待网络恢复后,进行断点续传。
- 或者移交给人类接管。
通过保护现场,整个业务线才算是真正做到了安全可控。
总结
给 AI 智能体写工具调用,不能只套一个简单的重试循环。面对超时和异常,开发者需要建立严密的工程链路:
- 先分类:区分业务阻断、参数错误和环境故障。
- 后幂等:对副作用操作引入唯一流水号和状态回查。
- 再补偿:对复合任务实施局部原子操作重试。
- 终熔断:设置重试边界,保护下游系统,并支持断点续传。
只有遵循这套机制,才能避免重复扣款等严重后果,构建出真正可靠的生产级 AI Agent 系统。