为什么一条慢 SQL 能拖垮整个数据库?
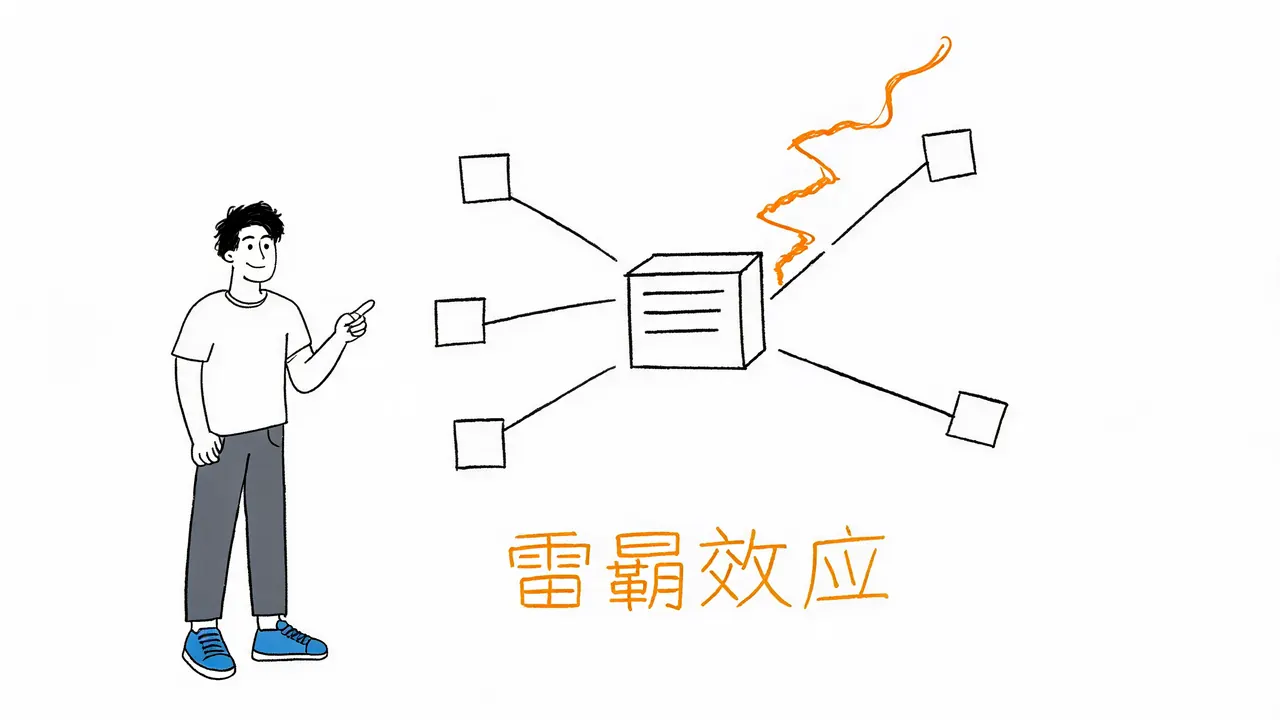
一条慢 SQL 之所以能拖垮整个数据库,是因为数据库本质上是一个共享资源池。慢查询就像在银行柜台办理极其复杂的业务,不仅自己长时间占用窗口不走,还会把后面的正常客户全堵死,甚至把银行的安保和档案室全拖垮。
在实际生产环境中,很多系统崩溃并不是因为硬件配置不足,也不是因为并发流量过大,而是由一两条未优化的 SQL 语句引发的雪崩效应。它究竟是如何占满连接窗口的?又是如何榨干硬件资源的?为什么有时候明明流量不大,系统依然崩溃?
第一层破坏:耗尽数据库连接池
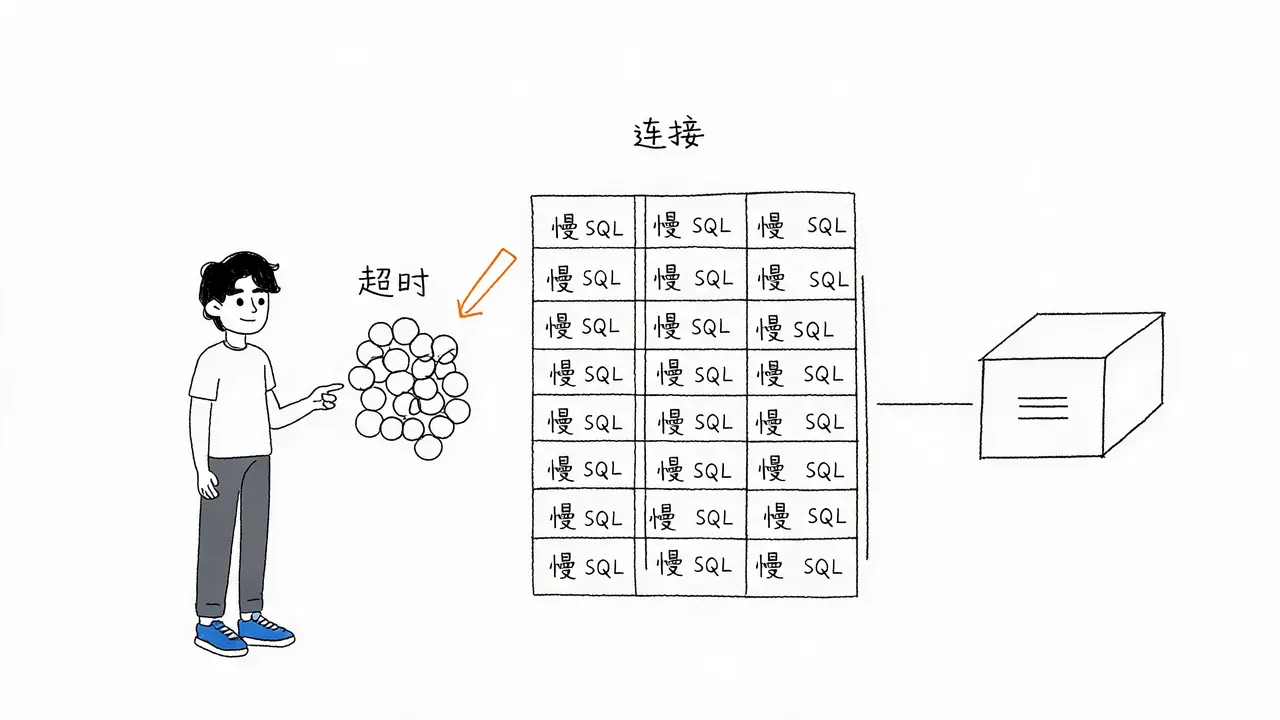
应用程序与数据库之间通常会维护一个连接池,你可以将其理解为银行的办事窗口,数量是固定的(例如只有 50 个)。
- 正常情况:普通的 SQL 语句几毫秒即可执行完毕,办完业务立刻释放窗口,供后续请求使用。
- 异常情况:如果一条慢 SQL 需要执行十几秒甚至更久,它就会一直霸占连接不放。
当几十个窗口全被慢 SQL 占满时,后续进来的新请求无法获取连接,只能在队列中等待,最终导致连接超时。此时,整个系统对外表现出的状态就是彻底卡死,无法响应任何请求。
第二层破坏:榨干 CPU 和磁盘 I/O 资源
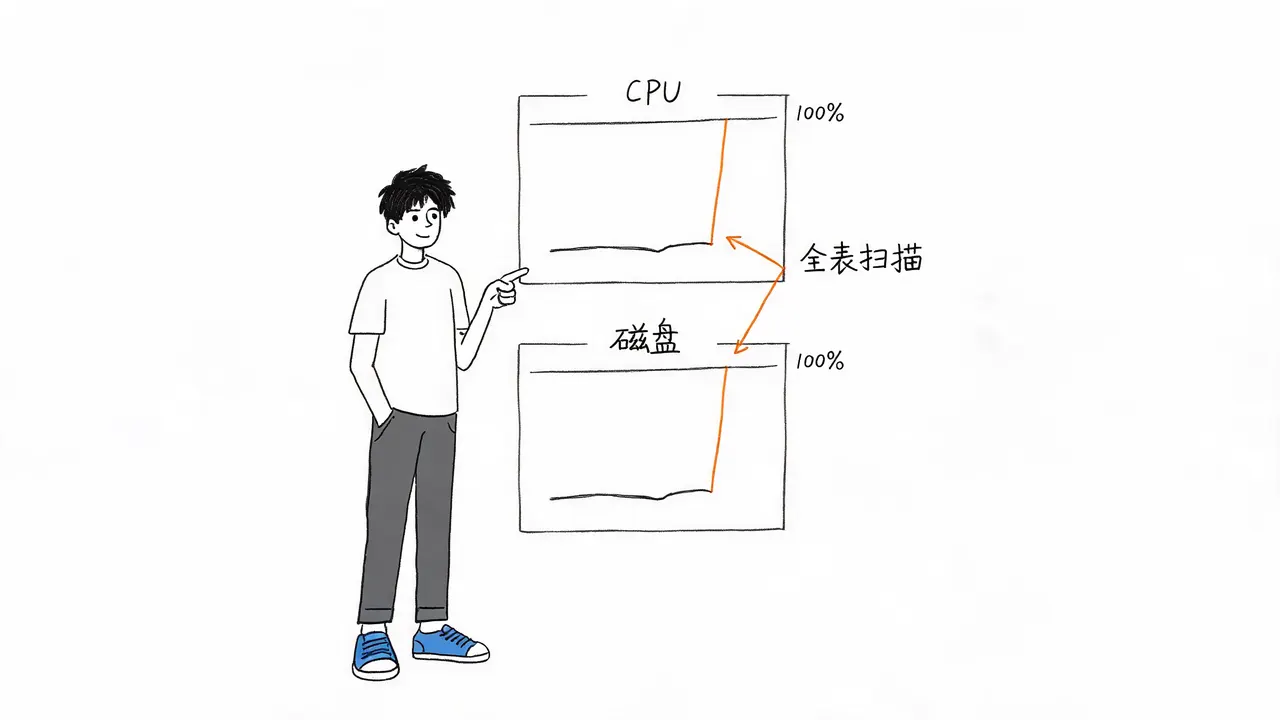
慢 SQL 之所以慢,很多时候是因为没有命中索引,导致数据库不得不进行全表扫描。这就好比要找一份档案,不看目录,而是把几百万页的文件一页一页地翻找。
这种操作会瞬间将数据库的 CPU 计算能力和磁盘读取能力吃满。在这种极端负载下,哪怕其他正常的 SQL 语句进入系统,也分不到任何硬件资源,只能跟着一起变慢,从而形成恶性循环。
第三层破坏:引发锁竞争和事务阻塞
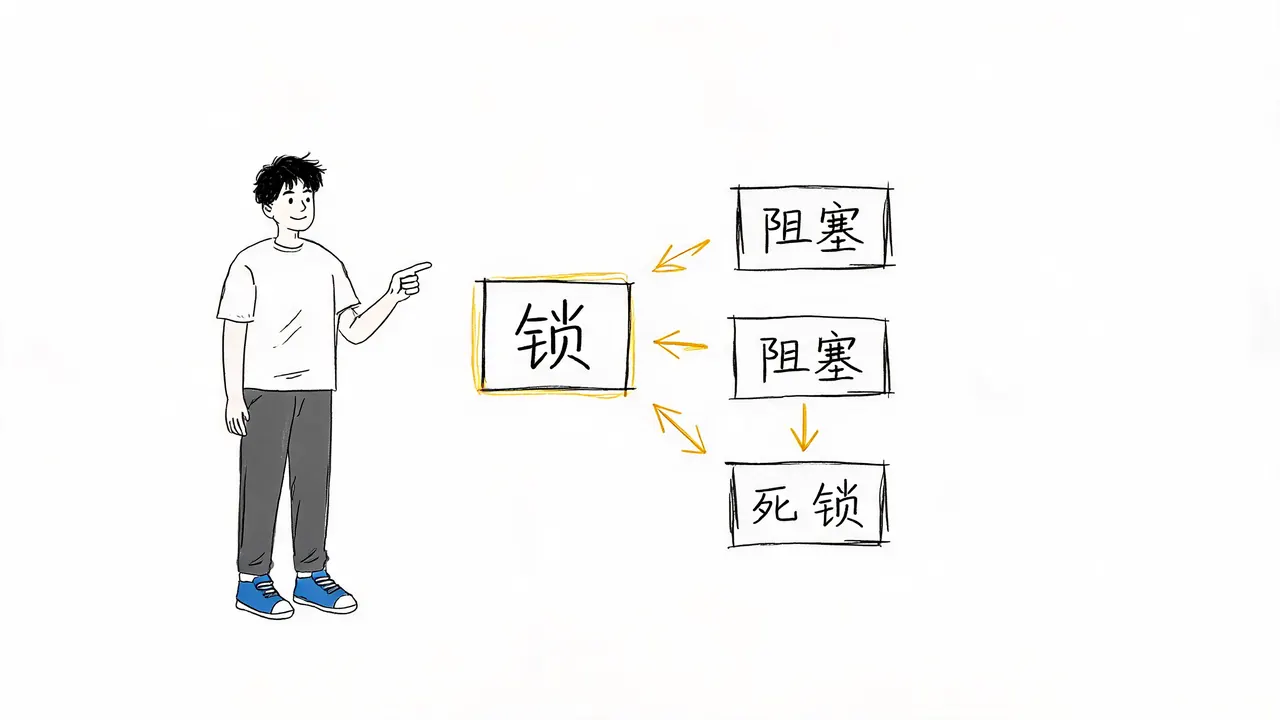
如果这条慢 SQL 还包含更新(UPDATE)或删除(DELETE)操作,它会长时间持有某些数据行的锁。
- 阻塞效应:其他想要修改同一行数据的正常事务只能干等。
- 连锁反应:等待时间过长不仅会导致自身超时,还可能引发大面积的事务阻塞,甚至导致死锁(Deadlock),让数据库的内部状态陷入混乱。
常见误解:低流量也能引发崩溃
很多人误以为只有“双 11”那种高并发、大流量的场景才会压垮数据库。其实,哪怕每秒只有几个请求,只要这几个请求全是未优化的慢 SQL,照样能让数据库崩溃。
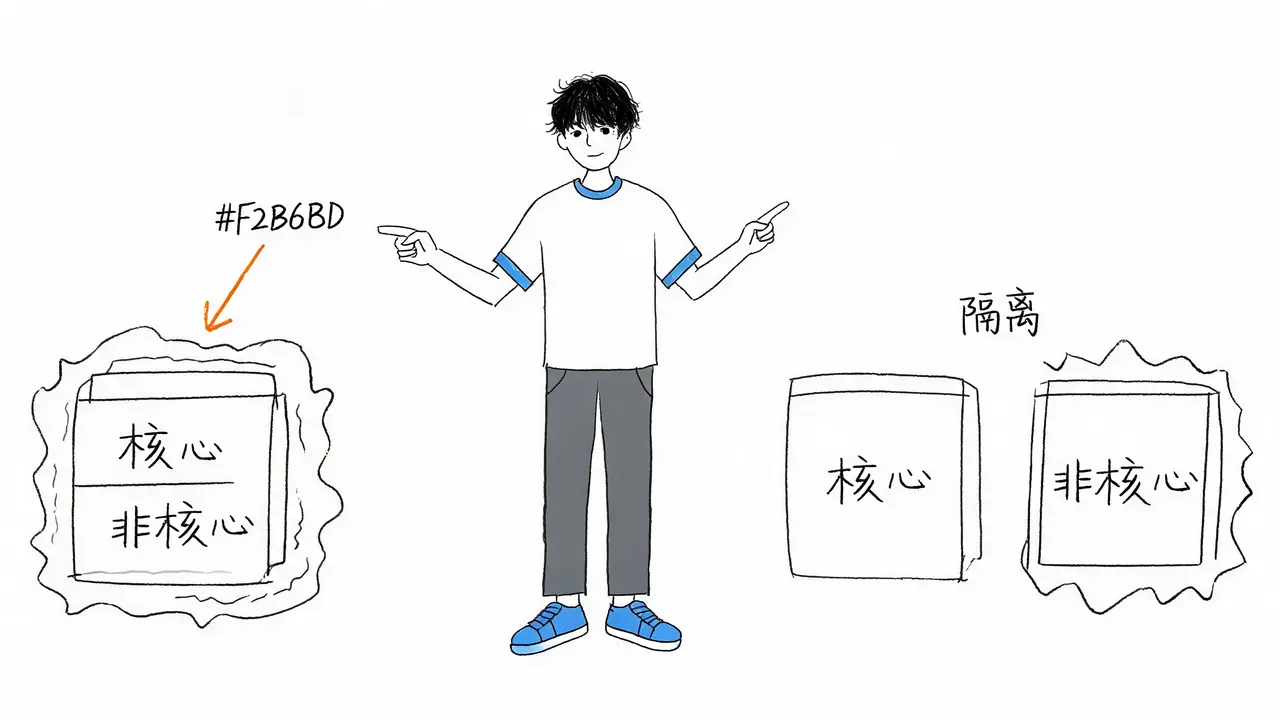
因为此时的瓶颈根本不在于“来的人多”,而在于“每个人占坑的时间太长”,从而将有限的连接和硬件资源耗尽。这就是为什么有时候一个边缘的非核心业务发版,也能把核心交易库拖垮的原因。
防御策略:隔离与优化
慢 SQL 拖垮全库是有边界条件的,这种情况通常发生在所有业务共用同一个数据库实例的时候。
如果系统架构做了以下优化,可以有效避免此类问题:
- 读写分离:分散读取压力。
- 物理隔离:对核心业务和非核心业务进行数据库实例隔离。
- 资源限流:限制非核心业务的资源占用。
通过这些手段,一条非核心业务的慢 SQL 就只会耗尽它自己那个隔离区的资源,而不会让核心的交易链路跟着“陪葬”。
结语
数据库是一个共享的精密系统,它的整体响应速度往往不取决于最快的那条 SQL,而是受制于最慢的那条。
看懂了慢 SQL 的破坏力,也就理解了为什么在开发阶段,哪怕多花十分钟检查一次执行计划、加一个合适的索引,也比上线后半夜被故障报警叫醒要划算得多。