为什么Python离不开pip?解析其核心机制与生态地位
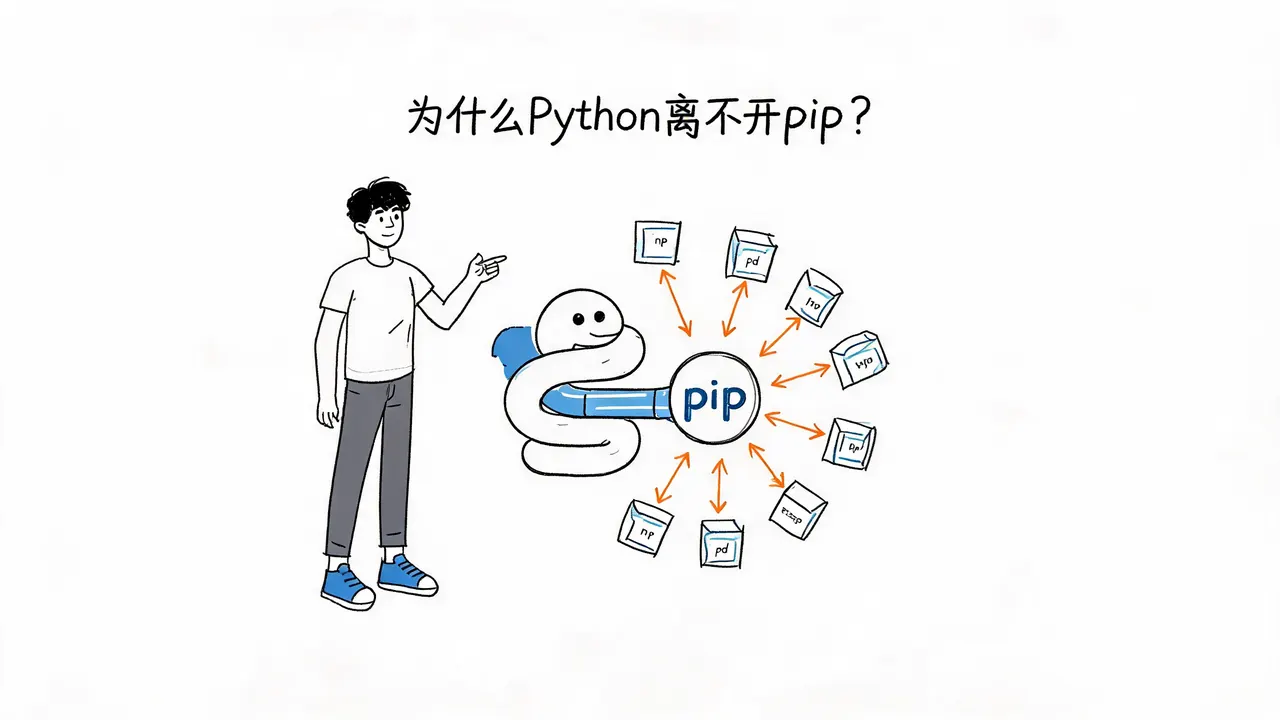
Python 之所以能成为当今最流行的编程语言之一,很大程度上得益于其“自带电池”(Batteries Included)的设计理念。然而,面对日益复杂的现代软件开发需求,仅靠标准库已远远不够。pip 作为 Python 生态中管理第三方包的核心工具,正是连接 Python 与庞大第三方库世界的桥梁。
本文将深入拆解 pip 的核心工作机制,阐述它如何解决复杂的依赖问题,并解释为何它在 Python 开发工作流中具有不可替代的地位。
从“自带电池”到第三方库的必然需求
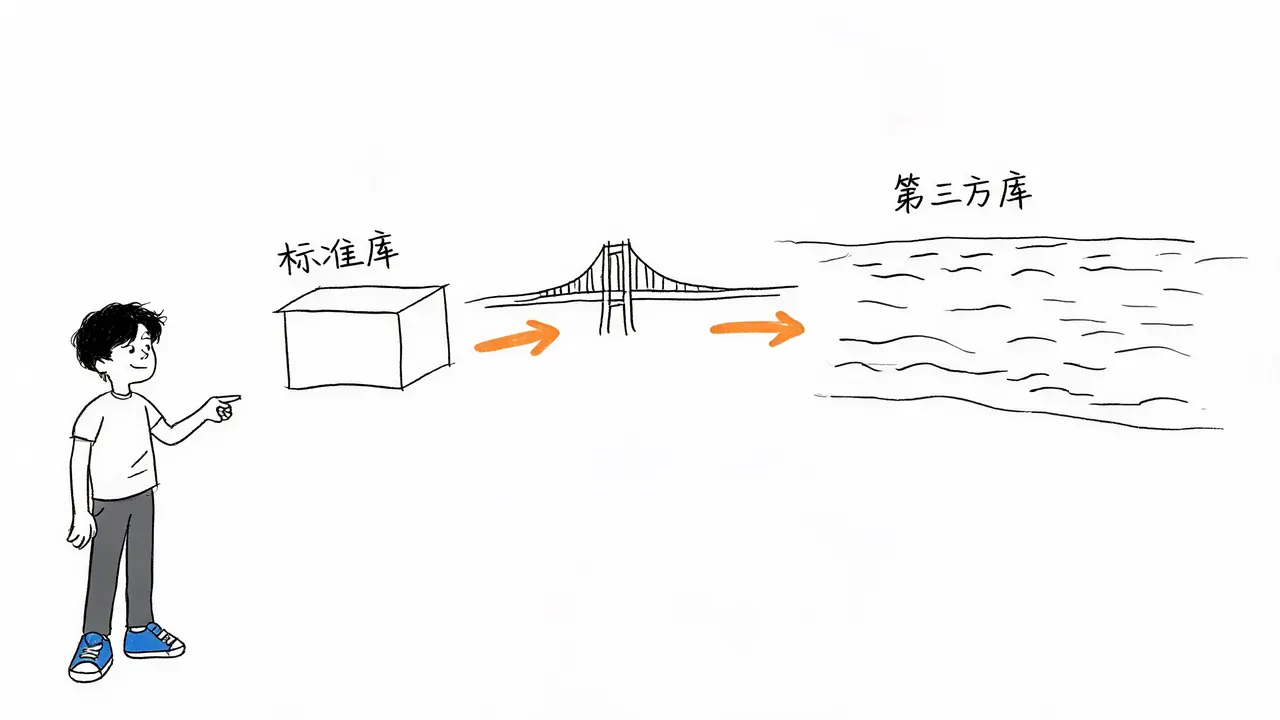
要理解 pip 的重要性,首先需要回顾 Python 的设计哲学。Python 标准库内置了处理文件、网络、数据等常见任务的丰富模块,让开发者能够“开箱即用”。然而,标准库的体积是有限的,不可能将机器学习、Web 框架、科学计算等所有领域的功能都塞入其中。
这就引出了对第三方库的巨大需求。如果没有一个高效的管理工具,安装和使用这些库将变得极其困难。pip 的核心作用,就是从官方仓库下载代码,并自动配置到当前的 Python 环境中,从而填补了标准库与复杂应用之间的空白。
没有 pip 的世界:手动安装的噩梦
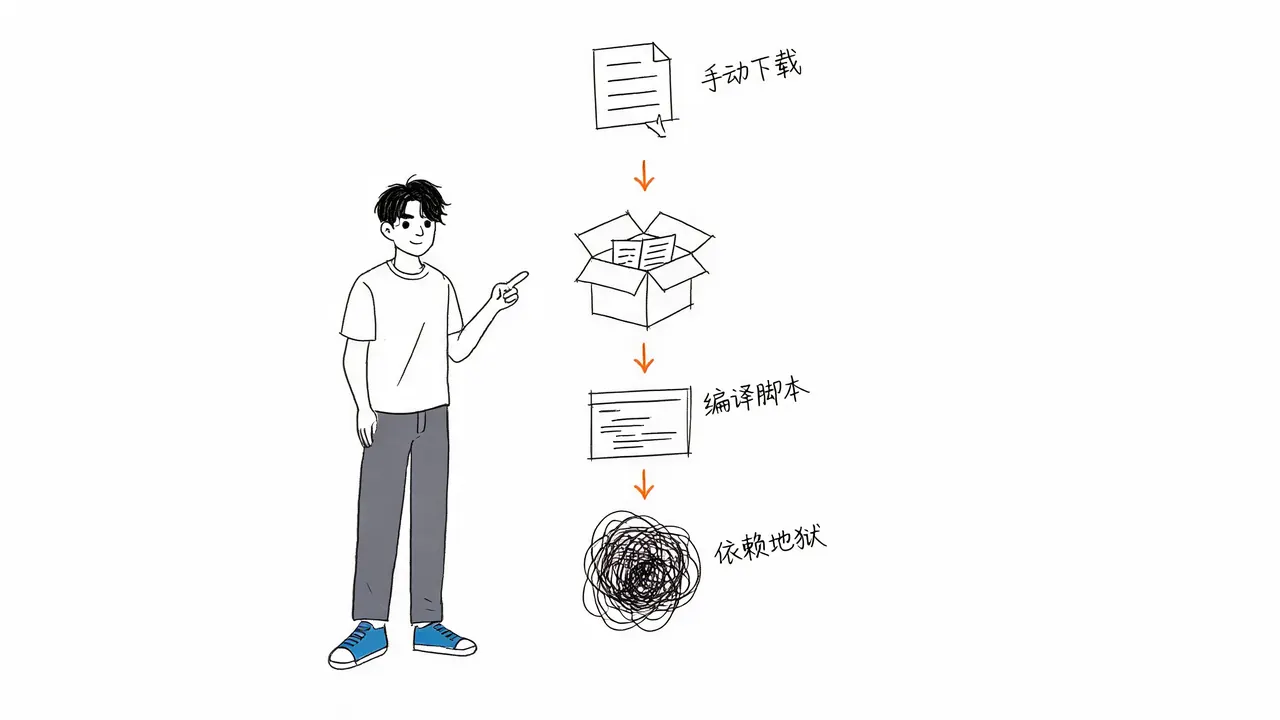
假设在没有 pip 的情况下,你需要安装一个数据分析库,流程将是怎样的?
- 手动下载:你需要访问官网,找到源码压缩包并下载。
- 解压与阅读:解压文件后,仔细阅读文档以了解安装步骤。
- 编译脚本:手动运行编译脚本,处理可能涉及的 C 语言扩展编译问题。
- 依赖地狱:如果该库依赖另外三个数学计算库,你必须手动下载并安装这些底层库。安装顺序一旦错误,就会报错。
这种纯手工操作不仅耗时,而且极易出错,完全违背了 Python 追求简洁高效的初衷。pip 的出现,正是为了解决这一痛点。
pip 的核心贡献:自动化与标准化
pip 之所以成为核心工具,主要归功于以下两大核心机制:
1. 统一的包索引与自动化下载
pip 建立了统一的包索引机制,默认连接 PyPI(Python Package Index),即 Python 官方的包索引仓库。
当你输入安装命令时,pip 会向 PyPI 发送请求,精准定位对应版本的包文件并下载到本地。开发者无需关心包的具体存储位置,只需知道包名即可。
2. 自动解析与安装依赖树
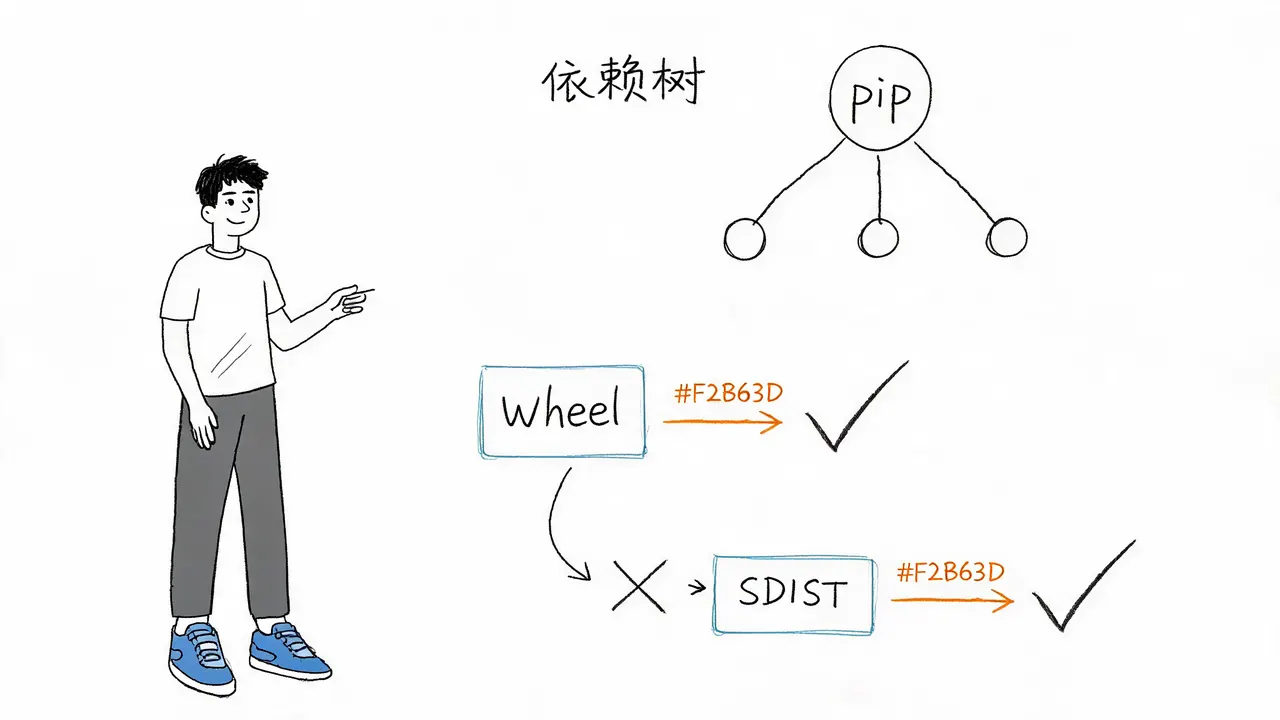
现代软件很少孤立存在,一个包往往依赖其他多个包,形成复杂的树状结构。pip 能够读取包中的元数据文件,自动计算出所有需要的子依赖,并一次性将它们全部安装好。这种自动化的依赖解析能力,极大地降低了环境配置的复杂度。
双轨制下载策略:Wheel 与 SDIST
在安装格式上,pip 采用了智能的“双轨制”策略,以平衡安装速度与兼容性:
- 优先下载 Wheel 格式:Wheel 是一种预编译的二进制包。它不需要在本地重新编译,直接解压即可使用。这不仅极大提升了安装速度,还避免了因缺少编译器或构建工具导致的失败。
- 退而求其次下载 SDIST:如果找不到 Wheel 包,
pip会下载 SDIST(Source Distribution,源码分发包)。此时,它会在本地临时构建一个编译环境,尝试将源码编译成可执行的模块。
这种机制保证了绝大多数包都能在各种操作系统上顺利安装,兼顾了效率与兼容性。
全生命周期管理与环境隔离
除了安装,pip 还接管了包的升级和卸载工作:
- 一键升级:
pip可以对比本地和仓库的版本,一键完成升级。 - 干净卸载:卸载时,
pip会清理掉安装时释放的所有文件,保持环境整洁,防止残留文件引发 Bug。
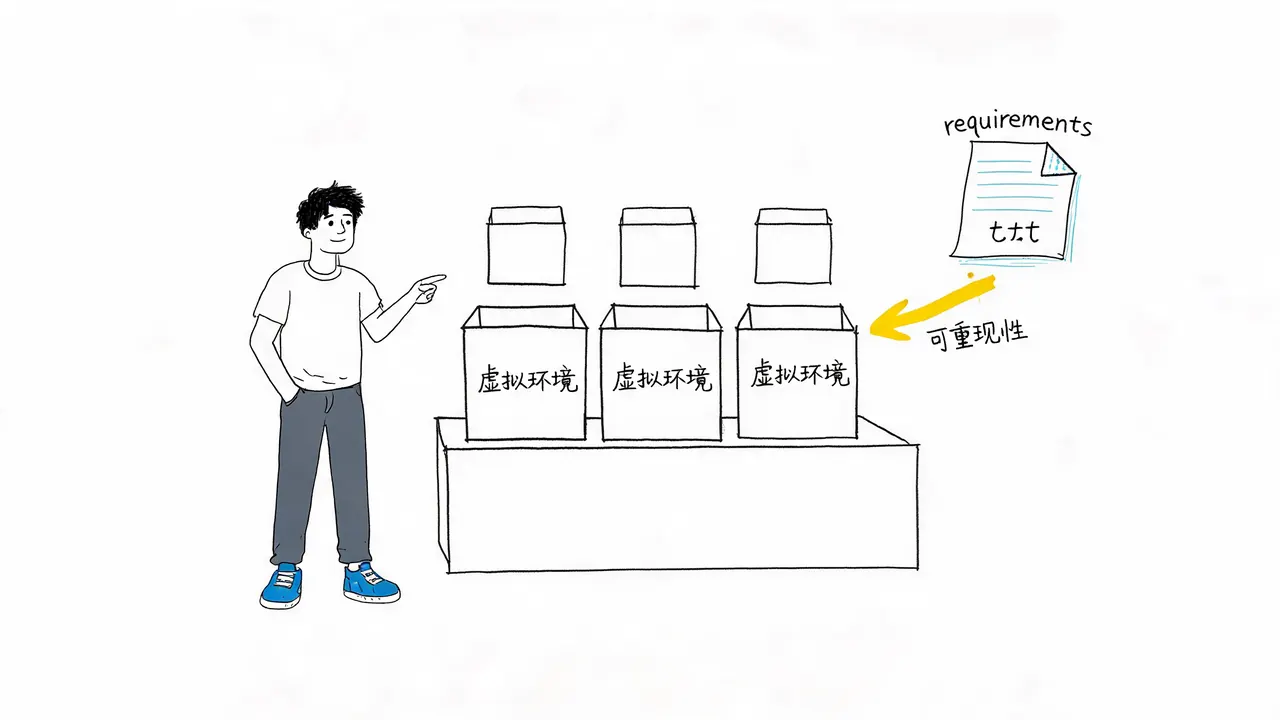
在实际开发中,pip 通常与虚拟环境(如 venv 或 virtualenv)绑定使用。不同项目可能需要同一个库的不同版本,直接全局安装会导致版本冲突。通过结合虚拟环境工具,pip 可以将包安装在隔离的目录中,确保项目之间互不干扰。
此外,pip 引入了 requirements.txt 依赖声明文件。开发者可以将项目需要的所有包及精确版本号写入该文件。新成员接手项目时,只需一行命令,pip 就能根据清单完美复刻出完全一致的开发环境,实现了开发环境的可重现性。
结语:生态的基石
虽然近年来出现了 Poetry、UV 等更现代、更快速的包管理工具,但它们并没有取代 pip。这些新工具大多封装了更高级的解析算法,或在底层依然调用 pip 的逻辑。pip 依然是整个 Python 生态的基石。
总结来说,Python 离不开 pip,是因为它将复杂的软件分发和依赖管理简化为简单的一行命令。它屏蔽了底层的编译细节和依赖冲突,让开发者能将精力集中在业务逻辑上。理解了 pip 的工作机制,你就能更优雅地掌控 Python 的开发环境。