什么是 Browser-use?让 AI 智能体像人一样操作浏览器的开源工具
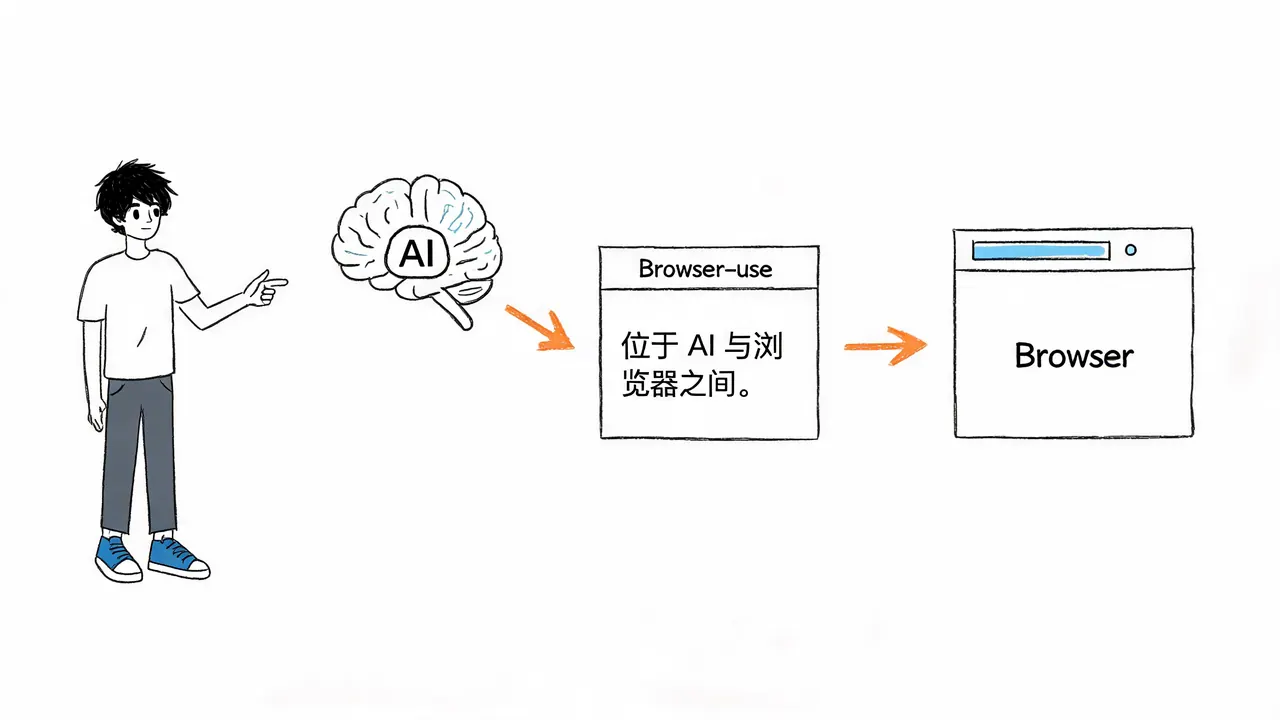
Browser-use 是一个让 AI 智能体像人一样操作浏览器的开源工具。你只需给它一个任务,例如“帮我把这个网页上的所有商品价格整理成表格”,它就能自主打开浏览器、点击按钮、填写表单、翻页并读取内容,最终将结果交付给你。
它既不是浏览器插件,也不是搜索引擎,而是位于 AI 与浏览器之间的一层“手和眼睛”。要理解它的核心价值,首先需要了解大语言模型(LLM)的一个关键局限:虽然 GPT 等模型擅长处理文字和逻辑,但它们“看不见”网页。对 LLM 而言,网页只是一堆混乱的 HTML 代码,即使直接输入代码,模型也难以直观感知页面布局、按钮位置或需要滚动才能看到的内容。
Browser-use 的核心作用,就是将人类难以直接解析的网页,翻译成 AI 能理解的步骤,并替 AI 执行这些步骤。
`` 是摘要与正文的分隔标记,请保留。核心工作机制:感知、决策与执行
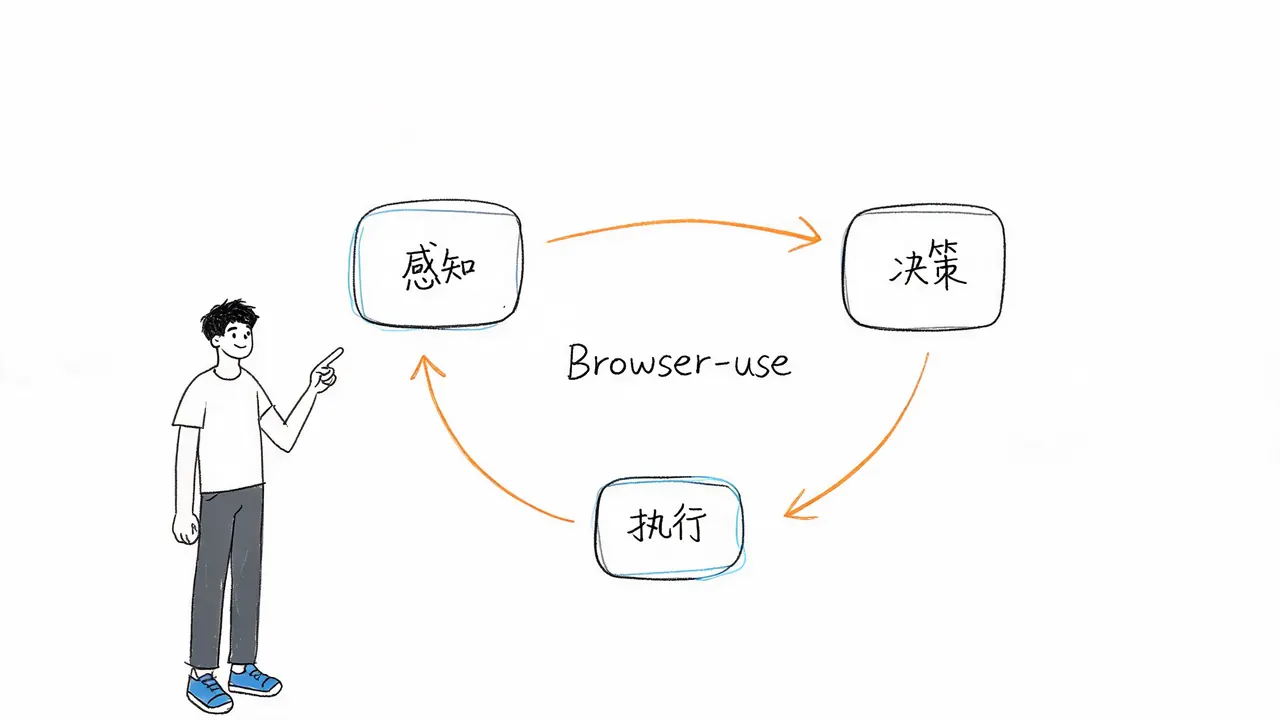
Browser-use 的工作流程可以拆解为三个紧密循环的环节:
-
感知(Perception) Browser-use 会抓取当前页面的可交互元素(如按钮、输入框、链接),并将它们连同文字描述一起压缩成 AI 能处理的结构化信息。
- 关键点:它不会将整个网页原封不动地丢给 AI(那样资源消耗过大),而是提取关键信息。这就像进餐厅时,你不会先读完整本菜单,而是先看服务员推荐的招牌菜。
-
决策(Decision) AI 根据任务目标和感知到的页面状态,决定下一步动作。例如,决定点击“登录”按钮,或在搜索框中输入特定关键词。
-
执行(Execution) Browser-use 调用浏览器自动化协议,真正去操作页面。随后,它等待页面变化,抓取新的状态,并重新进入“感知”环节,形成闭环,直到任务完成。
动态决策 vs. 传统脚本
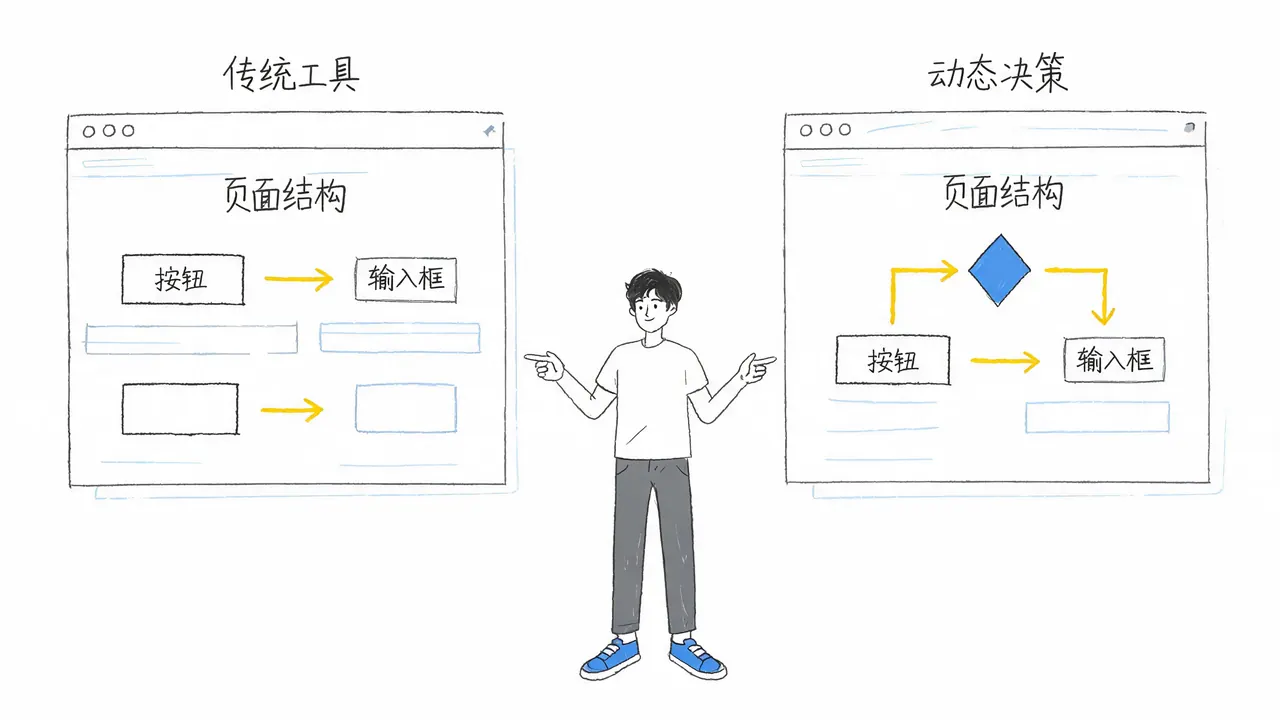
理解 Browser-use 优势的关键,在于区分它与传统自动化工具(如早期的按键精灵)的不同。
- 传统工具:依赖预设脚本,需要用户一步一步写死操作流程。一旦页面结构改变,脚本往往立即失效。
- Browser-use:采用动态决策机制。每一步操作都根据当前页面的实时情况重新判断。
这意味着 Browser-use 能够应对从未见过的网页布局,也能处理弹窗、延迟加载等意外情况。当然,这并不意味着它万无一失。遇到复杂的验证码、高难度的拖拽操作或需要登录的付费墙时,它依然可能卡住,需要人工介入。
典型应用场景
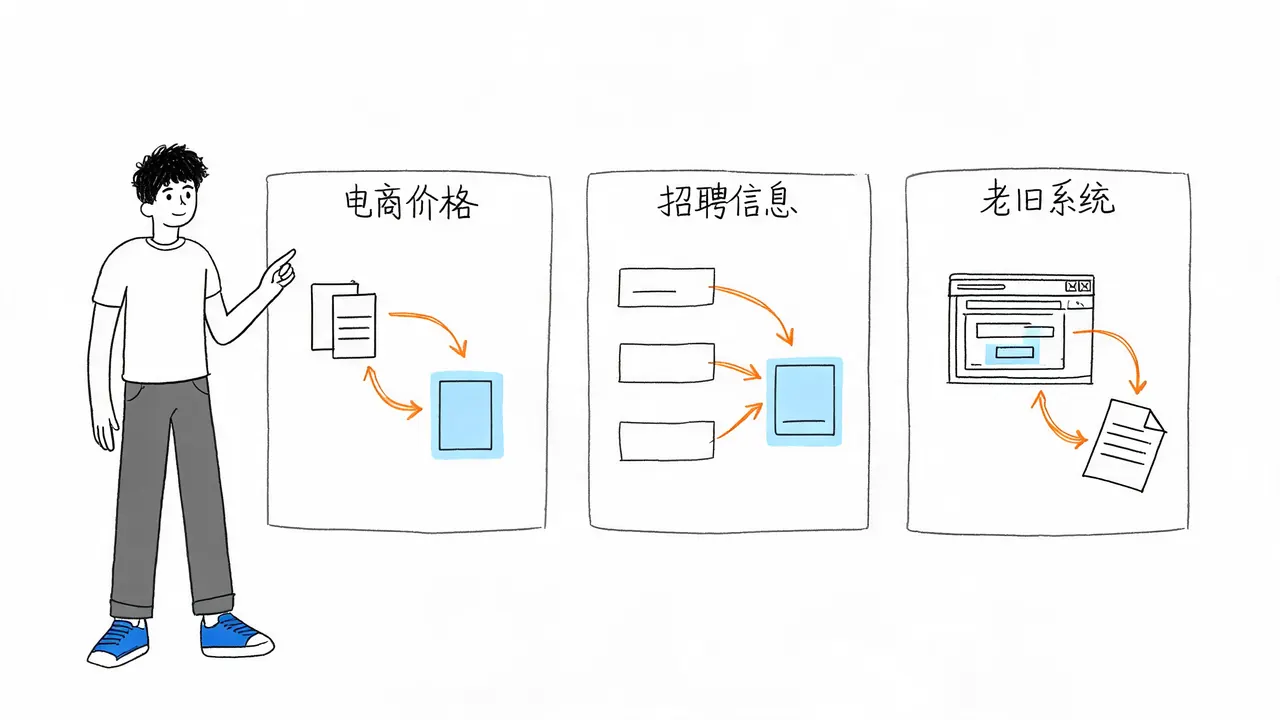
Browser-use 的使用场景非常接地气,主要解决那些“有网页界面但缺乏 API 接口”的痛点:
- 电商价格对比:无需手动逐个打开网页,将任务交给 Browser-use,它可自动抓取并对比多个电商平台的价格。
- 招聘信息监控:定时访问招聘网站,搜索新发布的岗位并自动汇总,替代人工重复搜索。
- 老旧系统数据提取:许多企业内部管理系统没有 API 接口,数据只能靠人工在网页上操作导出。Browser-use 可以充当“虚拟员工”,自动完成这些繁琐的网页操作。
使用边界与注意事项
在使用 Browser-use 时,必须明确其技术边界和性能限制:
-
依赖底层大模型 Browser-use 本身不是 AI 模型,它依赖接入的大模型进行决策。使用的模型(如 GPT-4 或本地开源模型)推理能力越强,它能处理的复杂任务就越多。模型能力的差异会直接导致执行效果的巨大差别。
-
速度受限于页面渲染 由于每一步操作都需要等待页面渲染和状态更新,其速度无法像纯 API 调用那样快。一次复杂任务可能耗时几十秒甚至几分钟。
-
资源消耗较高 它操作的是真实浏览器实例。如果同时运行几十个任务,对电脑性能(CPU/内存)和网络带宽都是严峻的考验。
总结:从“聊天”到“干活”
Browser-use 是连接大模型与真实网页的桥梁,它让 AI 从“只会聊天”进化到“能干活”。
它的价值不在于技术有多炫,而在于将“网页操作”这一人类日常最频繁的数字行为,变成了 AI 可执行的任务单元。理解 Browser-use 的核心逻辑,有助于把握未来许多 AI 自动化工具的底层思路:不是单纯让 AI 变得更聪明,而是让 AI 能够触碰到更多真实世界的数据和系统。