什么是库文件?解析静态库与动态库的核心差异
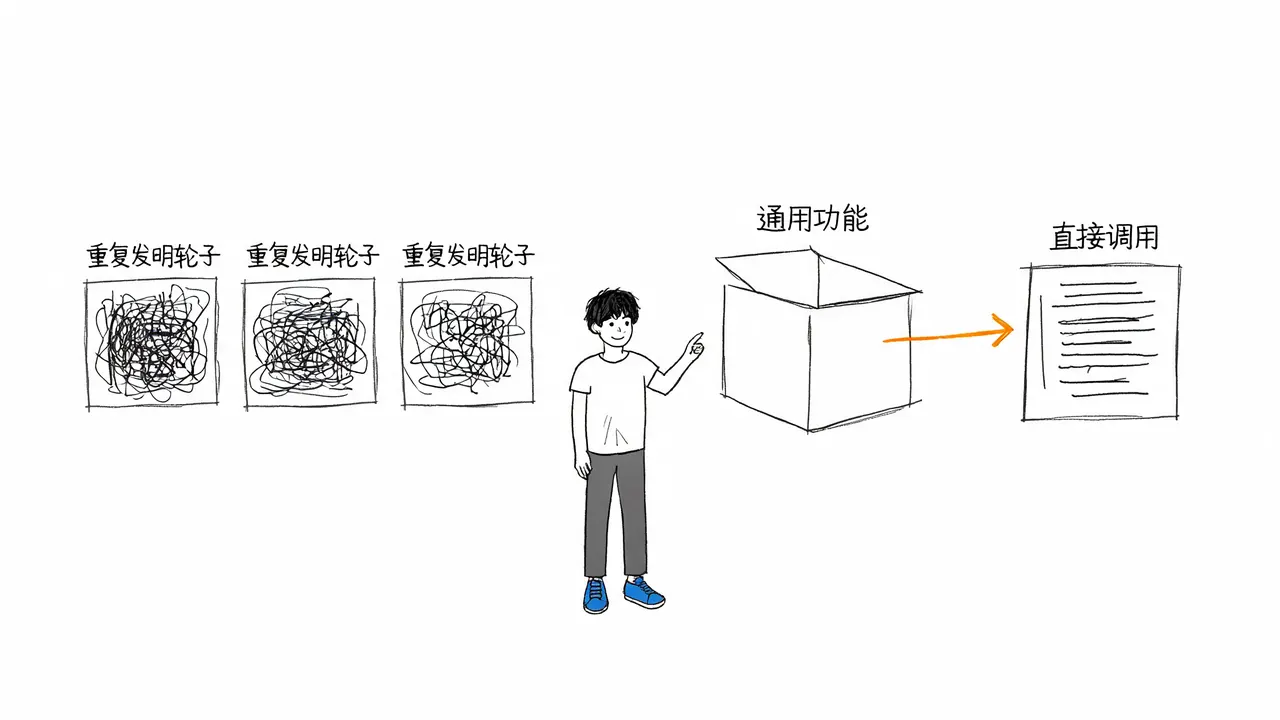
在程序开发中,一个非常现实的问题是:不可能所有功能都从零开始编写。字符串处理、数学运算、网络通信、文件读写等基础功能,如果每位开发者都重复实现,不仅效率极低,还容易引入错误。
为了解决这一问题,开发者将这些通用功能提前编写、打包成“库”(Library),供其他程序直接调用。库文件本质上是一堆已经写好、实现过功能的代码集合。它的存在旨在让开发者不必“重复发明轮子”,而是直接站在前人的工作成果之上,快速、可靠地构建自己的程序。
库文件的内部结构
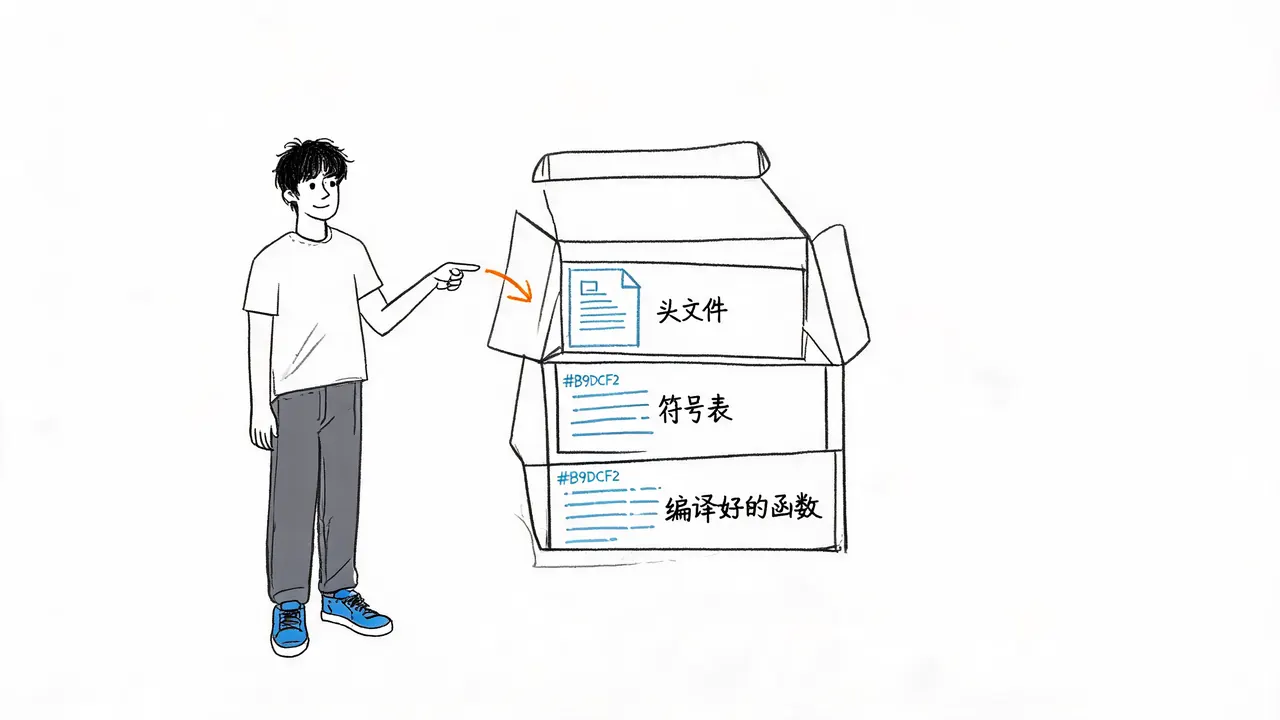
库文件通常是一个或多个二进制文件,其内部主要包含以下三个核心部分:
-
编译好的函数 无论是静态库还是动态库,其核心内容都是已经编译完成的函数实现。这是库文件提供功能的基础。
-
符号表(Symbol Table) 符号表记录了库中有哪些函数以及全局变量,并映射了它们对应的地址信息。可以将其理解为库内容的“索引”。如果没有这张表,计算机将无法定位具体功能在文件中的位置。
-
头文件(Header Files) 头文件充当了“说明书”或“接口声明”的角色。它告诉开发者库中有哪些函数可供调用,以及调用的正确格式(如函数名、所需参数等)。开发者通常不需要关心库内部的具体实现代码,只需通过头文件了解如何正确调用其提供的功能。
静态库与动态库的区别
在 Linux 和 Unix 系统中,常见的库文件主要分为两种:以 .a 结尾的静态库和以 .so 结尾的动态库。
静态库(Static Library)
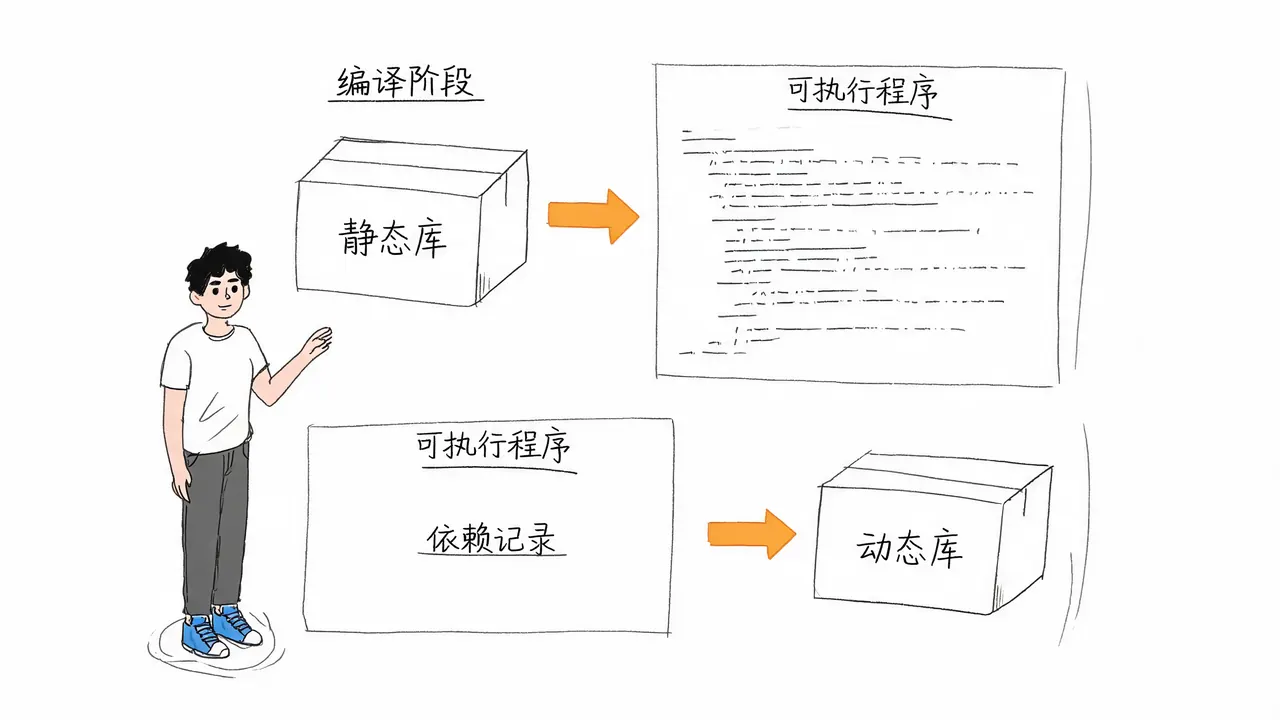
静态库的工作机制是在编译阶段将库中的代码直接拷贝进最终的可执行程序中。
- 工作原理:当编译程序时,编译器会从静态库中提取用到的那部分代码,复制到最终生成的可执行文件里。
- 优点:
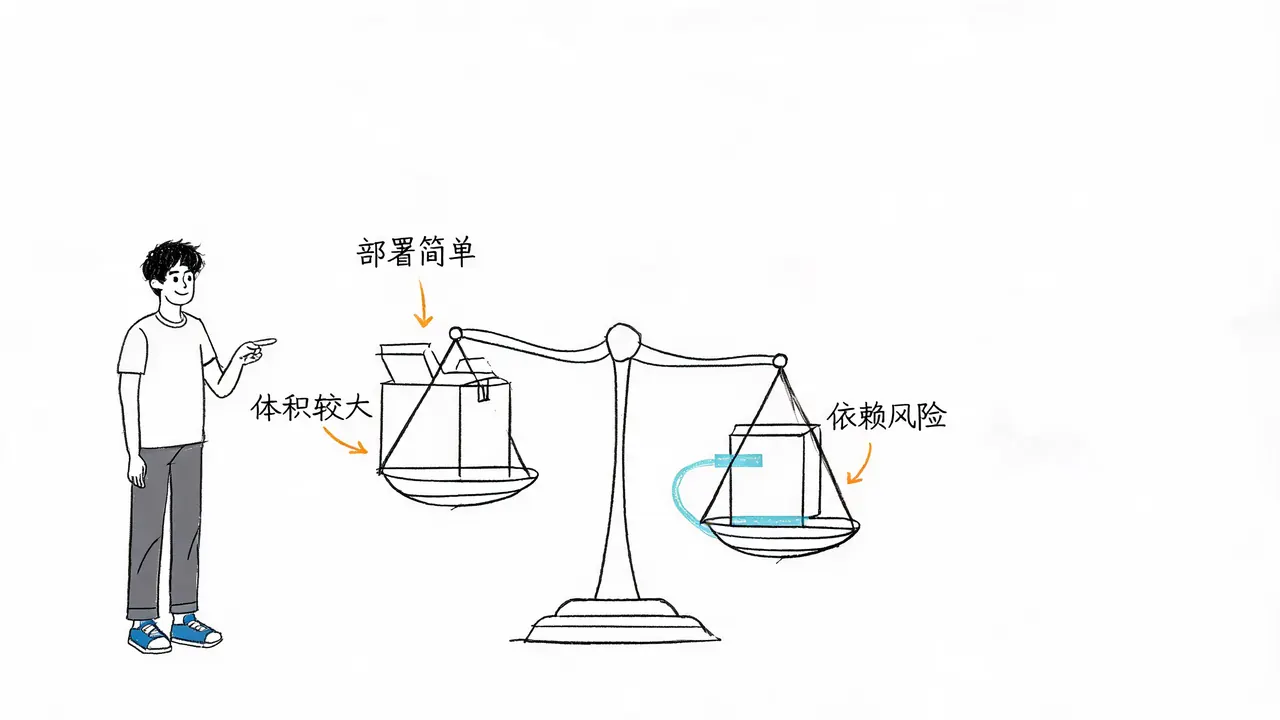
- 部署简单:程序一旦编译完成,就不再依赖外部的库文件。即使删除库文件,程序依然可以正常运行,拷贝一个程序即可运行。
- 缺点:
- 体积较大:最终生成的可执行文件体积会变大。
- 代码冗余:如果多个程序使用同一个静态库,每个程序都会包含一份重复的代码,浪费磁盘空间。
动态库(Dynamic Library)
动态库的思路与静态库相反,它采用运行时加载的机制。
- 工作原理:编译时,不把库代码拷进程序,仅记录程序需要该库。当程序真正运行时,操作系统再将动态库加载进内存,程序通过地址跳转来执行库里的函数。
- 优点:
- 节省资源:多个程序可以共享同一份库代码,节省磁盘空间和内存。
- 易于升级:升级库文件时,无需重新编译所有依赖该库的程序。
- 缺点:
- 依赖风险:如果运行时找不到对应版本的库文件,程序可能启动失败(即常见的“缺少 DLL”或“缺少 .so”错误)。
为什么库文件如此重要?
库文件解决了软件开发的三个根本问题:
-
避免重复劳动 无数程序员已经验证过的功能(如加密、网络通信、图像解码),开发者不需要也不应该自己重写一遍。直接使用成熟的库可以极大提升开发效率。
-
保证专业性 像音视频解码、科学计算等复杂功能,其底层算法极其复杂。由专业团队维护的库,其正确性、稳定性和效率远超个人实现。
-
降低程序体积和复杂度 通过共享通用的库,多个程序可以共用同一份代码,而不是在每个程序包里都塞进一份相同的实现,从而优化了整体系统的资源占用。
总结
库文件是程序员的效率神器,也是前人积累的代码财富。它让开发者无需纠结于底层实现细节,能够专注于核心业务逻辑的开发。这不仅提高了开发效率,也保证了代码质量,是现代编程不可或缺的核心组成部分。