代码是如何运行起来的?编译、链接与执行全过程解析
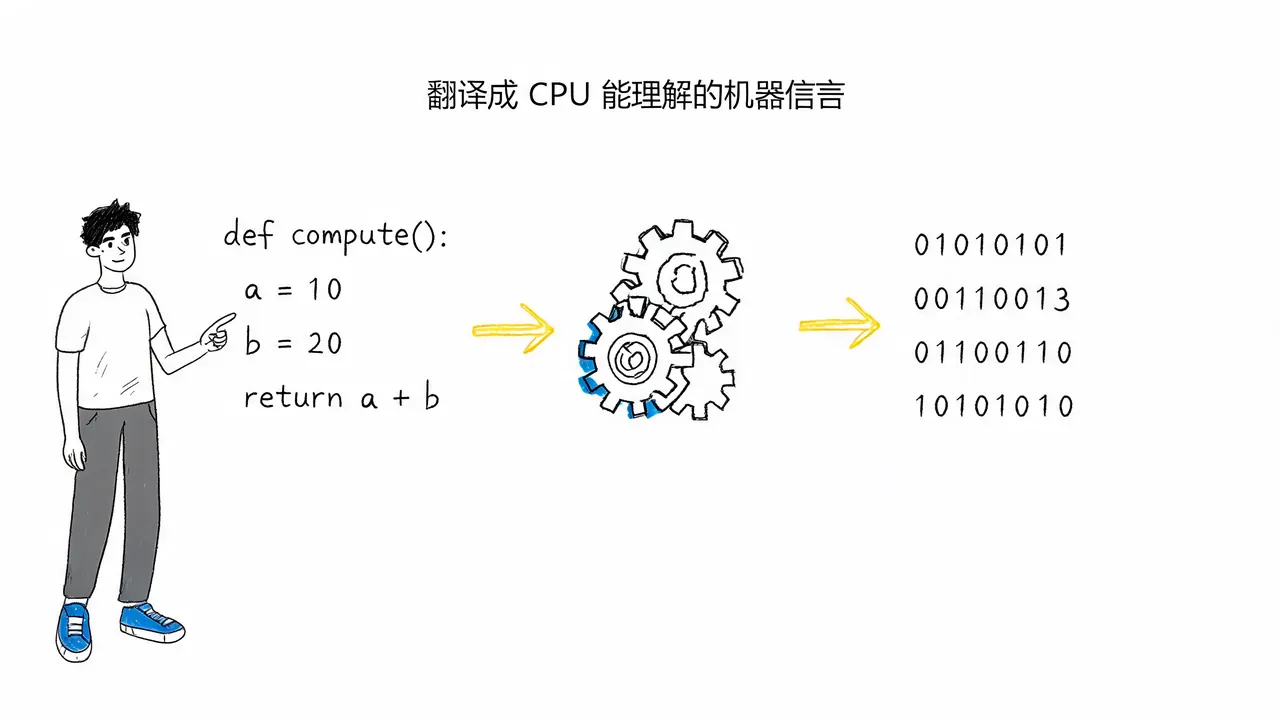
你编写的代码,无论是 Python、Java 还是 C++,本质上只是一份普通的文本文件。对于电脑 CPU 而言,这些高级语言指令是“不可读”的。CPU 只认一种语言——由 0 和 1 组成的二进制机器语言。
因此,代码能够运行起来的核心过程,就是将人类逻辑的高级语言翻译成 CPU 能理解的机器语言。这一过程主要依赖编译器(Compiler)或解释器(Interpreter)。以 C/C++ 等编译型语言为例,从源码到最终运行的程序,主要经历以下四个关键阶段。
1. 预编译(Preprocessing)
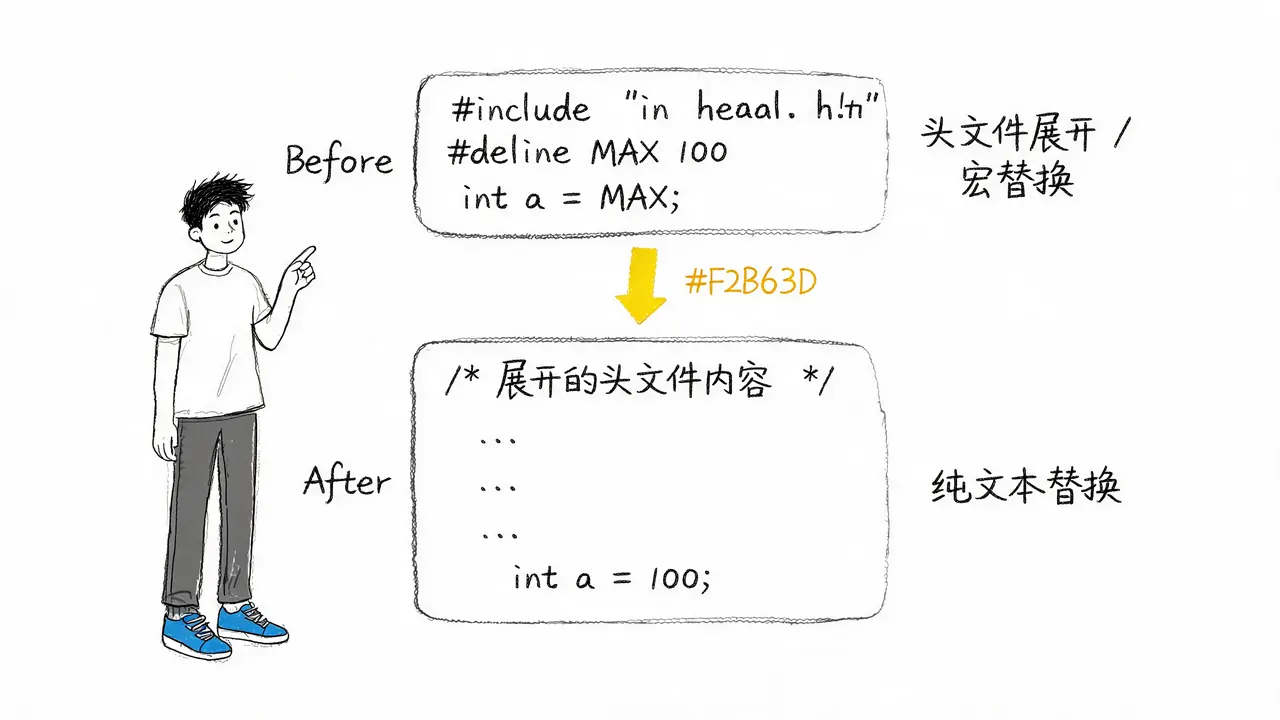
当你写完代码后,编译器做的第一件事并非直接翻译,而是进行预编译。这一阶段主要处理以 # 开头的预处理指令,核心任务包括三项:
- 头文件展开:当你使用
#include时,预编译器会将头文件中的内容原封不动地拷贝到你的代码中。在编译器眼中,不存在独立的头文件,只有一份被完全展开的巨大源码文件。 - 宏替换:
#define本质上是纯文本替换。例如,若定义#define MAX 100,预编译后代码中所有的MAX都会被直接替换为100。 - 条件编译:
#ifdef、#ifndef、#if等语句会在预编译阶段被判断。如果条件不满足,相关代码块会被直接删除,不会进入后续的编译流程。
2. 语法检查与编译(Compilation)
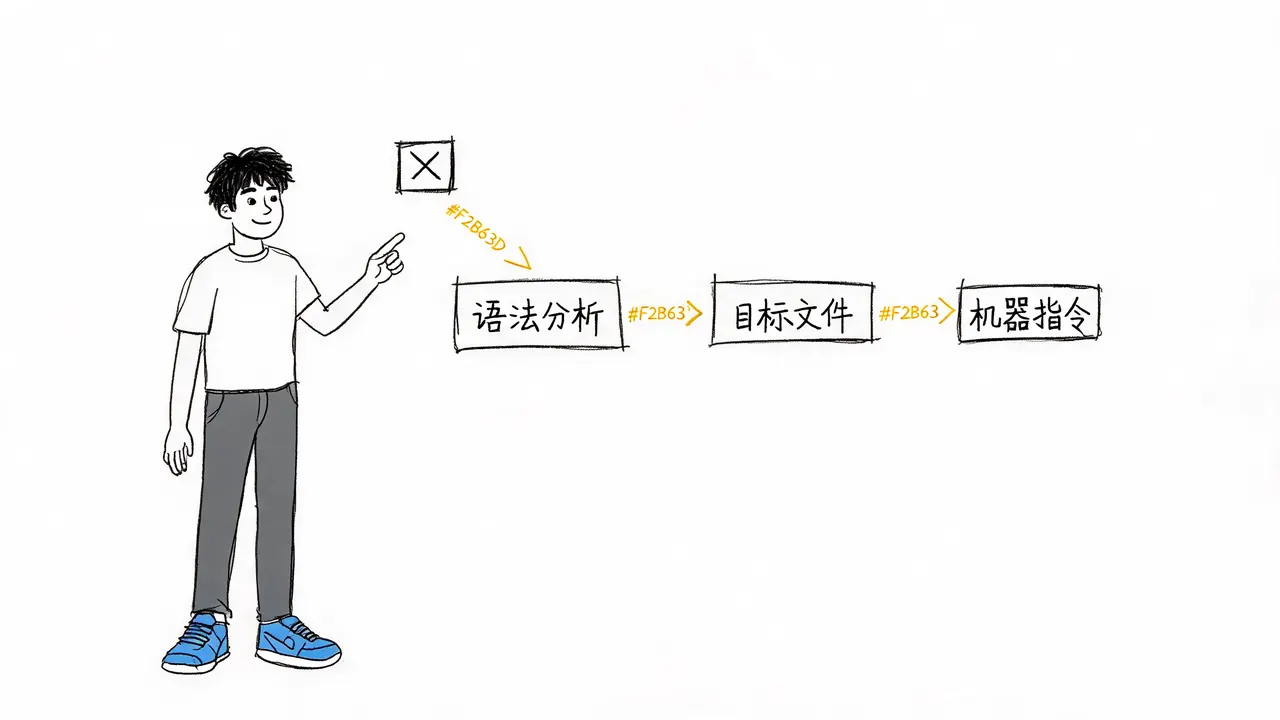
预编译完成后,进入真正的编译阶段。这一步主要包含语法分析和语义分析:
- 错误检查:编译器会检查语法是否正确、类型是否匹配、变量是否声明等。如果少写了分号或类型不匹配,编译器会在此阶段报错并终止流程。
- 生成目标文件:检查通过后,编译器将高级语言代码翻译成接近 CPU 能执行的机器指令(汇编语言再转为二进制)。此时生成的通常不是最终程序,而是目标文件(Object File,如
.o或.obj)。
3. 链接(Linking)
链接是许多开发者容易忽视但至关重要的一步。你编写的程序几乎从来不是孤立的,通常会依赖系统库或第三方库。
- 拼接代码:链接器(Linker)负责将你编写的代码与所有依赖的库代码拼接在一起。
- 生成可执行文件:链接完成后,才会生成真正意义上的可执行程序。例如,在 Linux 下生成 ELF 格式文件,在 Windows 下生成
.exe文件。
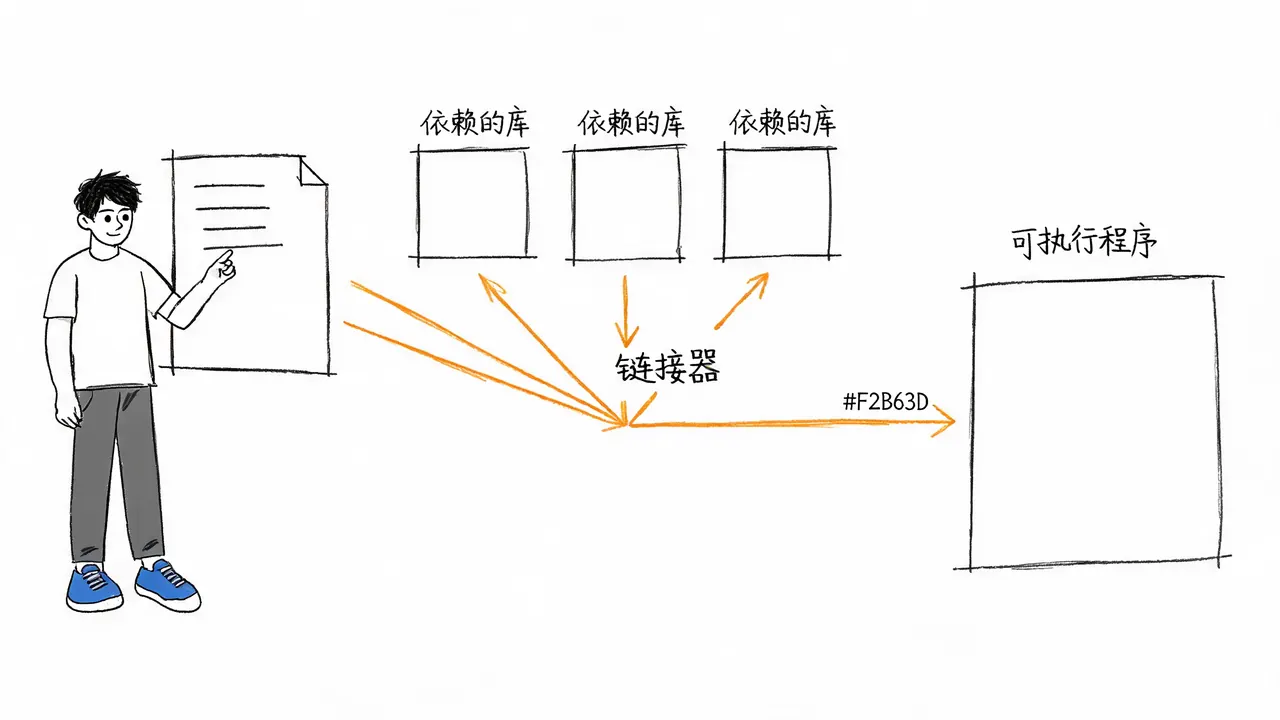
至此,代码已不再是文本,而是一份 CPU 能理解、操作系统能加载的二进制程序。
4. 运行(Execution)
当你在命令行输入程序名或双击可执行文件时,操作系统正式登场,执行以下操作:
- 加载到内存:CPU 只能从内存中读取指令执行,无法直接运行硬盘上的程序。操作系统会将程序从磁盘加载到内存中。
- 分配资源:操作系统为程序分配必要的资源,包括进程 ID、内存空间(栈和堆)、文件句柄等。
- 移交执行权:操作系统将 CPU 的执行权交给程序的入口地址。
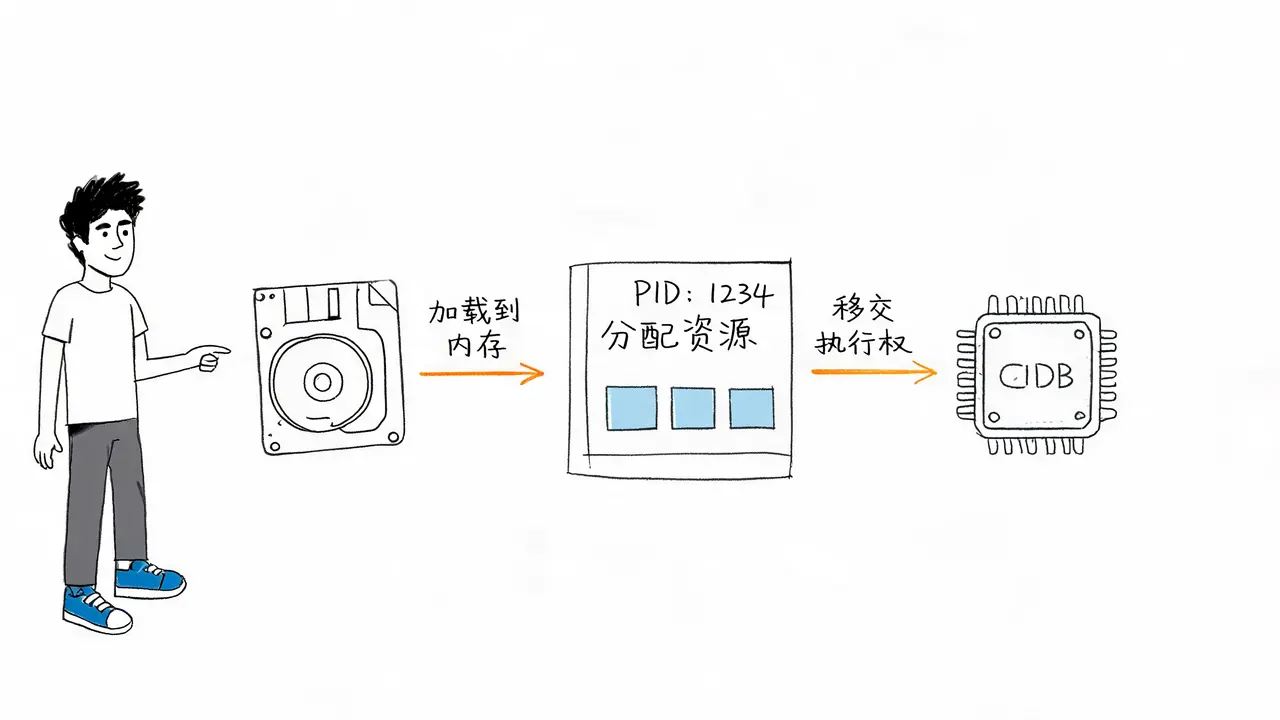
从这一刻起,CPU 开始逐条执行你的指令,程序正式运行。
总结
代码运行的全过程就像一条精密的工厂流水线:
- 人类编写高级语言代码。
- 编译器/解释器将其翻译成 CPU 能懂的机器语言。
- 操作系统调度资源,将程序加载到内存。
- CPU 执行指令并输出结果。
每个环节各司其职,共同将几行简单的文本代码转化为电脑上运行的复杂软件。