深入解析 Spring 循环依赖:三级缓存机制与失效边界
Spring 框架通过一套精巧的三级缓存机制解决了组件间互相引用导致的循环依赖问题。其核心思想是提前暴露尚未完全初始化的“半成品”对象,从而打破对象创建过程中的死锁状态。若未解决此问题,应用启动时将直接抛出异常,导致服务无法运行。
`` 是摘要与正文的分隔标记,请保留。什么是循环依赖?
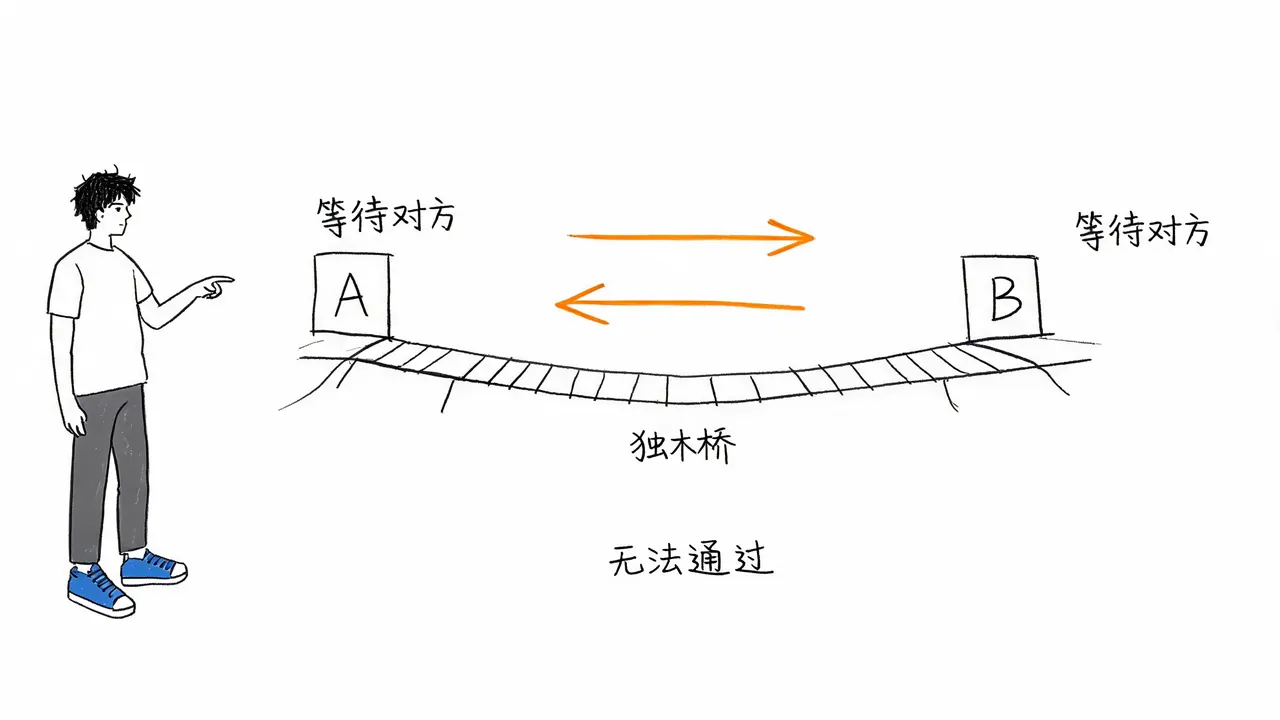
循环依赖是指组件 A 依赖组件 B,而组件 B 又依赖组件 A 的情况。这就像两个人过独木桥,都在等待对方先退一步,结果导致双方都无法通过,形成死锁。
在 Spring 容器中,创建一个 Bean 通常经历以下三个阶段:
- 实例化:通过构造函数创建一个空壳对象。
- 属性填充:将依赖的其他 Bean 注入到当前对象中。
- 初始化:执行初始化方法(如
@PostConstruct、InitializingBean等)。
当 Spring 创建 A 并填充属性时发现需要 B,便会去创建 B;而在创建 B 并填充属性时又发现需要 A,这就陷入了无限递归的“套娃”困境。
三级缓存机制详解
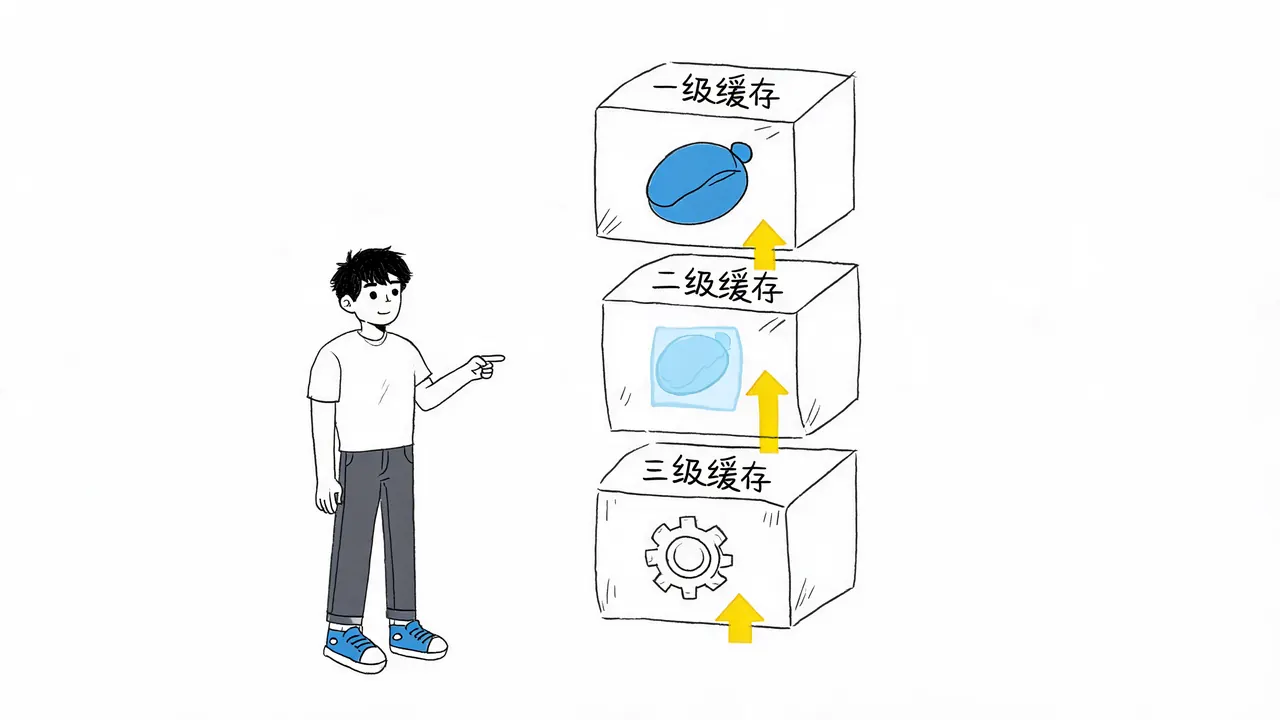
为了打破上述死循环,Spring 在内部维护了三个不同层级的缓存(Map):
- 一级缓存(Singleton Objects):存储完全创建好的成品对象。
- 二级缓存(Early Reference Objects):存储已经实例化但尚未填充属性的半成品对象。
- 三级缓存(Singleton Factories):存储对象工厂(ObjectFactory)。它不直接存储对象,而是存储一个能够生成对象的工厂函数。
创建流程推演
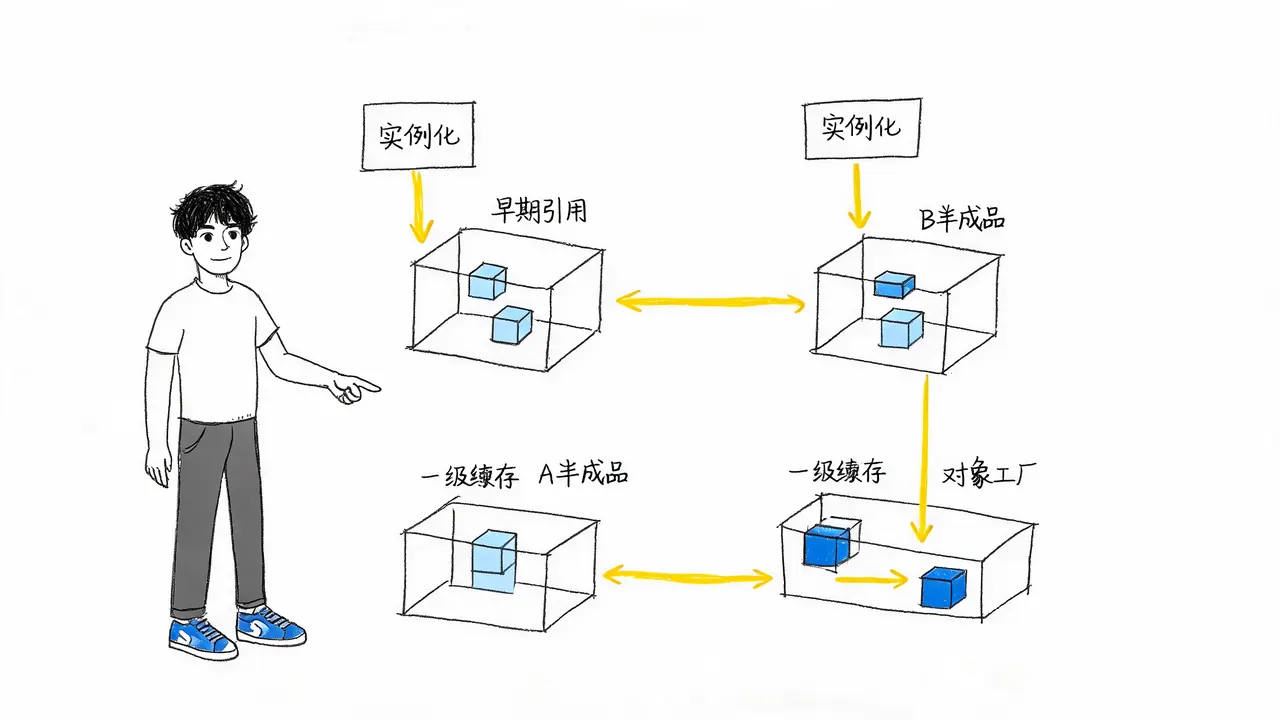
以 A 和 B 互相依赖为例,Spring 的处理流程如下:
-
创建 A:
- Spring 通过构造函数实例化 A(此时 A 为半成品)。
- 将 A 的对象工厂放入三级缓存。
- 开始填充 A 的属性,发现依赖 B,暂停 A 的创建,转去创建 B。
-
创建 B:
- Spring 实例化 B(此时 B 为半成品)。
- 将 B 的对象工厂放入三级缓存。
- 开始填充 B 的属性,发现依赖 A。
-
解决 A 的依赖:
- B 依次查询一级、二级、三级缓存寻找 A。
- 在三级缓存中找到 A 的对象工厂。
- 调用工厂获取 A 的早期引用(半成品),并将该对象放入二级缓存,同时从三级缓存中移除 A 的记录。
- B 拿到 A 的半成品,完成属性填充和初始化,变成成品放入一级缓存。
-
完成 A 的创建:
- 流程回到 A,A 从一级缓存中获取完整的 B。
- A 完成属性填充和初始化,变成成品放入一级缓存。
至此,死循环被打破,A 和 B 均成功创建。
为什么需要三级缓存?
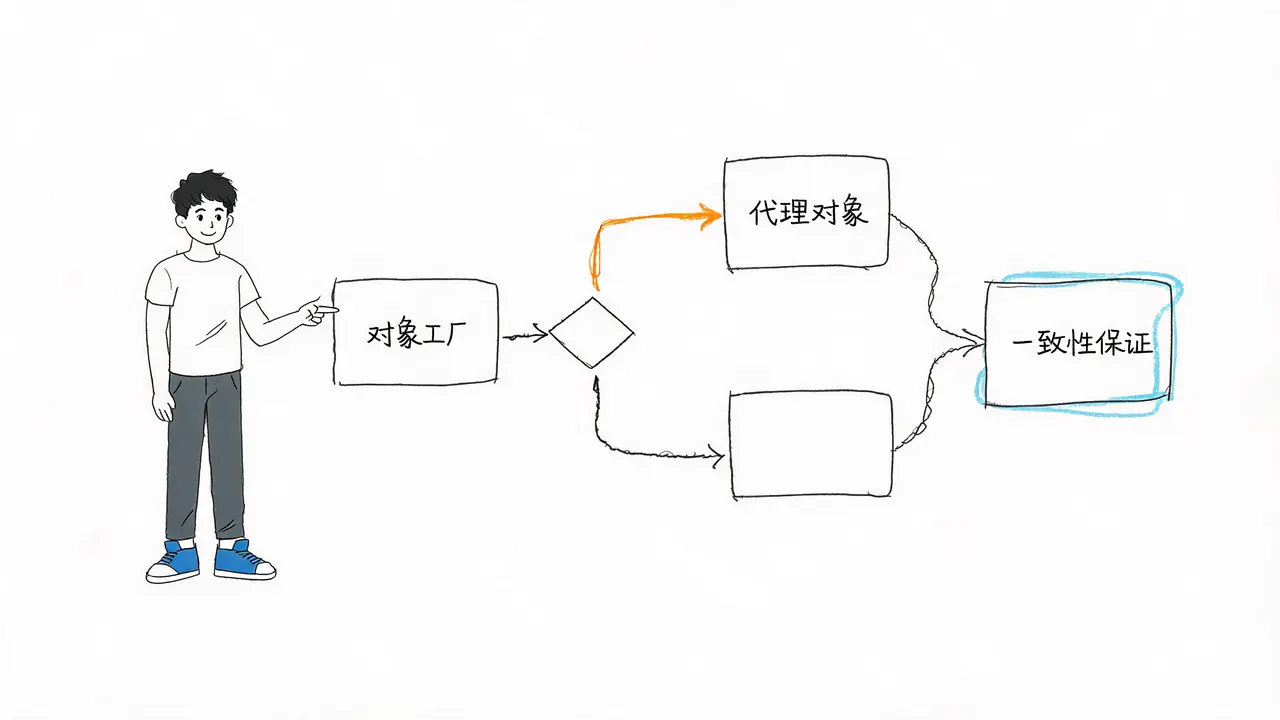
既然二级缓存可以存储半成品,为何还需要三级缓存?这主要是为了处理 AOP 代理问题。
如果 Bean A 需要被代理(例如添加了 @Transactional 注解),B 在依赖 A 时,拿到的不能是 A 的原始对象,而必须是 A 的代理对象。
- 三级缓存的作用:对象工厂在生成早期引用时,会判断当前 Bean 是否需要代理。
- 如果需要代理,则提前生成代理对象并放入二级缓存。
- 如果不需要,则直接返回原始对象。
- 一致性保证:通过三级缓存中的工厂机制,确保整个容器中所有地方拿到的都是同一个最终形态的对象(无论是原始对象还是代理对象),避免内存地址不一致的问题。
三级缓存的失效边界
Spring 的三级缓存机制并非万能,在以下两种情况下无法解决循环依赖,Spring 会直接抛出异常:
-
构造器注入(Constructor Injection)
- 构造器注入要求在实例化阶段就必须传入依赖对象。
- 此时对象连“半成品”都还未生成,无法放入任何缓存。
- Spring 无法提前暴露对象,因此无法打破循环。
-
原型模式(Prototype Scope)
- 原型作用域的 Bean 每次获取都会创建新实例。
- Spring 不会将原型 Bean 放入单例缓存中,因此无法通过缓存机制解决循环依赖。
总结与最佳实践
Spring 的三级缓存本质上是一种用空间换时间、用半成品换解耦的设计,它兜底了框架层面的依赖冲突。
然而,在实际开发中,循环依赖往往意味着代码模块之间耦合过重。这也是为什么在较新的 Spring 版本中,官方默认关闭了对循环依赖的支持。
- 理解原理:有助于看懂框架设计的良苦用心。
- 优化代码:写出高内聚、低耦合的代码,才是从源头解决循环依赖的关键。建议通过重构代码、引入中间层或调整依赖方向来消除循环依赖,而非依赖框架的缓存机制。