Java 序列化与反序列化:对象跨越内存、硬盘与网络的机制
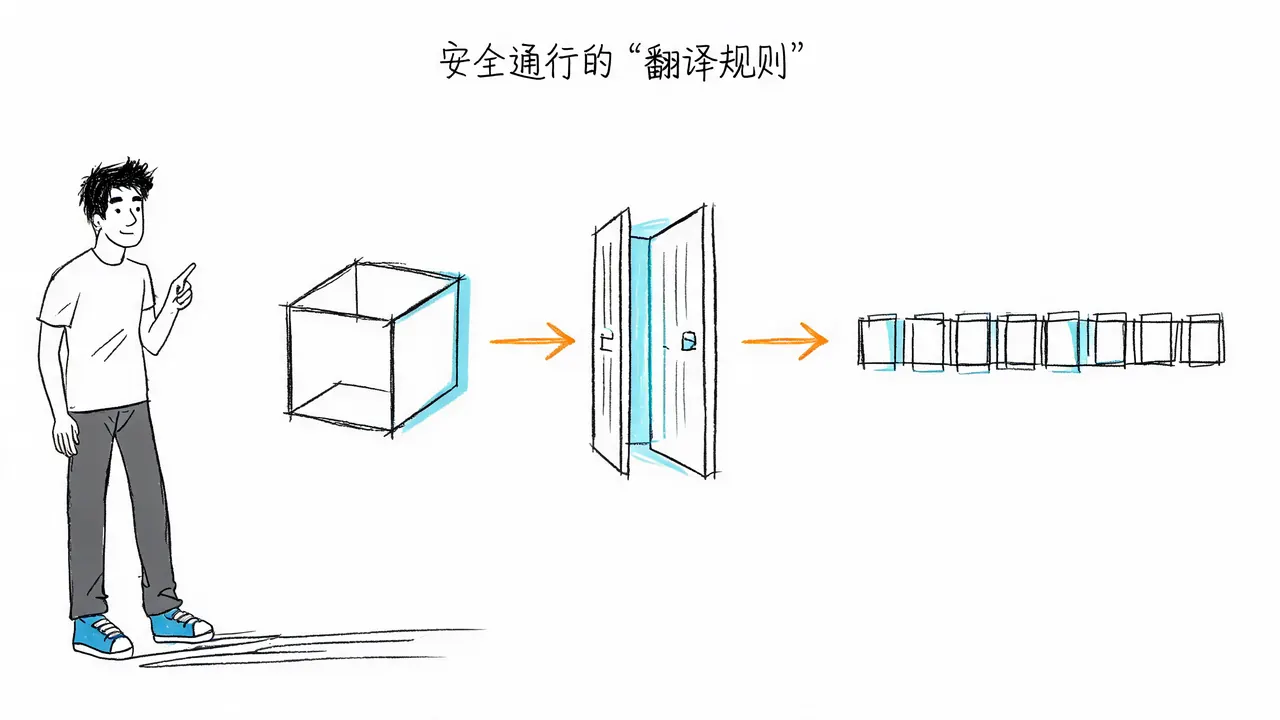
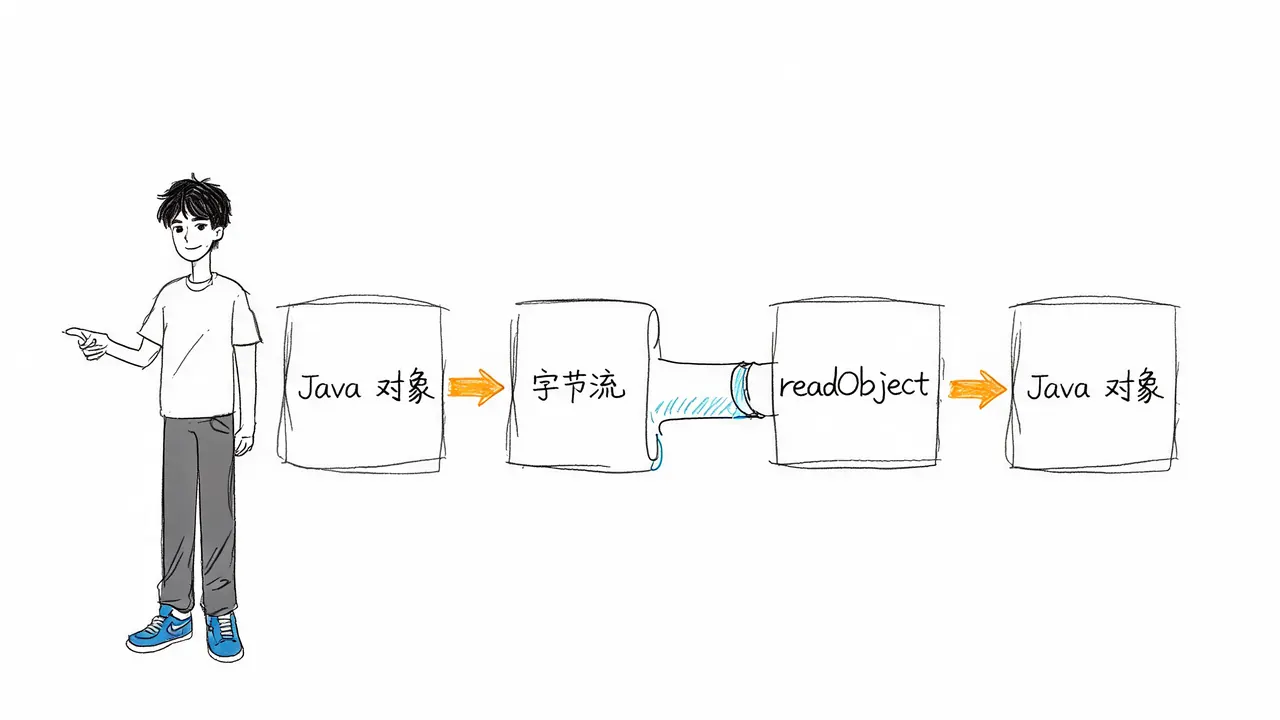
在 Java 开发中,序列化(Serialization)与反序列化(Deserialization)是处理数据持久化与网络传输的核心机制。简单来说,序列化是将内存中的 Java 对象转换为字节流的过程,而反序列化则是将字节流还原为 Java 对象的过程。
Java 对象仅存在于 JVM 的内存空间中,一旦断电或程序重启,数据即丢失;同时,对象无法直接通过网线发送给其他系统。因此,必须通过序列化机制,将对象“打包”为通用的字节流,使其能够脱离当前运行环境,独立存储于硬盘或穿越网络边界。
为什么对象不能直接存储或传输?
许多初学者常疑惑:为何不能直接将对象写入文件或存入数据库?
可以将 Java 对象想象为一件“立体的行李”,而硬盘文件或网络通道则如同安检机的履带,它们只识别扁平、连续的字节数据,无法处理立体的内存结构。若直接保存内存地址,一旦环境变更或程序重启,该地址将立即失效。
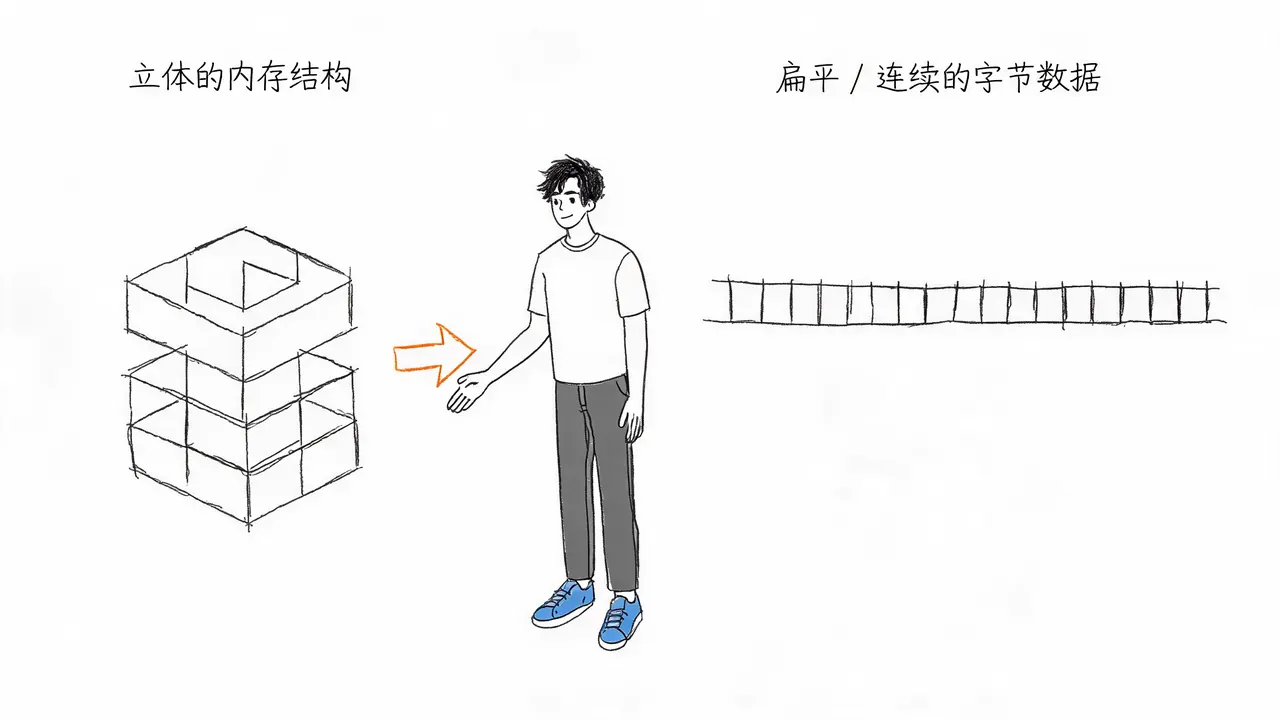
因此,序列化机制的作用在于:
- 拆解结构:将复杂的对象结构拆解。
- 压平数据:将其转换为通用的字节流。
- 独立存活:使数据能够脱离特定 JVM 环境,在硬盘或网络中安全传输。
序列化与反序列化的具体流程
在 Java 中,实现序列化与反序列化需要遵循特定的接口和类:
1. 实现 Serializable 接口
若希望某个对象具备被序列化的能力,其所属类必须实现 Serializable 接口。这相当于给对象贴上了“允许托运”的标签,表明该对象符合序列化规范。
2. 序列化(打包)
使用 ObjectOutputStream 输出流,调用其 writeObject 方法,将对象转换为字节流。该字节流可写入文件或通过网络发送。
3. 反序列化(拆包)
在数据接收端,使用 ObjectInputStream 输入流,调用其 readObject 方法,将字节流重新拼装还原为原始的 Java 对象。
这一“写”与“读”的过程,构成了一次完整的对称转换。
典型应用场景
序列化机制在分布式系统和缓存场景中应用广泛:
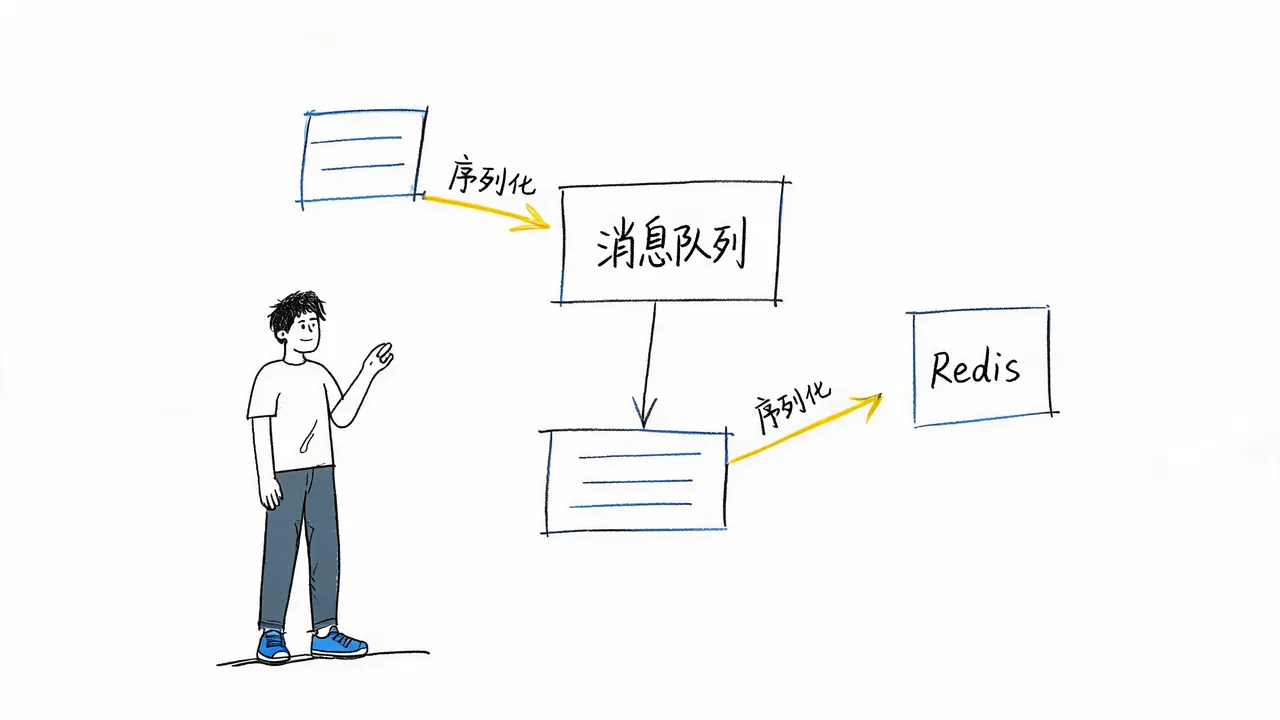
- 分布式网络传输:在微服务架构中,服务间调用接口或向消息队列(如 Kafka、RabbitMQ)发送消息时,底层均依赖序列化将对象转为字节流进行传输。
- 高性能缓存:例如,将用户登录后的信息对象序列化后存入 Redis。下次请求时,直接反序列化获取对象,避免了重新查询数据库和创建对象的性能开销。
关键限制与注意事项
并非对象中的所有字段都适合被序列化,开发者需注意以下两个边界条件:
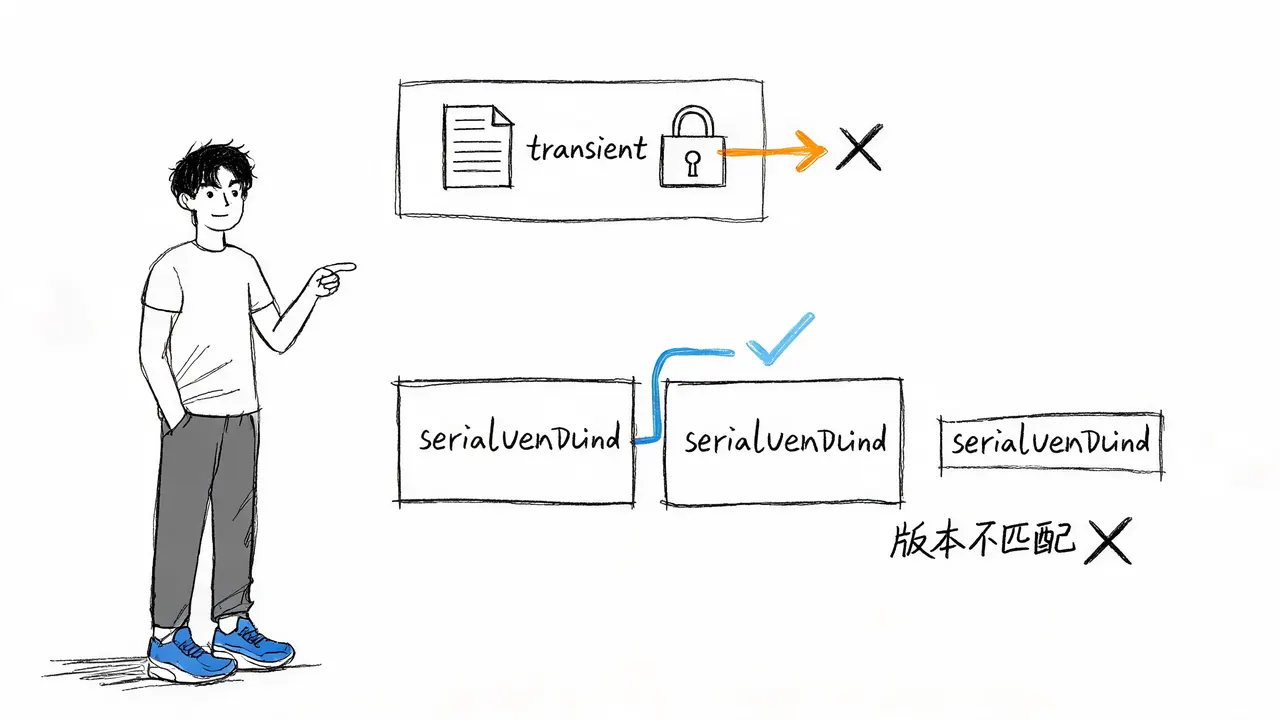
1. 使用 transient 关键字过滤敏感或临时数据
若对象中包含密码等敏感信息,或无需持久化的临时计算结果,应在字段前添加 transient 关键字。序列化时,JVM 会自动跳过该字段,相当于在打包前将“违禁品”剔除,确保数据安全与存储效率。
2. 管理序列化版本号(serialVersionUID)
反序列化时,系统需核对类的版本信息。若类结构发生变更(如新增属性),旧数据在还原时可能因版本不匹配而报错。
为解决此兼容性问题,建议在类中显式定义 serialVersionUID(序列化版本号)。只要版本号一致,系统即可尽量兼容处理结构变更,避免反序列化失败。
总结
理解序列化与反序列化,本质上是理解 Java 对象如何跨越内存、硬盘和网络边界的规则。它是一套让数据在不同环境间安全通行的“翻译规则”。掌握这一机制,开发者才能确保对象在复杂分布式系统中自由、安全地流转。