大模型检索不准?查询改写、拆分子问题与 HyDE 三种优化策略详解
在使用大模型(LLM)结合检索增强生成(RAG)技术时,检索不准是一个常见痛点。当模型无法从知识库中找到准确证据时,回答质量会大幅下降。针对这一问题,业界通常采用查询改写(Query Rewriting)、拆分子问题(Sub-question Decomposition)以及假设文档嵌入(HyDE, Hypothetical Document Embeddings)三种主要优化策略。
这三种方案并非解决同一种问题,而是针对不同的“检索缺口”提供了不同的解决思路。选择哪种策略,取决于具体场景下的数据特征和用户查询模式。
`` 是摘要与正文的分隔标记,请保留。查询改写:让口语化表达适配搜索引擎
查询改写的核心目的是将用户原始的自然语言查询,转换为更适合搜索引擎或向量数据库匹配的表达形式。
适用场景
当用户的提问过于口语化、模糊或缺乏关键术语时,直接检索往往难以命中相关文档。
示例:
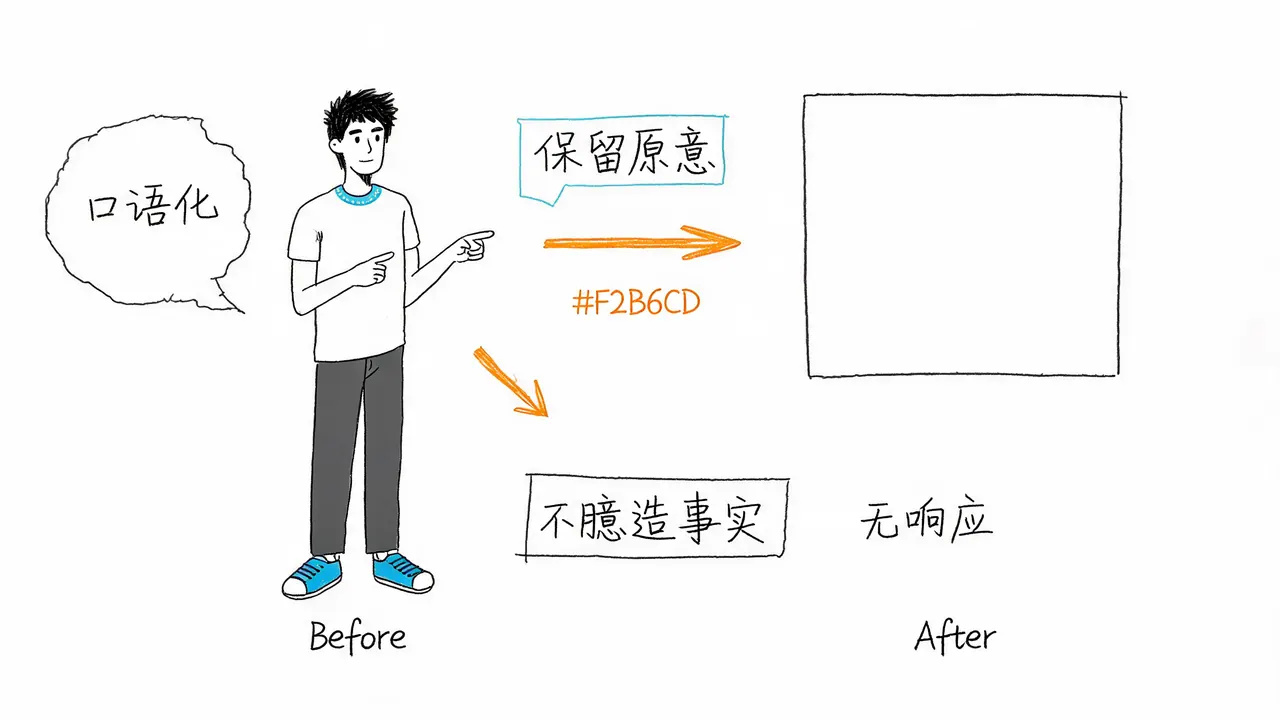
- 用户原始查询:“程序跑着跑着就没反应了。”
- 直接检索问题:这种口语化表达在技术文档中很少出现,难以匹配到具体的故障排查指南。
- 改写后查询:结合上下文(如已知的产品名称和版本),系统可以将其整理为“[产品名称] [版本] 无响应排查线索”。如果上下文中明确提到了“请求超时”,则可以进一步改写为“请求超时排查”。
关键原则:保留原意,不臆造事实
查询改写必须严格遵循**“保留并提炼原意”**的原则,严禁擅自加入用户未提供的故障原因或推断。
- 正确做法:将模糊说法写清楚,例如将“没反应”转化为“无响应”或“Hang”。
- 错误做法:如果用户未提及网络问题,改写时不能擅自加上“网络延迟导致的无响应”。
为什么不能臆造? 把模糊说法写清楚是更好的“翻译”,而替用户猜结论则是“误导”。后者可能会将搜索方向引向错误的领域,导致检索结果偏离用户真实意图。
拆分子问题:处理复杂的多维度需求
拆分子问题策略适用于那些包含多个独立取证需求的复杂综合性问题。
适用场景
当一个问题涉及多个实体或多个维度,且单篇文档很难同时详细覆盖所有对比点时,拆分检索更为有效。
示例:
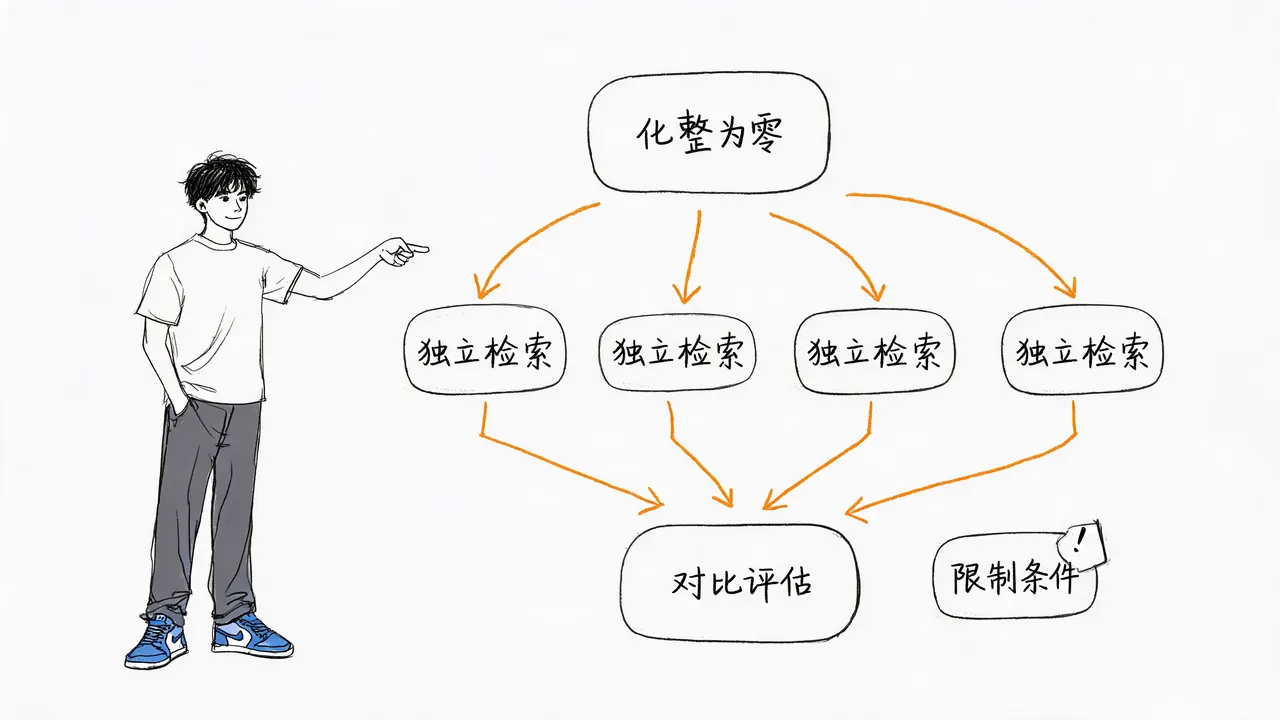
- 用户问题:“比较 A 方案和 B 方案的部署条件与维护成本。”
- 问题拆解:
- A 方案的部署条件
- B 方案的部署条件
- A 方案的维护成本
- B 方案的维护成本
- 执行逻辑:分别对这四个子问题进行独立检索,获取各自最相关的文档片段。
- 最终汇总:在资料找齐后,按照原问题的逻辑框架(即对比评估)进行整合,生成最终答案。
关键原则:保留原问题的限制条件
拆分检索的目的是“化整为零”去获取资料,但在拼装答案时,必须严格遵循原问题的逻辑和限制条件。
- 风险:如果每个子问题单独查回来的资料都很完整,但合并时忽略了原问题要求的“对比”视角,最终答案可能只是两个独立方案的罗列,而非用户想要的对比评估。
- 建议:在提示词(Prompt)中明确指示模型,在整合子查询结果时,必须基于原问题的约束进行综合推理。
HyDE:弥补短查询与长文档的表达差距
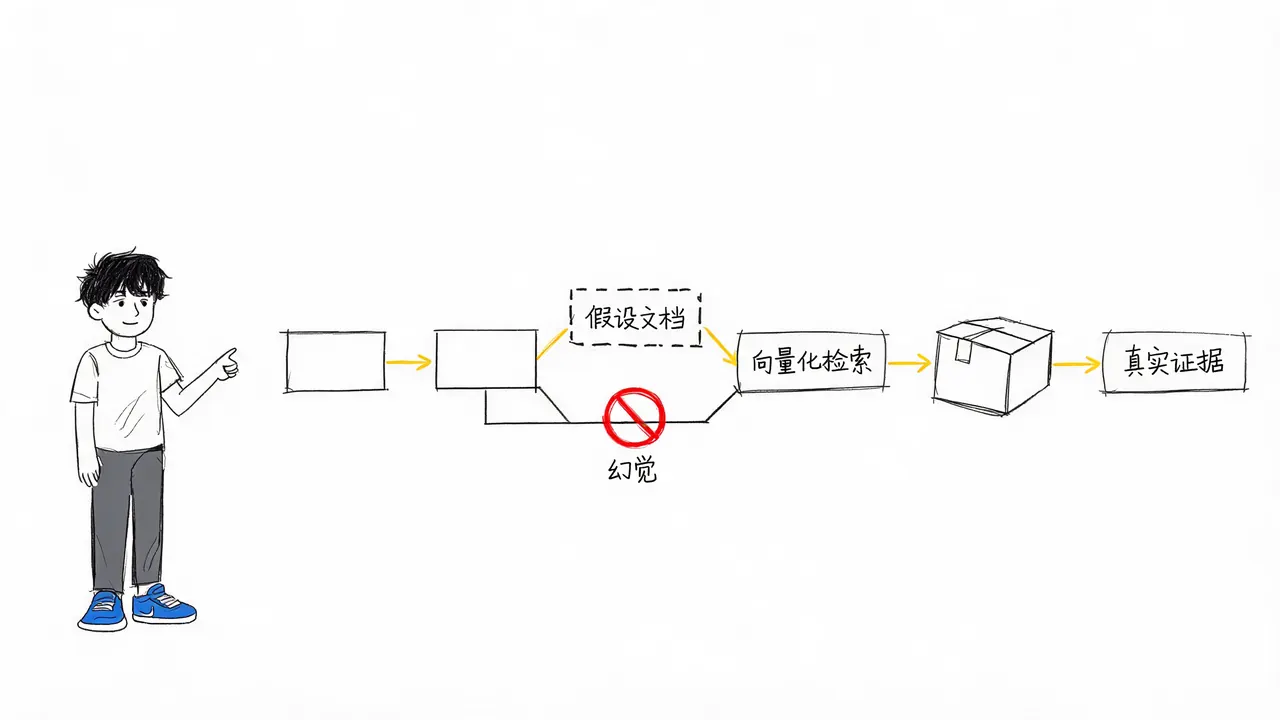
HyDE(Hypothetical Document Embeddings) 是一种更为高级的检索优化策略,其核心思路是先生成一段假设性的答案文档,再用这段文档去检索真实语料。
工作原理
- 生成假设文档:让大模型根据用户问题,生成一段“如果知识库里有能回答这个问题的文章,它大概会长什么样”的文本。
- 向量化检索:将这段生成的假设文档转换为向量,用于在向量数据库中搜索真实的相关文档。
适用场景
- 短查询匹配长文档:用户的查询往往很短,缺乏上下文和关键词;而知识库中的文档通常较长,包含丰富的相关词汇。
- 表达差距大:当用户使用的术语与文档中的术语存在较大差异时,HyDE 可以通过生成包含丰富领域词汇的假设文档,提高匹配的命中率。
关键风险与应对:假设不等于事实
HyDE 策略最大的风险在于**“幻觉”**。生成的假设文档可能包含错误信息或事实偏差。
- 严禁直接输出:假设文档仅作为检索线索,绝不能直接作为最终答案交给用户。
- 最终答案必须基于证据:无论假设文档看起来多么合理,最终输出给用户的结论必须由实际检索到的真实证据支持。
- 防止检索偏移:在调优过程中,需监控假设文档是否将检索方向带偏到了其他无关领域。如果假设文档中的错误关键词导致检索到了不相关的文档,需要优化生成假设文档的 Prompt,或结合其他策略使用。
如何选择优化策略?
在实际应用中,建议根据检索缺口的类型来选择策略:
| 检索缺口类型 | 推荐策略 | 说明 |
|---|---|---|
| 表达口语化/模糊 | 查询改写 | 将自然语言转化为更适合搜索的术语,保留原意。 |
| 问题复杂/多维度 | 拆分子问题 | 将复杂问题分解为多个独立子查询,分别检索后汇总。 |
| 查询短/关键词缺失 | HyDE | 生成假设文档以丰富检索向量,弥合表达差距。 |
| 多种问题并存 | 组合使用 | 例如先改写再拆分,或先拆分再对每个子问题使用 HyDE。 |
成本与收益评估
增加检索优化环节(如生成假设文档、多次检索、合并结果)会带来额外的生成延迟和计算成本。
- 评估方法:使用相同的测试问题集,对比优化前后的正确证据召回率(Recall)与端到端延迟/成本。
- 决策依据:只有当正确证据的增加显著提升了最终答案质量,且付出的延迟与成本在可接受范围内时,才值得引入复杂的优化策略。
总结
各种检索技巧的价值,最终都体现在找到那份真实的证据上,而不在于让搜索前的文本看起来有多像个答案。
- 查询改写是更好的翻译,避免误导。
- 拆分子问题是化整为零,确保逻辑完整。
- HyDE是借假修真,但必须回归真实证据。
开发者应根据具体业务场景,灵活组合这些策略,并在成本与效果之间找到最佳平衡点。