I/O多路复用之select:原理、价值与局限性
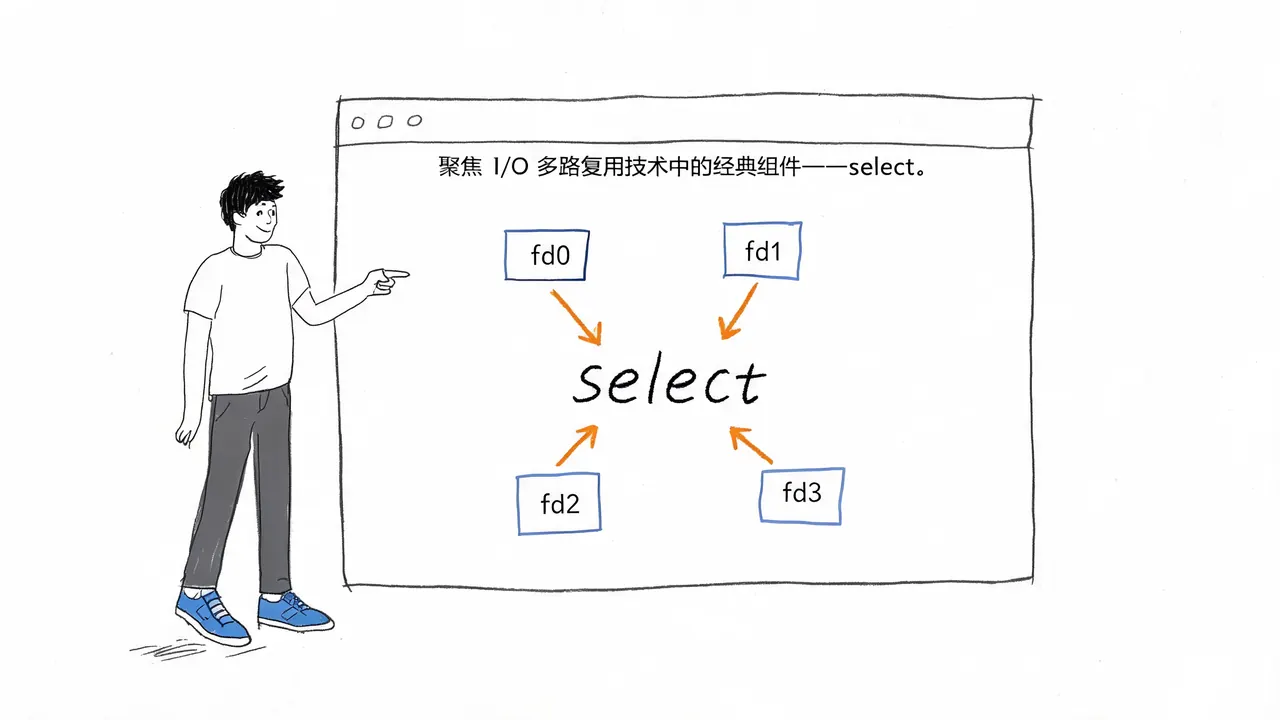
大家好,今天我们将聚焦 I/O 多路复用技术中的经典组件——select。
作为 Linux 系统早期核心的 I/O 复用方案,select 虽已不是当前高并发场景的首选,但它的设计思路和实现逻辑是理解后续 epoll 等高级方案的关键。本文将从技术背景、底层原理和核心价值三个维度,带大家精准吃透 select。
技术背景:为何需要 select?
要理解 select 的价值,首先得回到它诞生前的技术痛点,搞清楚它为什么会出现。在没有 I/O 多路复用机制时,处理多个文件描述符(File Descriptor, FD)主要有两种方案,且都存在明显的性能瓶颈。
1. 多进程/多线程模型
为每个 FD 单独创建进程或线程来处理 I/O。这种方案的问题非常突出:
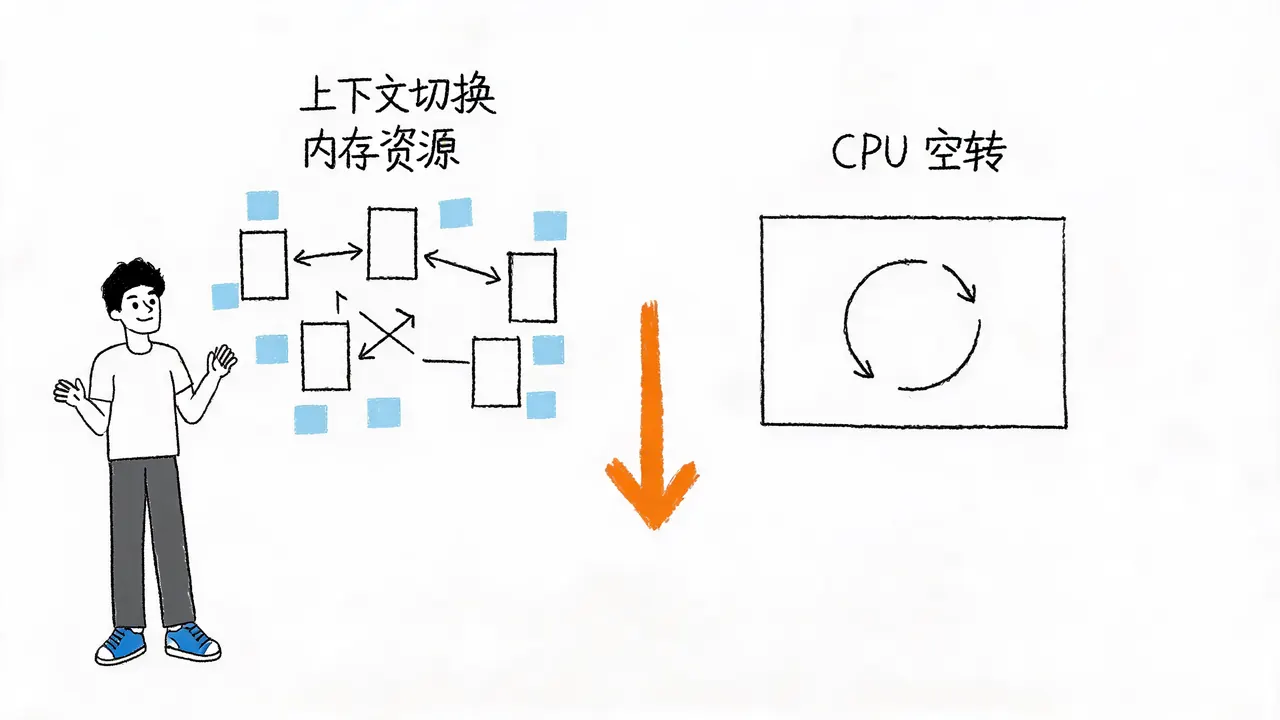
- 上下文切换开销极大:频繁的进程或线程切换消耗大量 CPU 资源。
- 内存资源占用高:每个进程需要独立的地址空间。
- 资源迅速耗尽:当 FD 数量达到数百甚至上千时,系统资源会迅速耗尽,无法支撑大规模并发。
2. 非阻塞轮询模型
通过 fcntl 将 FD 设为非阻塞,然后循环调用 read/write 检查状态。这种方式会导致:
- CPU 空转:即便所有 FD 都未就绪,进程仍在反复轮询。
- CPU 利用率极低:大量的 CPU 周期浪费在无意义的检查上。
正是这两个核心痛点,催生了 select 这类 I/O 多路复用技术。
底层原理:智能调度员的工作流程
select 的底层实现原理其实并不复杂,我们可以把它比作一个“智能调度员”。它的核心武器叫 fd_set,可以理解成一个任务清单,清单上每个格子对应一个文件描述符(即每个连接的专属编号)。
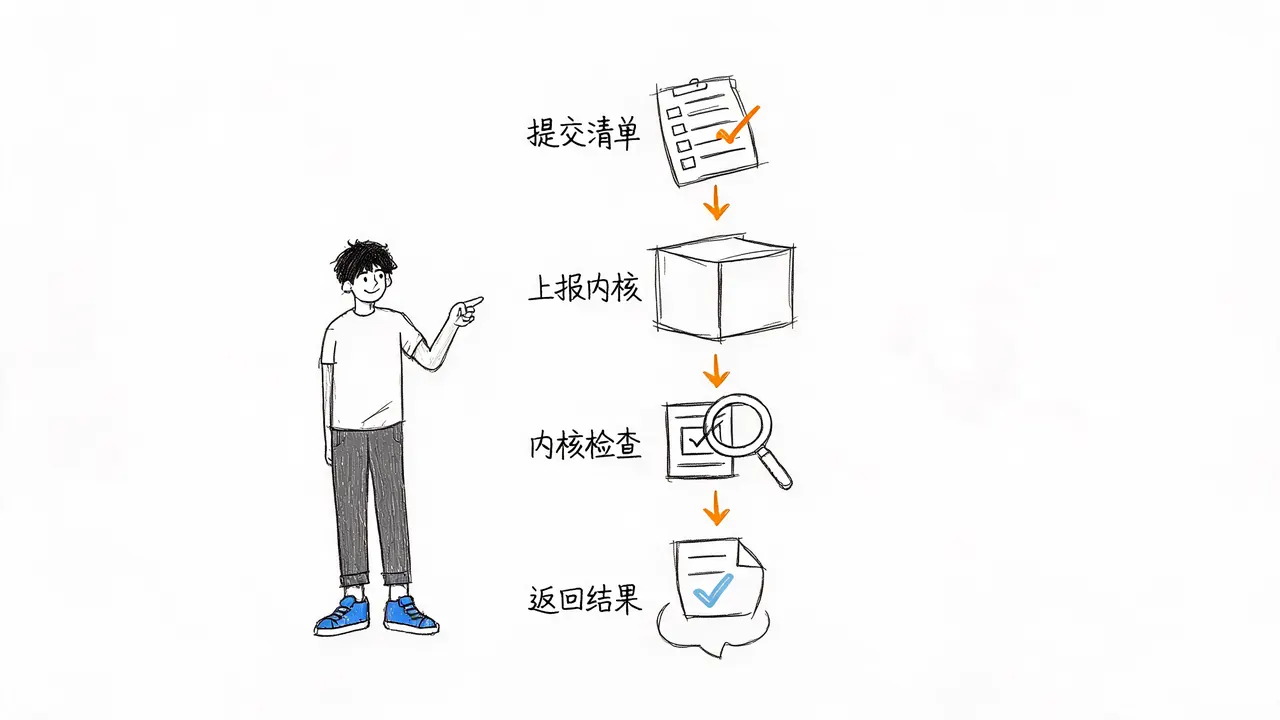
具体流程分为四步:
- 提交清单:我们先给调度员
select一份打好勾的清单,告诉它要盯着哪些连接(例如监听三个连接,就在清单上对应这三个编号的格子打个勾)。 - 上报内核:
select会把这份清单交给内核大总管。这一步就像是调度员把任务上报给管理层。 - 内核检查:内核大总管会挨个检查清单上的连接,看看哪个有数据可读、能写入或者出了异常,把有情况的连接在清单上做个标记。
- 返回结果:内核再把标记好的清单还给
select,select叫醒等待的程序,告知哪些连接有情况。程序接下来就只处理那些被标记的连接,无需再“瞎忙活”。
核心价值:select 的优势
对比之前的两种方案,select 的价值非常明确:
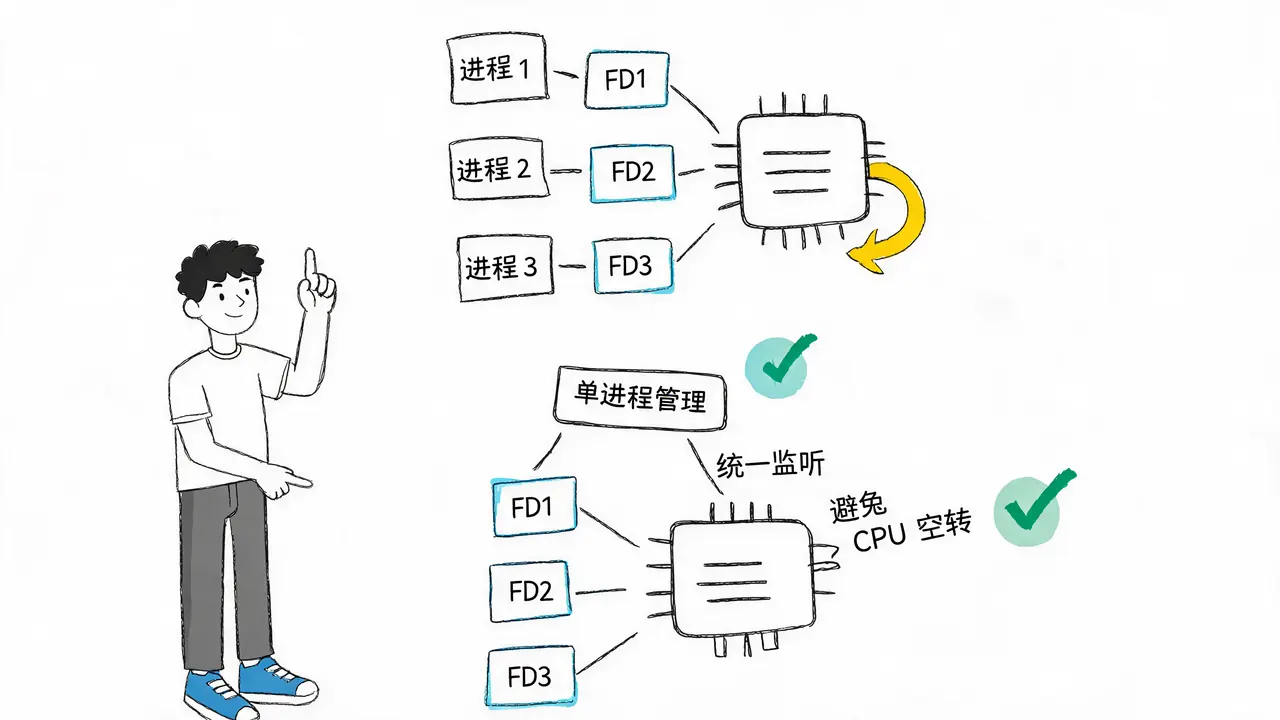
- 单进程管理多 FD:通过位图批量监听多个 FD,无需为每个 FD 创建进程或线程,大幅降低了内存占用和上下文切换开销。
- 避免 CPU 空转:
select调用后,进程会阻塞在内核态,直到有 FD 就绪或超时才返回。这让 CPU 资源能被更高效利用,彻底解决了非阻塞轮询的空转问题。 - 统一监听多事件类型:
select支持同时监听可读、可写、异常三类事件,通过三个独立的fd_set分别管理。相比单独监听各类事件的方案,效率提升显著。
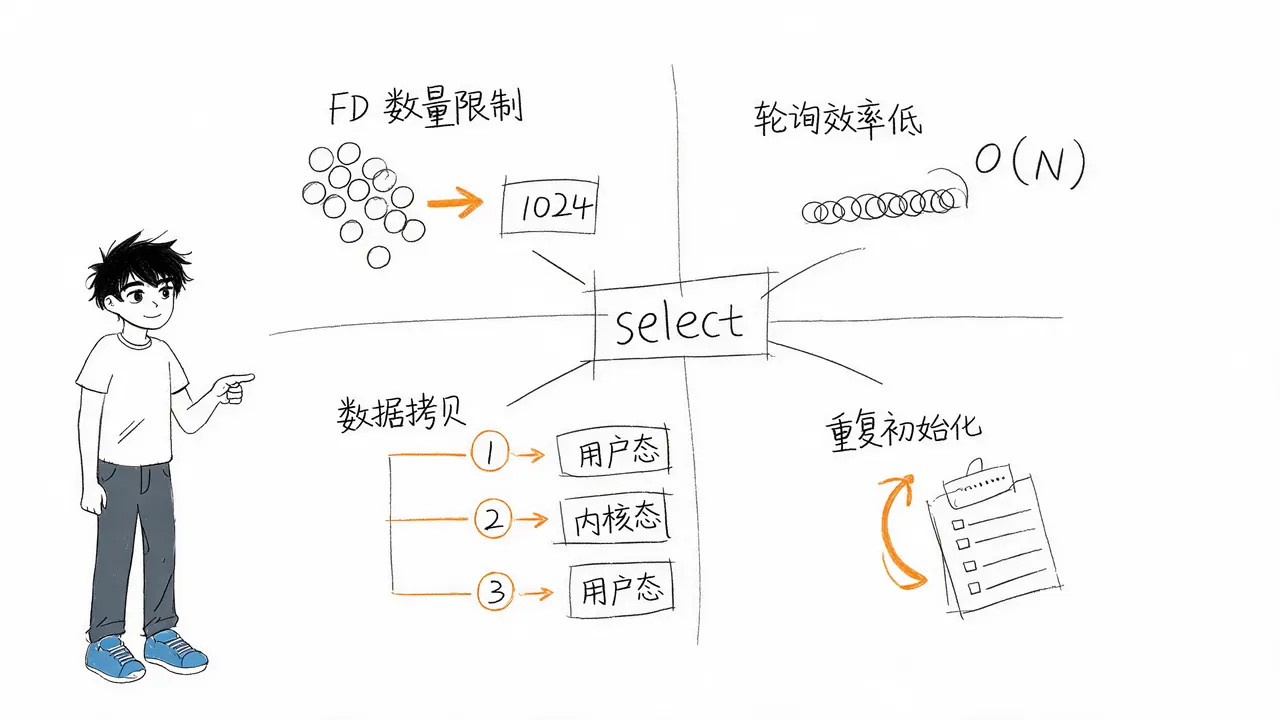
局限性:为何被 epoll 取代?
当然,作为早期方案,select 的局限性我们必须明确,这也是后续 epoll 出现的原因:
- FD 数量限制:
FD_SETSIZE的硬限制导致其无法监听超过 1024 个 FD。虽可通过重新编译内核修改,但灵活性极差。 - 轮询效率低:内核需遍历所有监听的 FD,时间复杂度为 $O(N)$。FD 数量越多,遍历开销越大。
- 数据拷贝开销:每次调用
select都要完成三次fd_set的完整拷贝(用户态到内核态,内核态到用户态)。当 FD 数量较多时,拷贝成本不可忽视。 - 用户态重复初始化:
select返回后,fd_set会被内核修改,仅保留就绪 FD 的标记。下次调用前必须重新执行FD_ZERO和FD_SET操作,流程繁琐。
总结
总的来说,select 虽有明显局限性,但它首次标准化了 I/O 多路复用的核心逻辑:通过内核批量监听 FD 并反馈就绪状态,为后续 I/O 复用技术奠定了基础。理解 select 的设计缺陷,后续更能帮助咱们掌握 epoll 方案的优化思路。
关于 select 的技术解析就到这里。如有疑问可在评论区留言,下期我们将拆解 epoll 的技术原理,咱们下期见。