终极I/O多路复用神器:epoll 深度解析
在后台开发、网络编程以及高性能服务器引擎(如 Nginx、Redis、Netty)的构建中,epoll 是一个无法绕开的核心概念。作为 Linux 系统下终极的 I/O 多路复用神器,它解决了传统方案在高并发场景下的性能瓶颈。
本文将深入探讨 epoll 的诞生背景、底层实现原理、两种触发模式(LT/ET)的区别,以及其相较于 select 和 poll 的核心优势。
1. 背景:从“人海战术”到 I/O 多路复用
随着互联网的发展,高并发场景日益普遍。早期的服务器模型常采用“一个连接一个线程”的策略,这类似于开一家奶茶店:每来一位顾客,就安排一名员工一对一服务。
- 小规模场景:100 位顾客对应 100 名员工,尚可维持。
- 大规模场景:当顾客数量达到数万甚至百万级时,需要创建同等数量的线程。
这种“人海战术”存在严重缺陷:
- 资源消耗巨大:每个线程都占用独立的内存空间和 CPU 资源。
- 上下文切换开销高:线程间的频繁切换会消耗大量 CPU 时间。
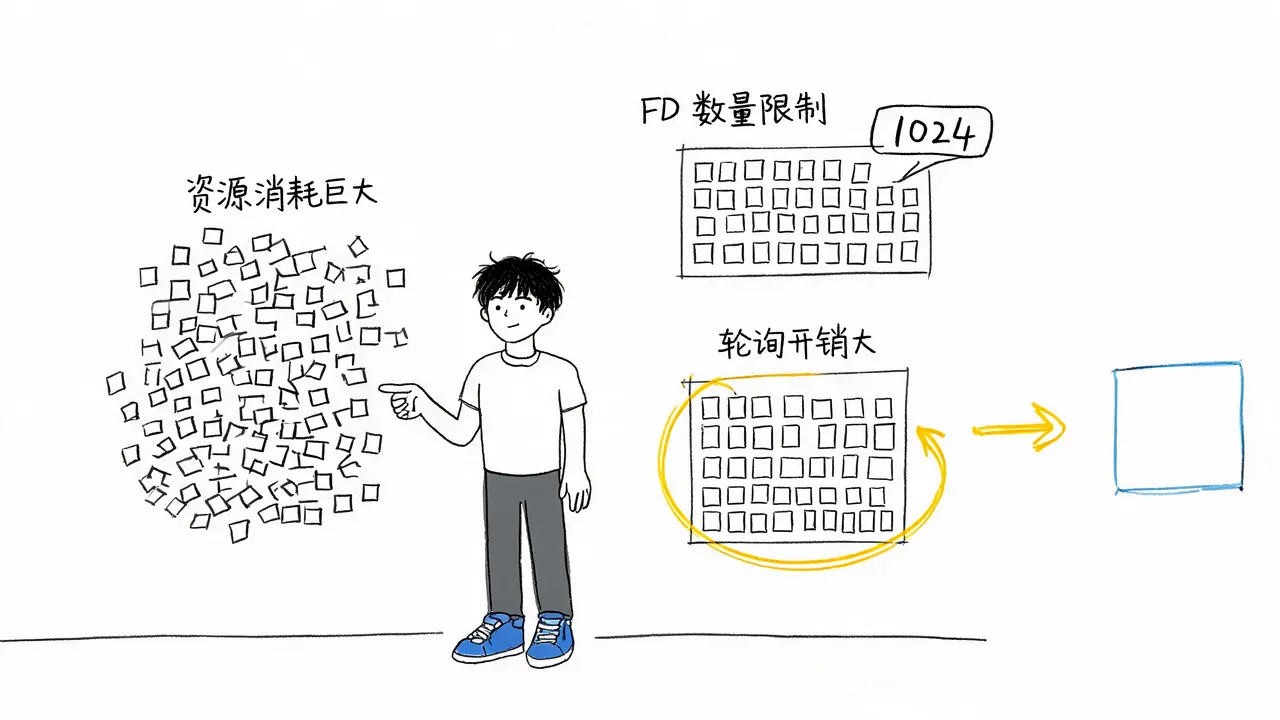
- 系统崩溃风险:当文件描述符(FD)数量达到数百或上千时,系统资源迅速耗尽,导致服务不可用。
为了解决这一问题,select 机制应运而生,它允许单进程管理多个 FD,大幅降低了内存占用和上下文切换开销。然而,select 存在明显的局限性:
- FD 数量限制:通常硬编码限制为 1024 个。
- 轮询开销大:每次调用都需要遍历所有 FD,时间复杂度为 $O(N)$。
- 数据拷贝频繁:每次调用都需将 FD 列表从用户态拷贝到内核态。
为了突破这些瓶颈,Linux 内核团队设计了 epoll,旨在消除轮询开销、降低数据拷贝成本,并实现真正的高并发 I/O 高效处理。
2. epoll 的底层实现原理
epoll 的高效性主要源于以下三个核心设计:
2.1 事件驱动模式(Event-Driven)
select 和 poll 采用“主动点名”的方式,即内核需要遍历所有注册的 FD 来检查是否有事件发生。而 epoll 采用“举手示意”的事件触发机制:
- 机制:只有当某个 FD 发生事件(如数据到达)时,内核才会通过回调函数将该 FD 加入就绪队列。
- 优势:复杂度从全量扫描的 $O(N)$ 降低为精准通知的 $O(1)$,实现了性能的质的飞跃。
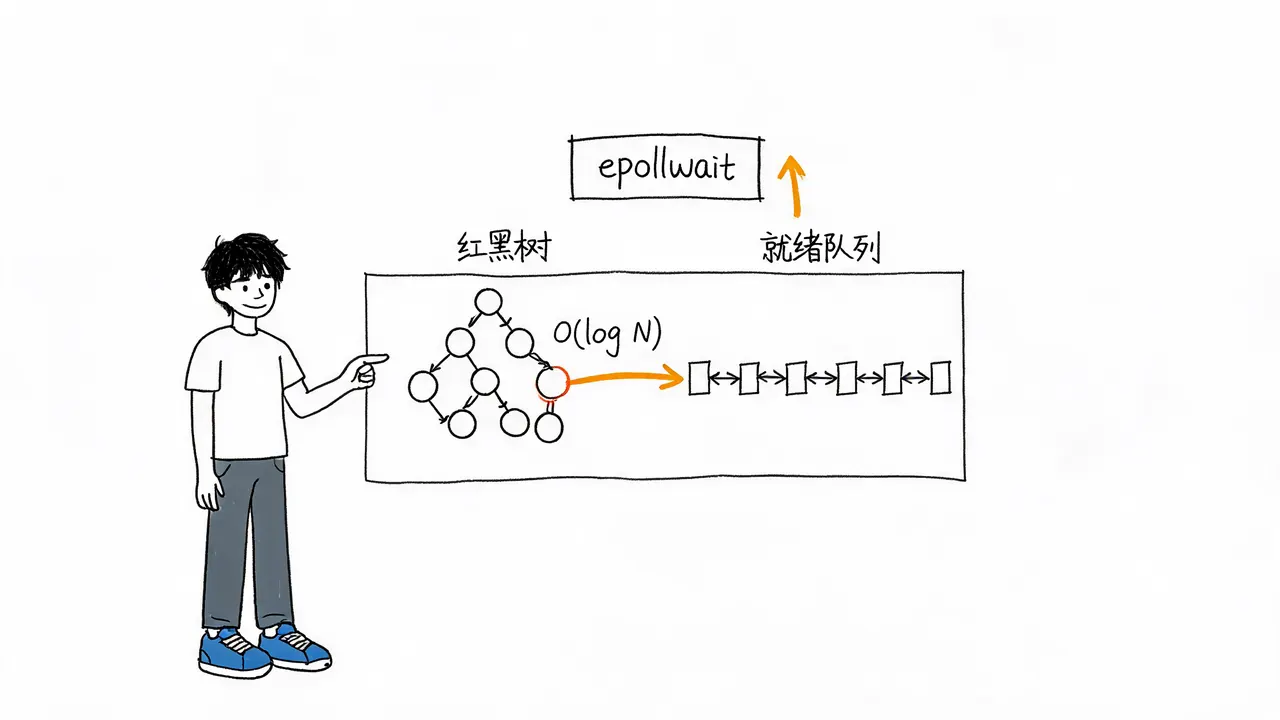
2.2 内核红黑树管理(Red-Black Tree)
在 select 中,每次调用都需要将 FD 列表从用户态传递到内核态。epoll 通过 epoll_ctl 接口,在第一次注册时将 FD 列表永久存储在内核的红黑树中:
- 持久化存储:后续调用
epoll_wait时无需重复传递 FD 列表,极大降低了系统调用开销。 - 高效管理:红黑树作为平衡二叉搜索树,其插入、删除和查找的时间复杂度均为 $O(\log N)$。这意味着即使监听十万、百万级 FD,管理效率依然极高,且没有固定数量限制,仅受系统内存约束。
2.3 就绪队列(Ready List)
当某个 FD 有事件发生时,内核会将其加入一个双向链表构成的就绪队列。调用 epoll_wait 时,内核直接将该队列中所有活跃的 FD 一次性返回给用户程序:
- 无需轮询:内核不再挨个询问每个 FD 是否有数据,而是直接从就绪链表中提取。
- 高效返回:只返回有事件的 FD,避免了无效数据的拷贝和处理。
3. 两种触发模式:LT 与 ET
epoll 提供了两种通知方式,开发者需根据场景选择:
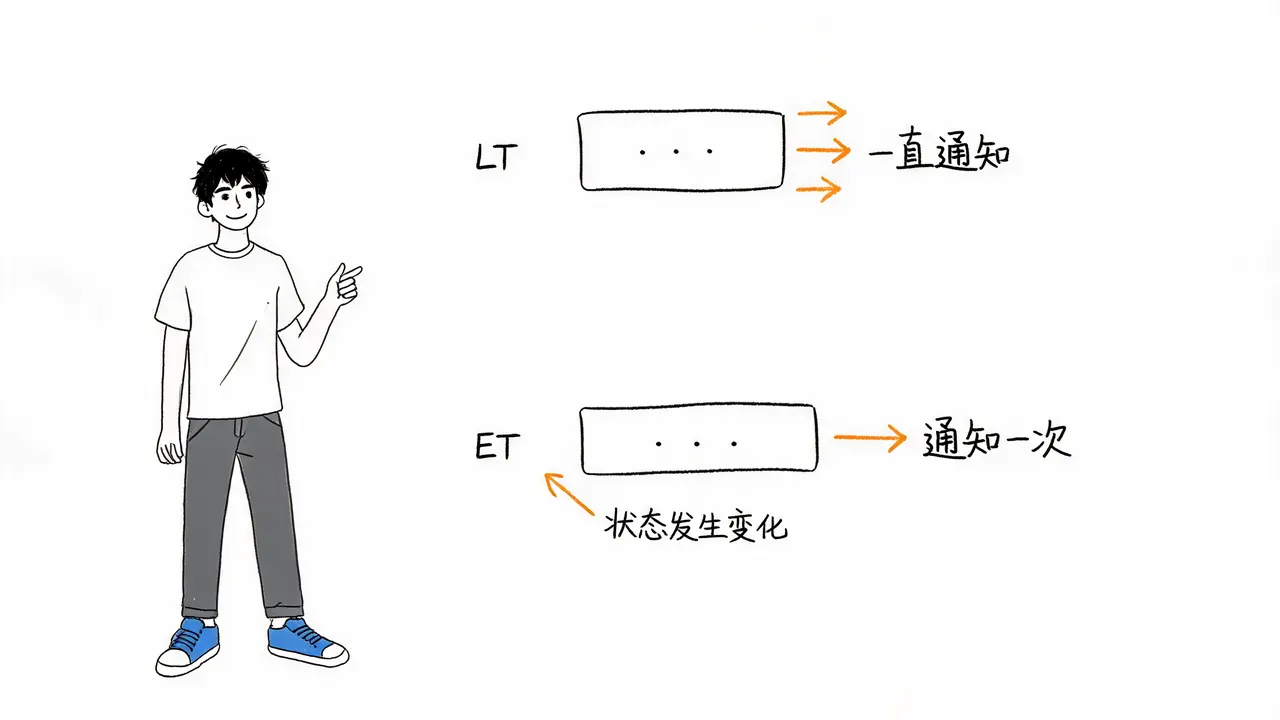
3.1 水平触发(Level-Triggered, LT)
这是 epoll 的默认模式。
- 逻辑:只要 FD 处于就绪状态(如缓冲区中有未读数据),
epoll_wait就会一直通知。 - 示例:客户端发送 100 字节数据,程序只读了 50 字节。下次调用
epoll_wait时,该 FD 仍会被通知,提醒“还有数据未处理”。 - 优点:编程简单,容错率高,不易漏掉数据。
- 适用场景:新手入门或逻辑复杂的业务场景。
3.2 边缘触发(Edge-Triggered, ET)
这是高性能场景下的首选模式,Nginx 等高性能服务器均采用此模式。
- 逻辑:仅在 FD 状态发生变化时(如从无数据变为有数据)通知一次。之后即使缓冲区中仍有未读数据,也不会再通知。
- 优点:通知次数极少,效率极高。
- 注意事项:
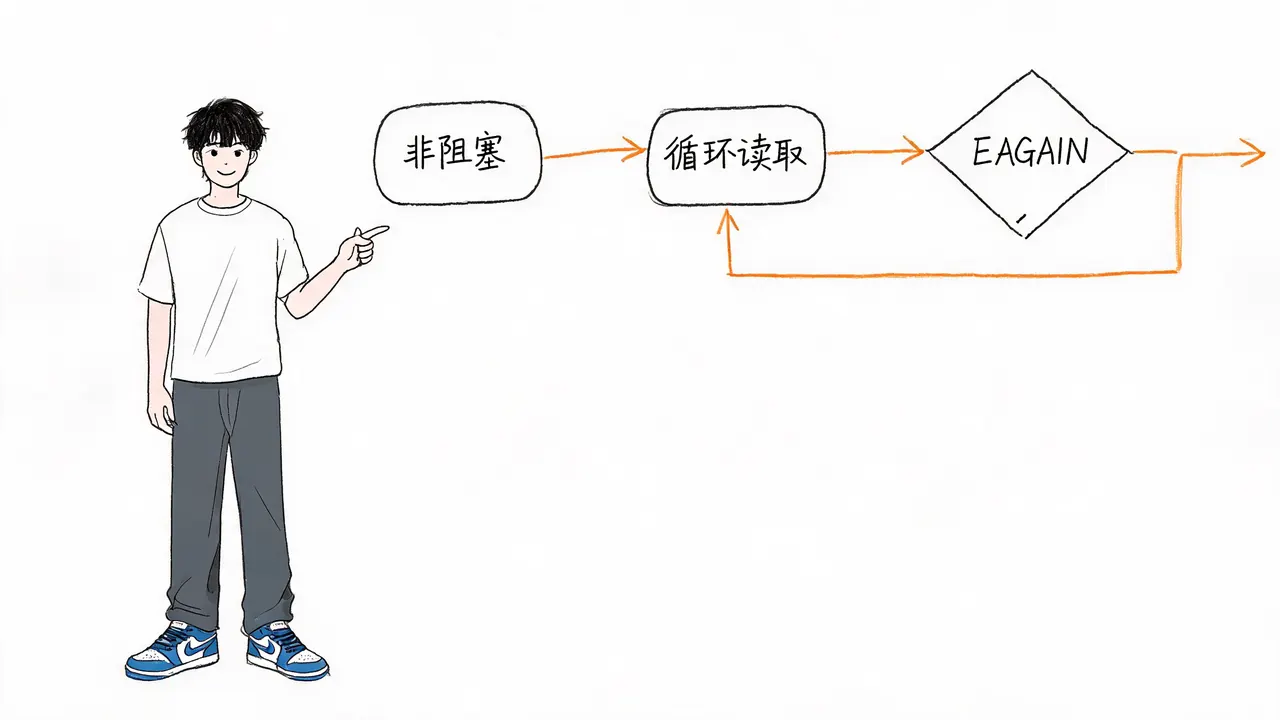
- 必须设置非阻塞:FD 必须设为非阻塞模式,否则在处理数据时可能因等待而卡住。
- 必须读完数据:收到通知后,必须循环读取数据,直到返回
EAGAIN或EWOULDBLOCK错误,确保缓冲区清空。否则,未读完的数据将永远无法收到后续通知。
4. epoll 的核心优势总结
基于上述原理,epoll 在高并发 I/O 处理中展现出显著优势:
- 无 FD 数量限制:依托红黑树,轻松管理百万级连接。
- 无轮询开销:事件驱动机制使得查找就绪 FD 的效率接近 $O(1)$,远快于
select的 $O(N)$ 遍历。 - 数据拷贝少:仅将就绪 FD 的信息传给用户程序,避免了全量拷贝。
- 监听信息持久化:FD 注册后无需反复设置,减少了系统调用次数。
5. 局限性与适用场景
尽管 epoll 性能卓越,但它并非万能:
- 平台局限性:
epoll是 Linux 系统独有的特性。在编写跨平台程序(如同时支持 Windows 和 Linux)时,仍需兼容select或其他方案。 - 适用建议:在 Linux 环境下,若需构建高并发 I/O 密集型应用,
epoll绝对是首选方案。
通过理解 epoll 的定义、核心原理及触发模式,开发者可以更有效地利用这一神器,构建高性能的网络服务。