Agent 声称任务完成却交付空文件?如何建立可靠的交付验收机制
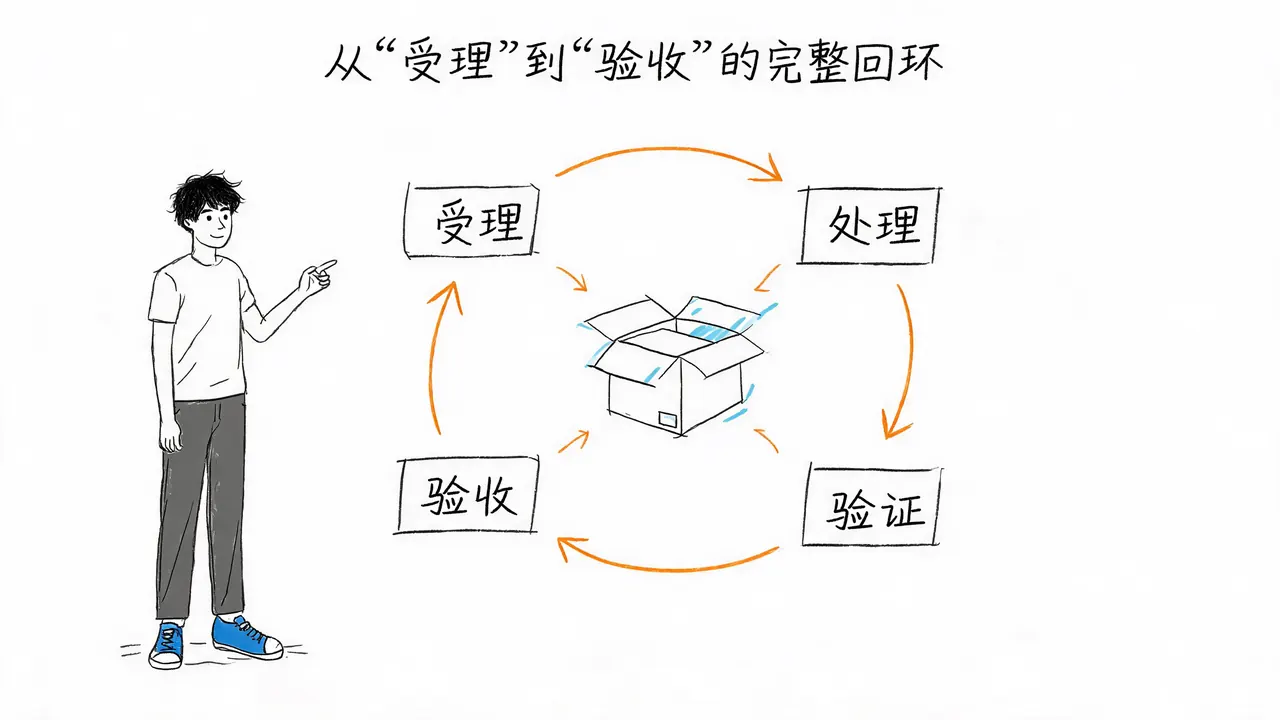
在 AI Agent 的实际应用中,我们经常遇到一种令人困惑的现象:Agent 自信地报告“任务已完成”,但用户拿到的却是一个空文件,或者是一个无法访问的无效链接。这种“报喜不报忧”的情况,往往源于系统对“完成”定义的模糊。
如果底层系统将“拿到地址”或“请求被受理”直接等同于“任务完成”,就极易产生这种假完成状态。本期内容将深入探讨如何检查实际交付物,避免仅依赖 Agent 的进度播报,从而确保最终结果的可靠性。
``核心误区:受理不等于验收
要理解这个问题,首先需要区分“工具受理”与“业务验收”两个概念。
以一个常见的异步导出接口为例,其工作流程通常如下:
- 用户发起请求。
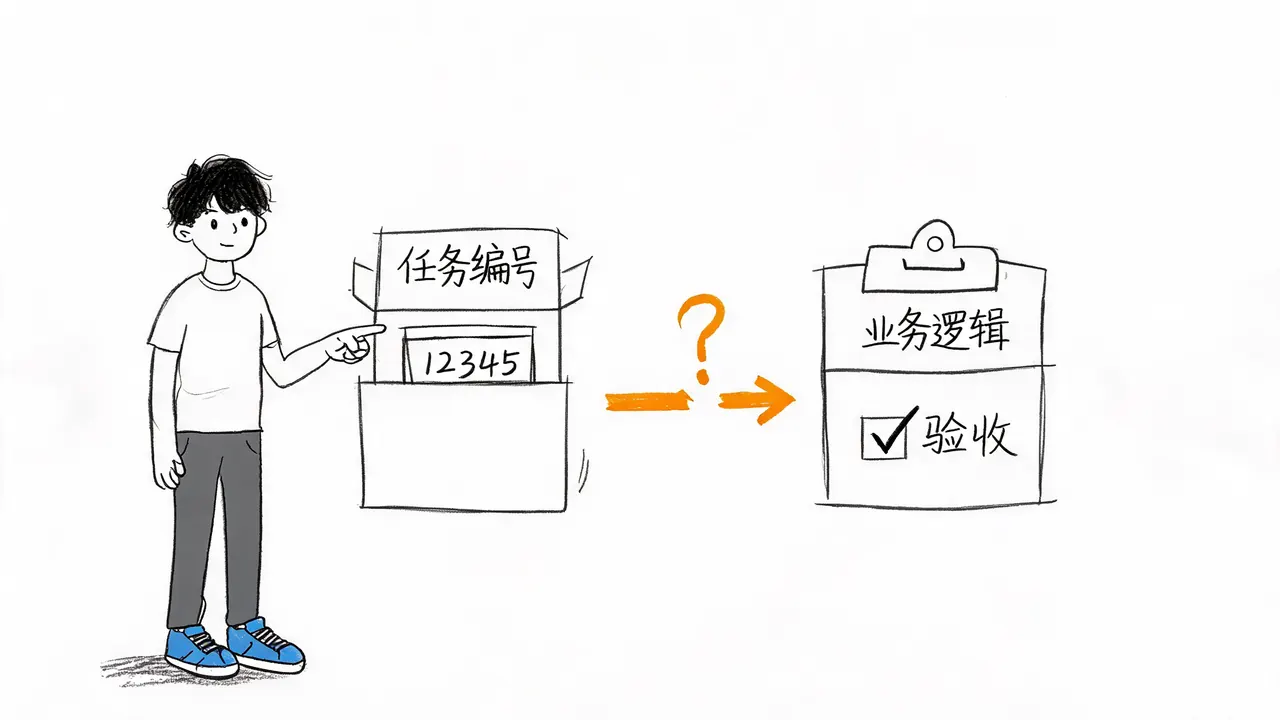
- 系统返回一个任务编号(Task ID)。
- 后台异步处理数据。
- 处理完成后,系统返回文件下载地址。
许多开发者或 Agent 逻辑容易在这里产生误判:拿到任务编号,仅仅证明请求被系统受理了,并不代表业务逻辑已经执行完毕,更不代表结果通过了验收。
即使后续系统真的返回了文件下载地址,也不能直接将其视为最终成功。不同接口中“成功”字段的含义大不相同,绝不能仅凭字段名称(如 status: success)就直接将任务状态升级为“已完成”。
建立明确的状态划分机制
大模型(LLM)擅长根据工具返回的结果组织语言并向用户播报进度,但它缺乏对底层系统状态的深层感知。因此,底层系统必须为模型提供清晰、明确的状态划分,而不是笼统的“成功”或“失败”。
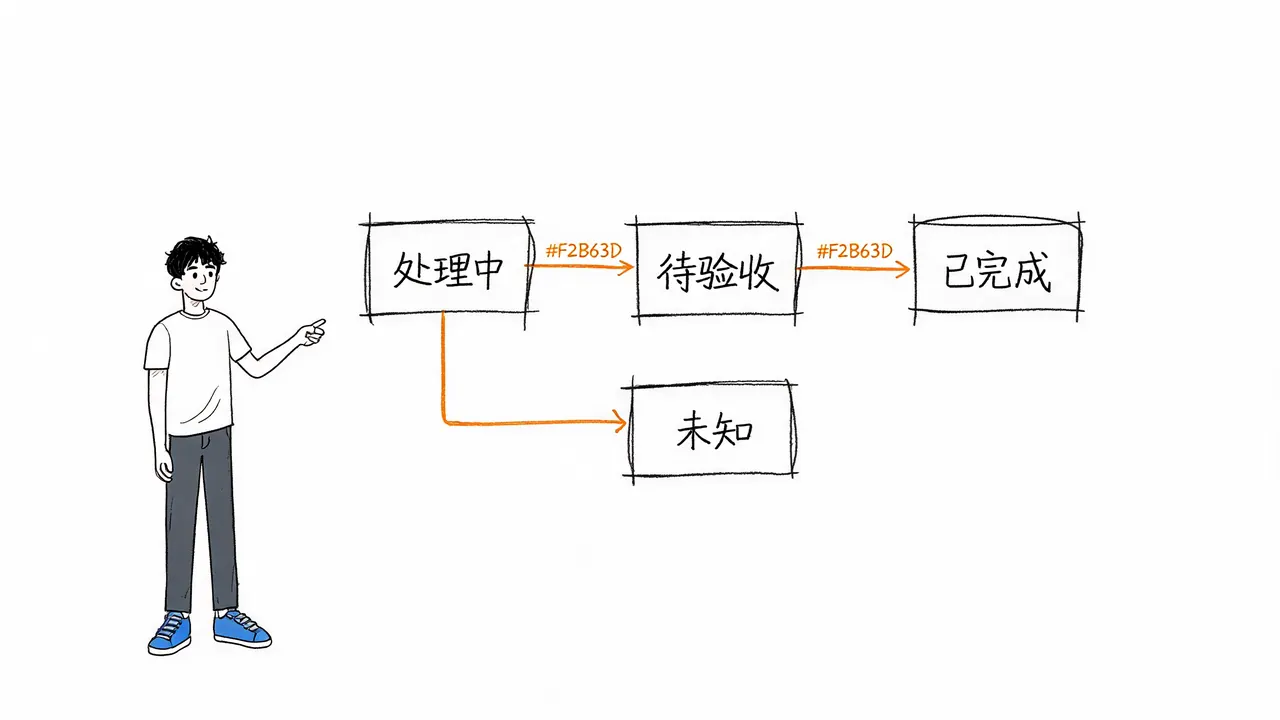
建议的状态机应包含以下明确阶段:
- 处理中 (Processing):任务正在执行。
- 待验收 (Pending Verification):产物已生成,但尚未通过完整性检查。
- 已完成 (Completed):产物已通过所有业务逻辑验证。
- 未知 (Unknown):暂时缺乏明确证据,无法确定状态。
对于暂时缺乏明确证据的环节,系统应允许记录为“未知”状态。这样,模型手中才拥有正确的状态材料来做判断,而不必依靠一句笼统的“成功”去盲目猜测整件事到底发生了什么。
交付物验证:从“有链接”到“可用”
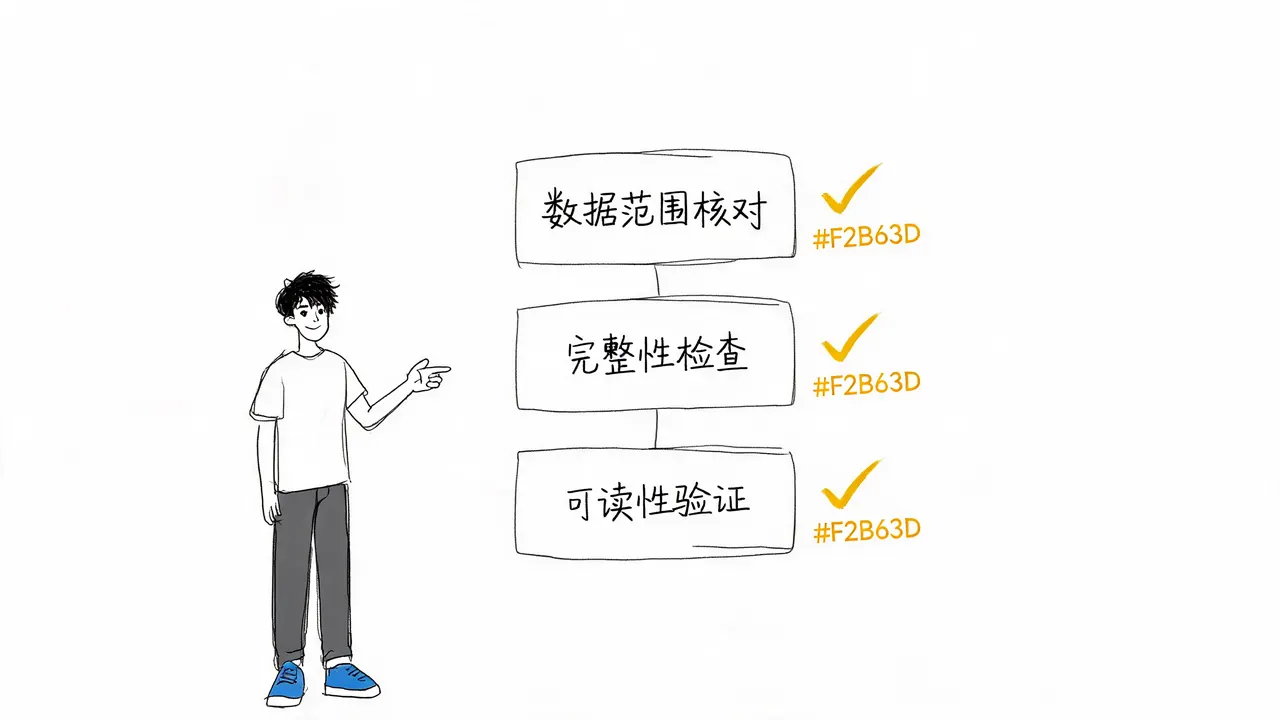
在获得文件下载地址后,必须按照具体的业务逻辑进行严格检查。验证步骤应包括:
- 可读性验证:验证文件是否真的能被正常读取,而非返回 404 或权限错误。
- 完整性检查:确认文件内容是否完整,是否存在截断或空文件情况。
- 数据范围核对:检查导出的数据范围是否符合用户预期(例如时间区间、筛选条件等)。
只有当上述检查全部通过后,才能将任务状态标记为“已完成”。
异常处理与重试策略
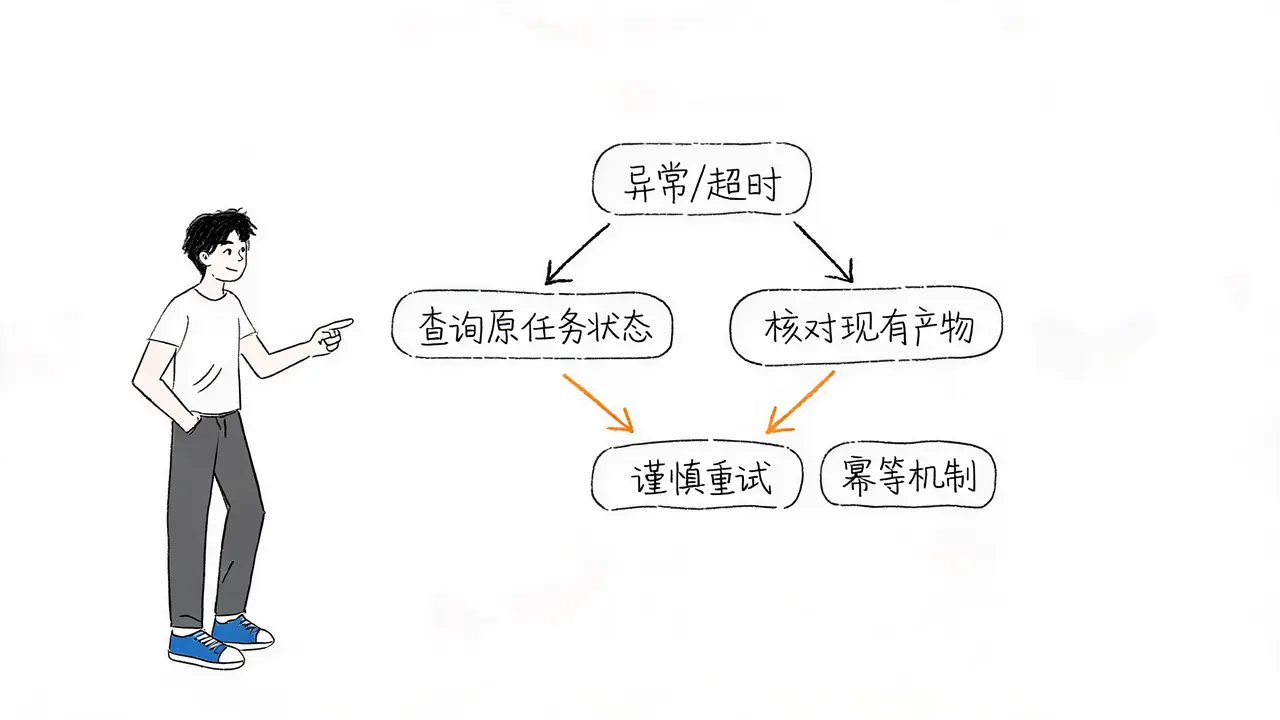
在检查过程中,可能会遇到读取超时等异常情况。此时的处理逻辑至关重要:
- 第一步:查询原任务状态。不要因本地暂时没有拿到结果,就立刻断言远端服务器没有执行操作。应先查询任务在远端的真实状态。
- 第二步:核对现有产物。检查是否已有部分产物生成。
- 第三步:谨慎重试。是否需要发起重试(Retry),以及重试是否会产生重复的导出数据或额外费用,完全取决于接口的具体语义和系统后端的幂等机制(Idempotency)。如果接口不具备幂等性,盲目重试可能导致数据污染或成本增加。
日常开发建议:加入异常测试
为了预防此类问题,建议在验收用例中主动加入异常测试场景,以检查系统是否会提前误报完成:
- 空文件测试:模拟生成空文件,检查系统是否能识别并报错。
- 字段缺失测试:构造返回结果中关键字段缺失的场景。
- 无效链接测试:使用暂时不可用或错误的链接,验证系统的容错能力。
总结
文件生成仅仅是异步任务的一个常见例子。无论处理何种任务,核心原则始终一致:将最终的完成标准严格绑定到用户真正想要拿到的结果上。
无论 Agent 的进度播报听起来多么肯定,都不能代替最后一步的实际交付物检查。只有建立了从“受理”到“验收”的完整闭环,才能避免“假完成”带来的信任危机。