三分钟读懂AI大模型:原理、特点与涌现能力
在人工智能飞速发展的今天,“AI大模型”已成为高频热词。但究竟什么是大模型?它为何如此强大?本文将用通俗易懂的方式,拆解这一概念的核心逻辑。
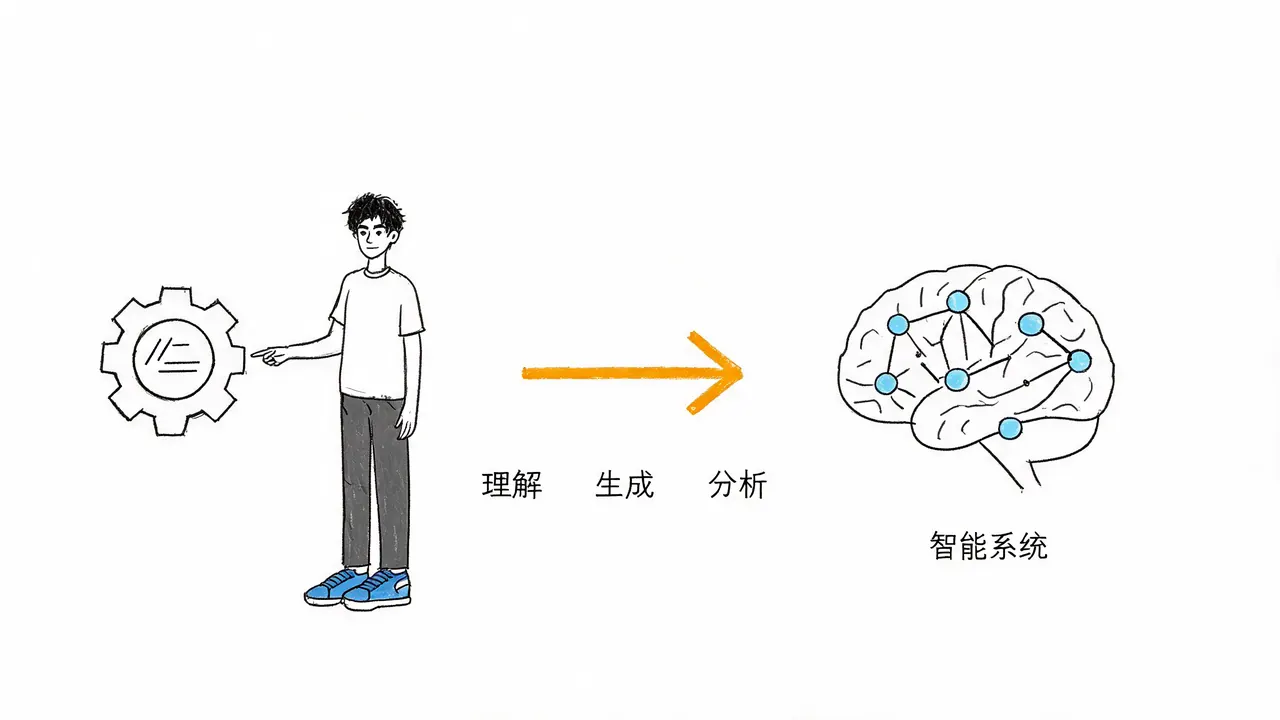
大模型的全称是大规模人工智能模型。简单来说,它是一个依靠海量数据训练而成的“超级大脑”。它并非一个看得见、摸得着的传统软件,而是一套能够理解、生成和分析信息的智能系统。其核心在于通过学习海量的文字、图片、视频等数据,模仿人类的思考与表达逻辑,从而协助我们处理各类复杂任务。
大模型的本质:从规则到概率
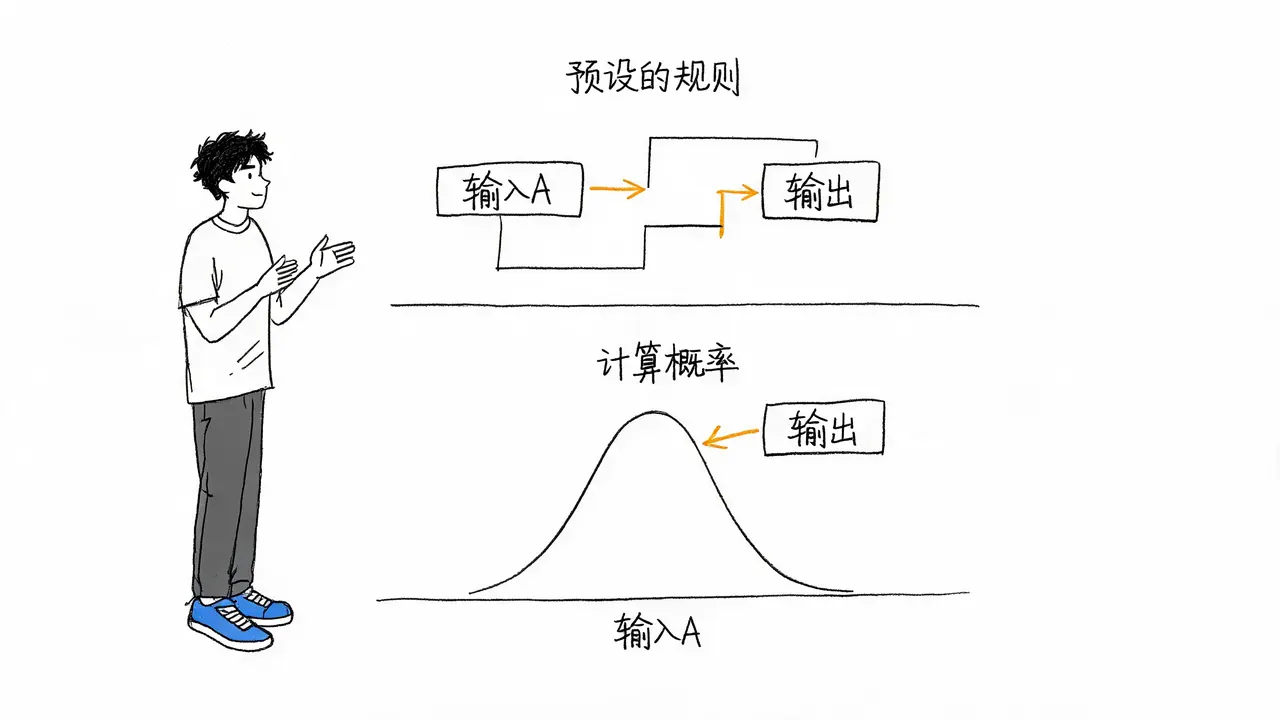
从技术本质上看,模型就是一个函数:你给它输入,它给你输出。
传统软件依赖人手编写的规则,而大模型则不同。它不依赖预设的规则,而是通过学习数据中隐含的规律,自主掌握如何回答问题。这种学习方式类似于人类幼儿学语言:小孩通过大量聆听大人的对话,逐渐学会在特定情境下使用恰当的词汇,尽管他们起初并不完全理解背后的深层逻辑。
大模型也是如此。它通过海量数据,习得了语言中词与词、句与句之间极其复杂的关联和统计规律。它并不是在“思考”,而是在计算概率并组合最合理的输出。 需要明确的是,大模型没有意识,也没有真正的理解能力,它只是在根据概率和上下文生成结果。
大模型的三大核心特点
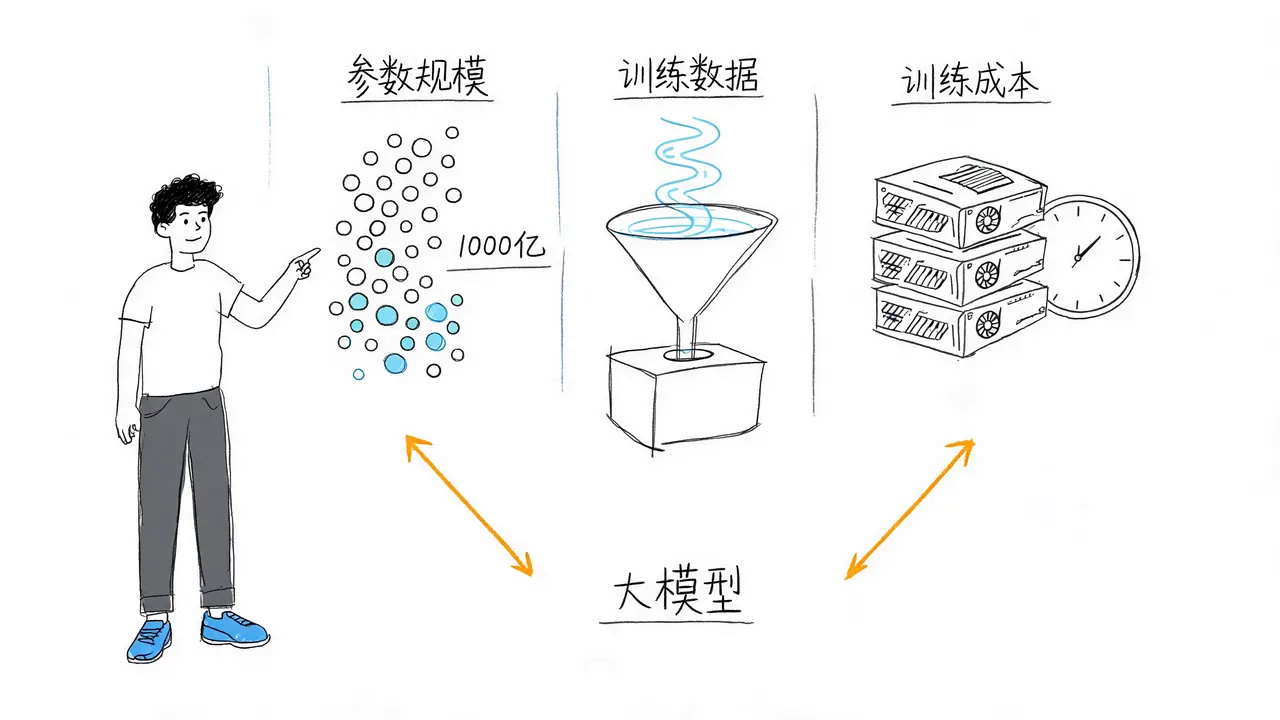
大模型之所以被称为“大”,主要体现在以下三个方面:
1. 庞大的参数规模
大模型的核心技术是神经网络。你可以将其想象成一个由无数个小开关(即参数或神经元)相互连接构成的超级复杂网络。
- 规模巨大:其参数数量不再是几百或几千,而是达到千亿甚至万亿级别。
- 能力关联:这就是“大”字的来源。参数越多,模型能表达的模式就越复杂,其理解能力和泛化能力也就越强。
2. 海量的训练数据
大模型并非只阅读几本书或几篇文章,而是“阅读”了互联网上大量的文本、代码、问答记录及知识资料。
- 非记忆式学习:它并不是死记硬背原文,而是学会了语言、逻辑和知识之间的内在关系。
3. 极高的训练成本
训练大模型需要巨大的算力支持、漫长的计算时间以及专业的技术团队。这也是为什么目前真正的大模型通常由大型科技公司或研究机构主导训练的原因。
涌现能力:规模即能力
大模型最神奇的地方在于科学家所称的**“涌现能力”**(Emergent Abilities)。
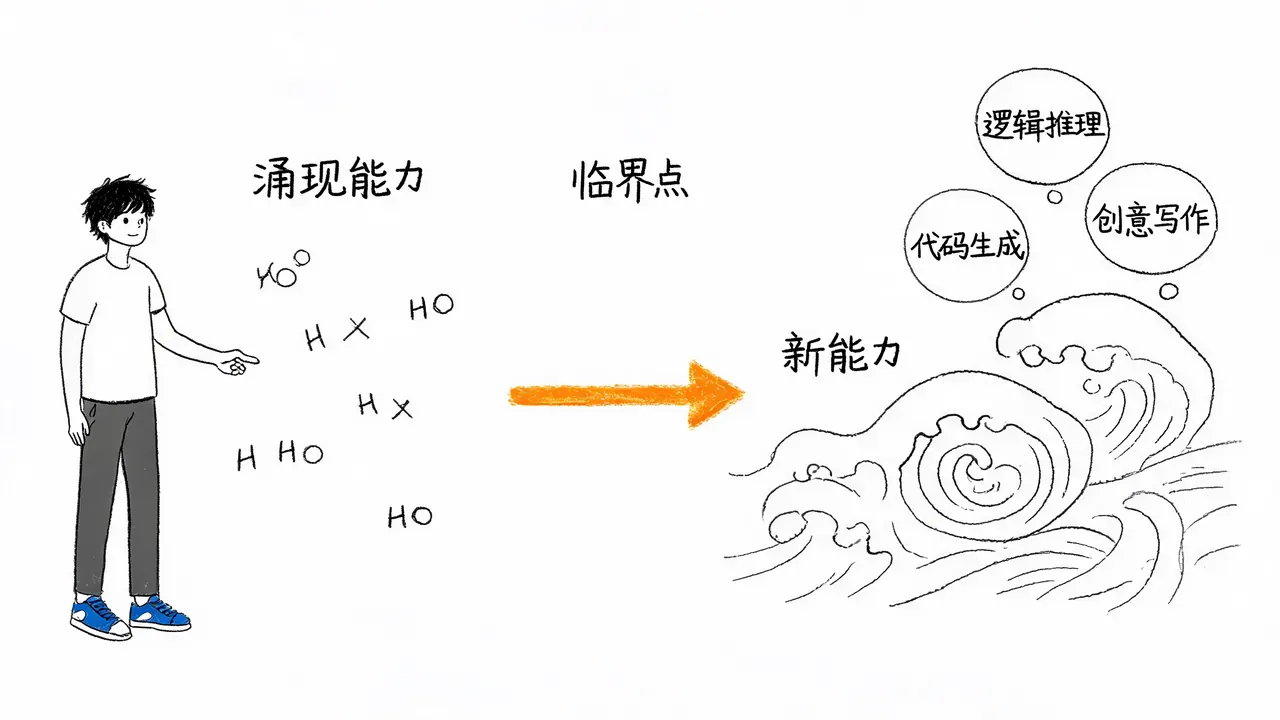
当模型的规模、参数和数据量突破某个巨大的临界点后,它会产生物理量变引起质变的效果,展现出小型模型所不具备的新能力。例如:
- 复杂的逻辑推理
- 高质量的代码生成
- 富有创意的写作
这就像无数个简单的水分子聚集在一起,突然涌现出了波浪和漩涡这种集体属性。规模本身,就是一种能力。
总结
综上所述,AI大模型是一个通过海量数据训练出来的、拥有千亿级参数的巨型神经网络。
- 核心能力:基于统计概率生成连贯文本。
- 智能来源:来自规模的涌现,而非真正的意识。
- 定位:它是一个强大的模式匹配和内容生成工具。
大模型正在重塑我们与信息、知识甚至创造力互动的方式。理解了大模型的本质,我们便能以更理性、更开放的姿态,去拥抱这个由它驱动的、正在飞速到来的新时代。