抖音不靠偷听:揭秘推荐算法背后的双塔与 Wide&Deep 模型
你是否曾有过这样的疑惑:刚和朋友聊到某个话题,打开抖音就刷到了相关内容?这让人不禁怀疑:抖音是不是在偷听?
事实上,抖音并不依赖“偷听”或读取隐私信息来推荐内容。它依靠的是一套精密且高效的核心推荐算法逻辑。这套系统能在毫秒之间完成计算,从海量视频中精准捕捉你的喜好。
抖音安全与信任中心近期上线了“算法体验”板块,以可视化的方式公开了推荐算法的秘密。本文将基于这一官方科普内容,深入解析抖音推荐算法的运作机制。
推荐算法的核心任务:从海量中筛选
当你打开抖音 APP 的那一刻,一场毫秒级的精准计算便已启动。
平台上有千万级甚至亿级的视频内容,而你的屏幕只有一个。推荐算法的核心任务非常明确:从海量内容中,快速挑出你可能喜欢、且大概率愿意停留的内容,并按优先级推送给你。
这一过程并非巧合,而是通过一系列复杂的模型层层筛选与排序实现的。
第一步:双塔模型(Two-Tower Model)—— 特征提取与匹配
推荐系统的第一步是“召回”,即从海量视频中快速筛选出几千个候选作品。这一过程主要依赖双塔模型。
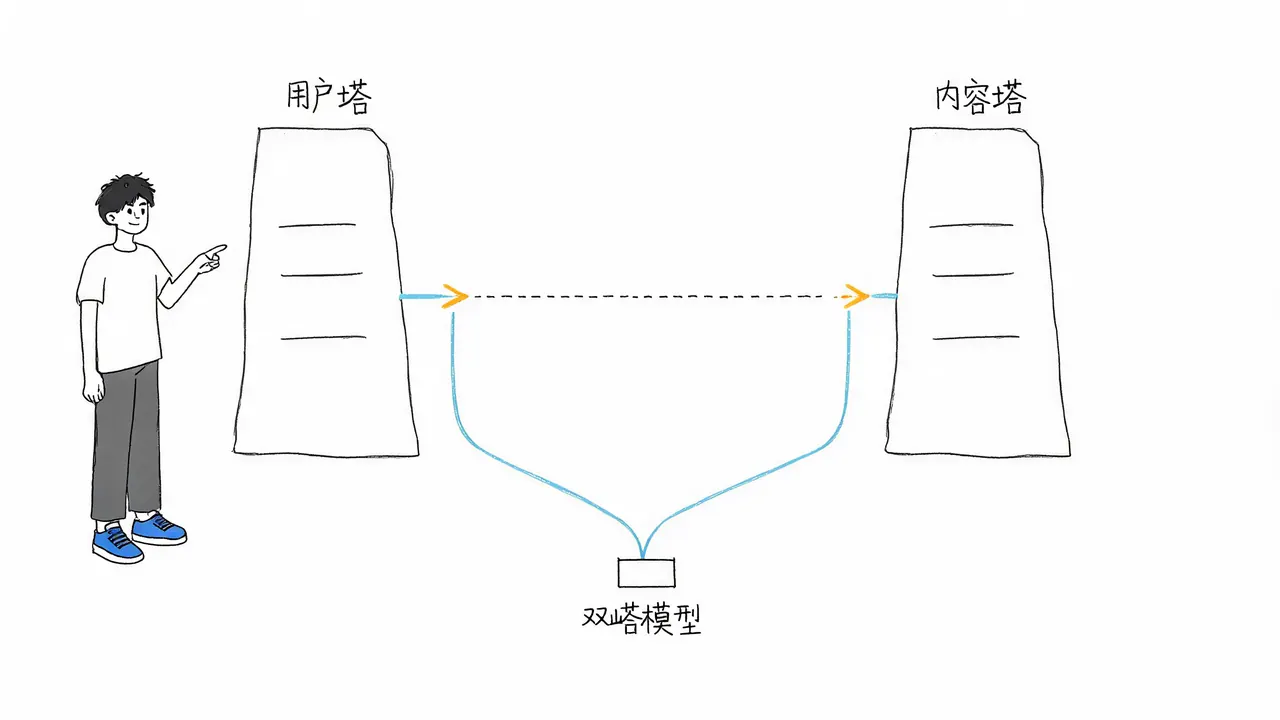
你可以将双塔模型想象成两个独立的特征提取塔:
-
用户塔(User Tower):
- 功能:专门分析你的历史行为。
- 数据源:包括你点赞过的视频类型、停留时长、评论、收藏等。
- 输出:将这些信息浓缩成一串数字,形成用户向量。
-
内容塔(Content Tower):
- 功能:专门分析视频本身。
- 数据源:包括视频的内容特征、标题、文案、画面风格、背景音乐、创作者类型等。
- 输出:同样浓缩成数字,形成内容特征向量。
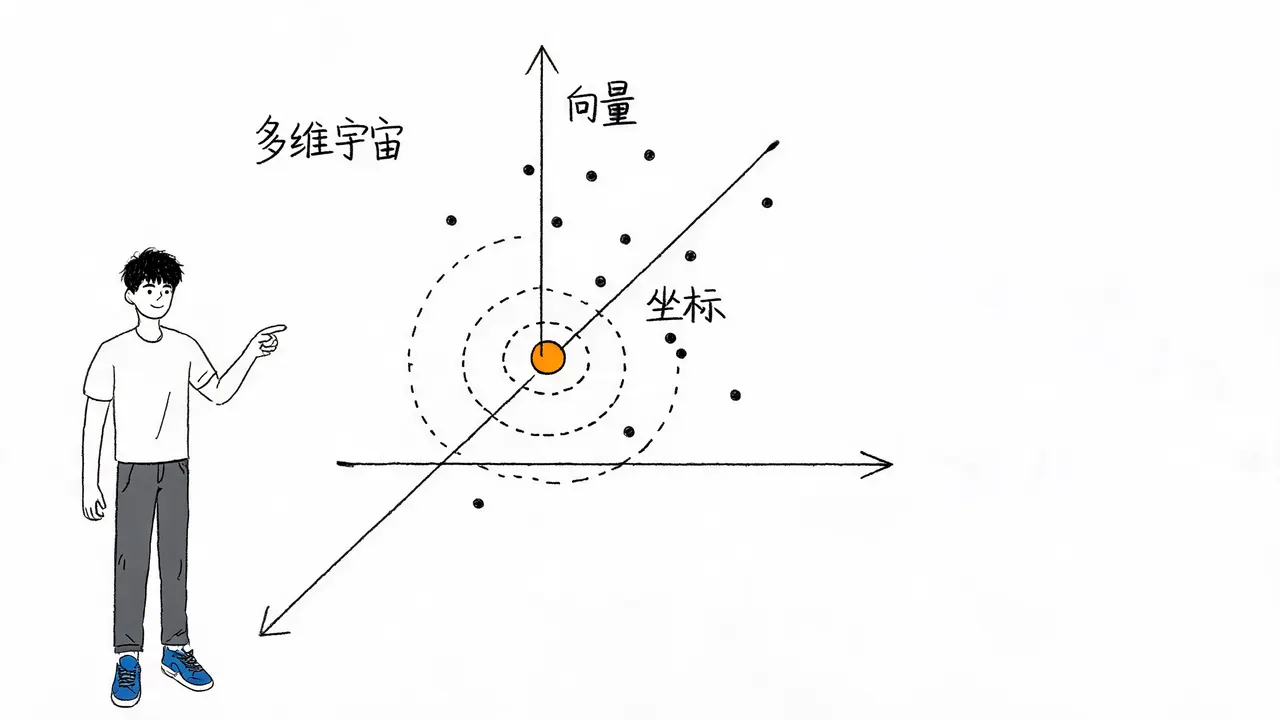
向量:多维宇宙中的坐标
这些由数字组成的向量,类似于地图上的经纬度坐标。如果把推荐系统想象成一个多维宇宙,向量就代表着内容或用户在这个宇宙中的位置。
推荐算法的核心工作,就是计算离“用户坐标”最近的“内容坐标”在哪里。相似度越高,说明该视频越符合你的喜好,从而被纳入推荐候选池。
第二步:Wide&Deep 模型 —— 记忆与探索的平衡
经过双塔模型筛选出的几千个候选视频仍然太多,接下来需要进行排序打分,决定你接下来看到的第一个、第二个、第三个视频分别是什么。
这里涉及到的 Wide&Deep 模型,揭示了算法的另一大目标:帮你发现更多未知的兴趣点。
过去我们常误以为算法只是“你喜欢看什么,就拼命给你推什么”,但 Wide&Deep 模型采取了“记忆 + 探索”双管齐下的策略:
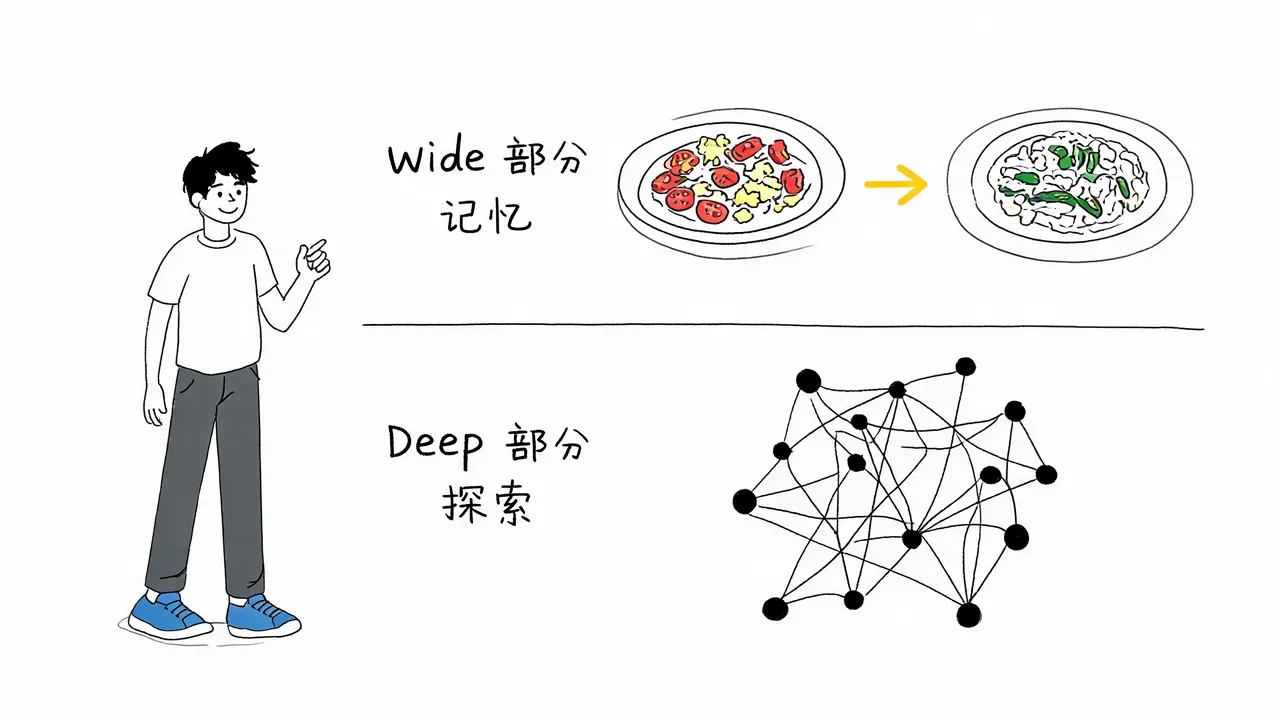
1. Wide 部分:负责“记忆”
- 目标:记录你之前的明确喜好。
- 逻辑:如果你点赞过“番茄炒蛋教程”,Wide 部分会直接关联推荐“鸡蛋炒辣椒”、“番茄炖牛腩”等强相关内容。
- 作用:确保你刷到肯定喜欢的内容,满足已知需求。
2. Deep 部分:负责“探索”
- 目标:挖掘你潜在的兴趣。
- 逻辑:如果你喜欢看“户外露营”,但从未刷过“露营装备测评”,Deep 部分会通过分析与你相似的用户喜好,预判你可能也对装备感兴趣,从而推荐这类潜在需求内容。
- 作用:避免你一直刷同类内容感到厌倦,让你刷到潜在喜欢的内容。
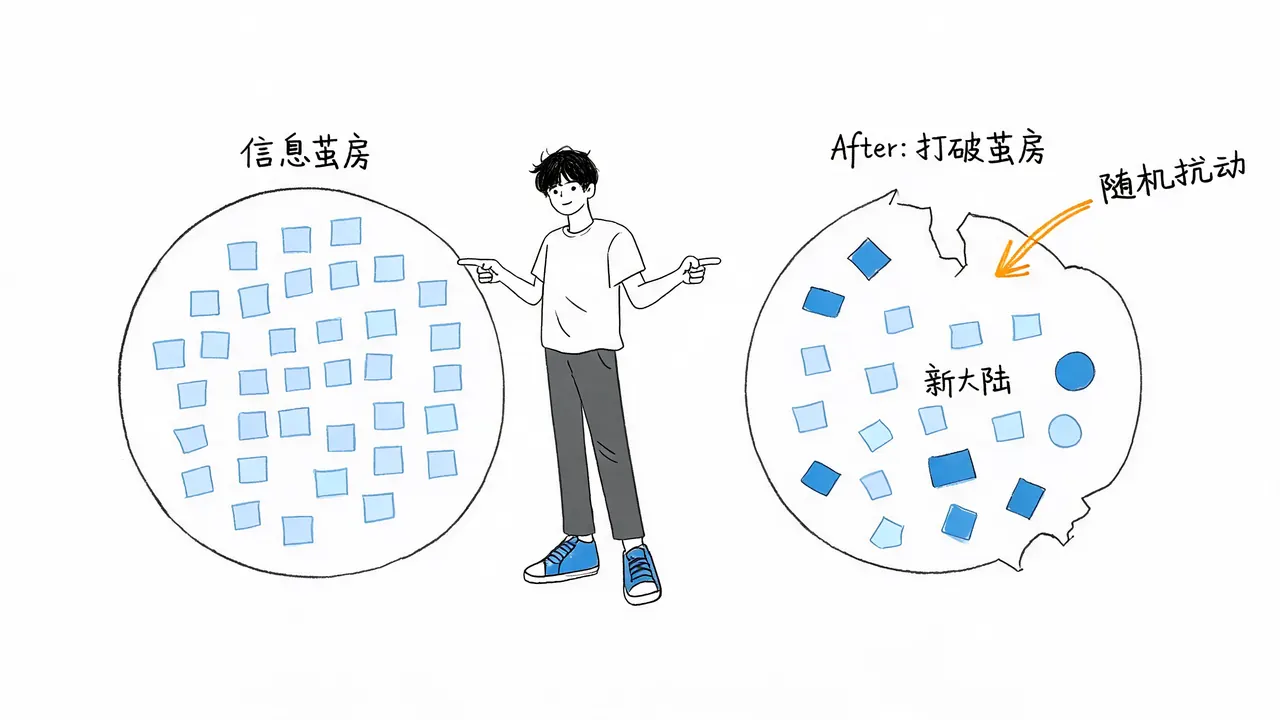
第三步:随机扰动 —— 打破信息茧房
在排序完成后,推荐结果还会经过**随机扰动(Random Perturbation)**处理。
什么是随机扰动?
这是在最终打分时,故意给一些其他内容增加一点随机权重。通过调节扰动强度,系统可以控制推荐中随机内容的比例。
为什么要这样做?
随机扰动是系统故意开的一个“小口子”,其目的有三:
- 试探兴趣边界:测试你对新类型内容的接受度。
- 打破信息茧房:避免用户陷入单一内容的循环。
- 保持系统活力:确保推荐系统始终保持新鲜感,让你偶尔能发现“新大陆”。
结语
实际上,真正落地的推荐系统远比上述流程复杂得多。这里展示的只是其中最核心、也最容易理解的一部分逻辑。
如果你对算法如何工作有更浓厚的兴趣,可以访问抖音安全与信任中心官网,体验其上线的“推荐算法可视化专题模块”。那里有更详细、更系统的算法科普内容,让你亲手点击、观察算法的实时运作。
算法并非黑箱,理解它的逻辑,能让我们更从容地面对数字时代的信息流。