数据库连接池耗尽排查与线上连接泄漏兜底策略
在近期的一次后端开发面试中,一位拥有三年经验的候选人面对“高峰期数据库连接池打满、请求大面积超时”的场景,给出的答案仅仅是“调大最大连接数”。当被进一步追问连接数增大导致数据库性能下降、死锁增多、连接泄漏定位以及流量洪峰下的降级止损策略时,该候选人无法给出有效回答,仅表示依靠加连接数和重启服务保底。
这一案例揭示了普通后端与高级后端之间的核心分水岭:考察的重点并非简单的参数配置,而是数据库资源风险识别与全链路治理的核心能力。许多开发者存在误区,认为只要调大连接数能连上数据库就是会用连接池,却忽略了单机连接池配置与分布式环境下的数据库资源管控及稳定性保障是两个完全不同的技术维度。
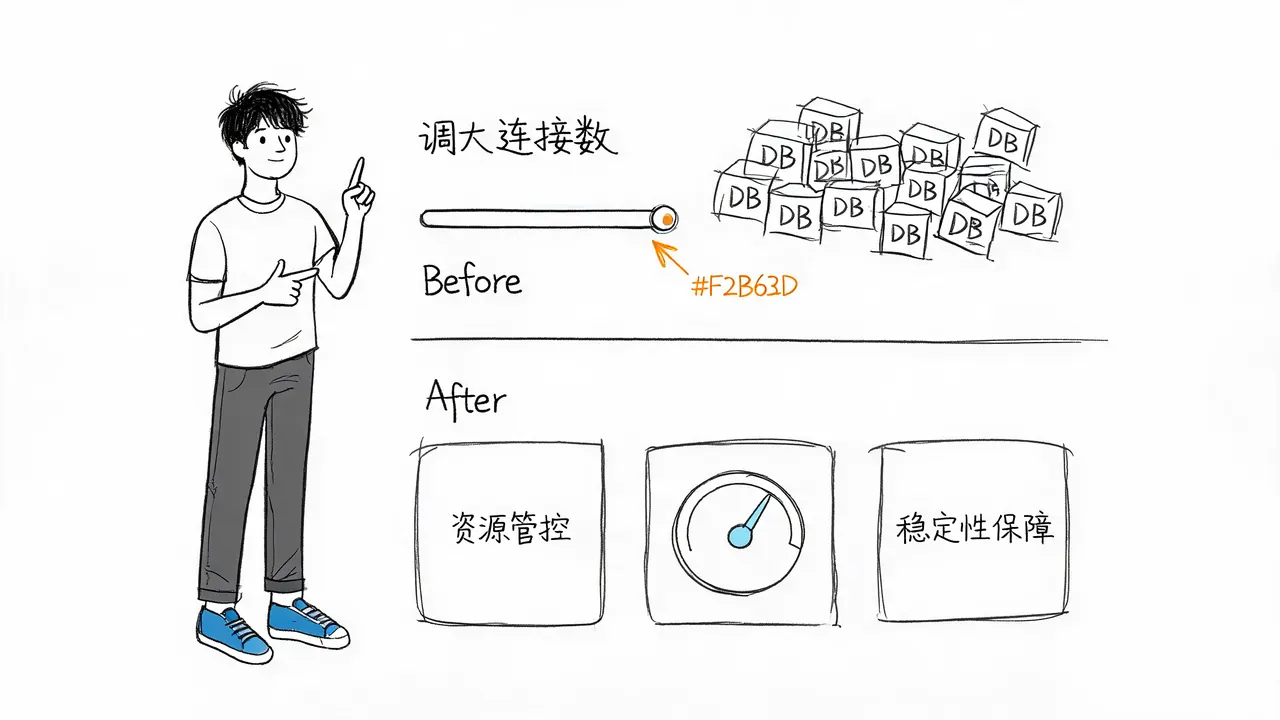
连接池方案的深度拆解与对比
达到高级后端要求的工程师,首先需要对常见的连接池方案(如 HikariCP、Druid、DBCP2、C3P0)有深度拆解与对比能力,不能停留在背诵阶段。重点在于分析它们在性能损耗、监控能力、泄漏检测及高并发容错场景下的优缺点。
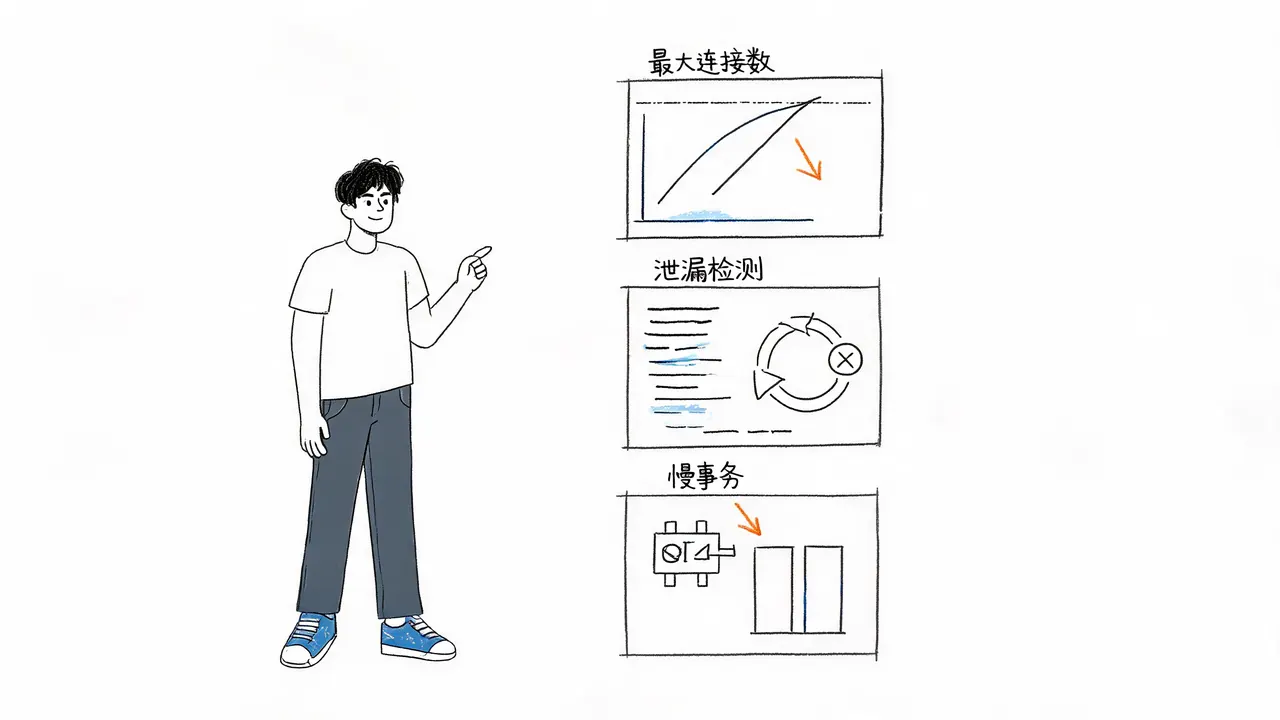
在评估连接池配置时,需重点核查以下三个方面:
- 最大连接数的合理性:确认最大连接数是否基于数据库总连接上限与业务并发量进行了压测评估,而非盲目调大。
- 连接泄漏检测机制:核查是否配置了超时回收与堆栈日志,防止连接长期占用不释放,导致池资源被慢慢吃光。
- 高并发慢事务场景应对:确认是否结合了业务连接池隔离、事务超时熔断及快速失败的组合方案,避免单类慢接口拖垮整个连接池。
连接池风险量化分析
拒绝凭感觉判断“连接够多就没问题”,必须进行风险量化分析。重点监控指标包括:
- 连接池耗尽触发频率
- 连接泄漏速率
- 平均连接持有时长
- 数据库端承载极限
针对核心业务场景,需逐一核对连接池满后的降级策略(快速失败还是排队等待),以及数据库被打挂引发级联故障的风险。同时,评估是否需要引入连接池水位监控、泄漏自动回收及业务分级隔离机制,构建更彻底的资源防护防线。
治理力度应能区分核心业务连接池与非核心业务连接池,将核心资源保障与边缘功能降级解耦,避免非核心请求占用核心数据库资源。
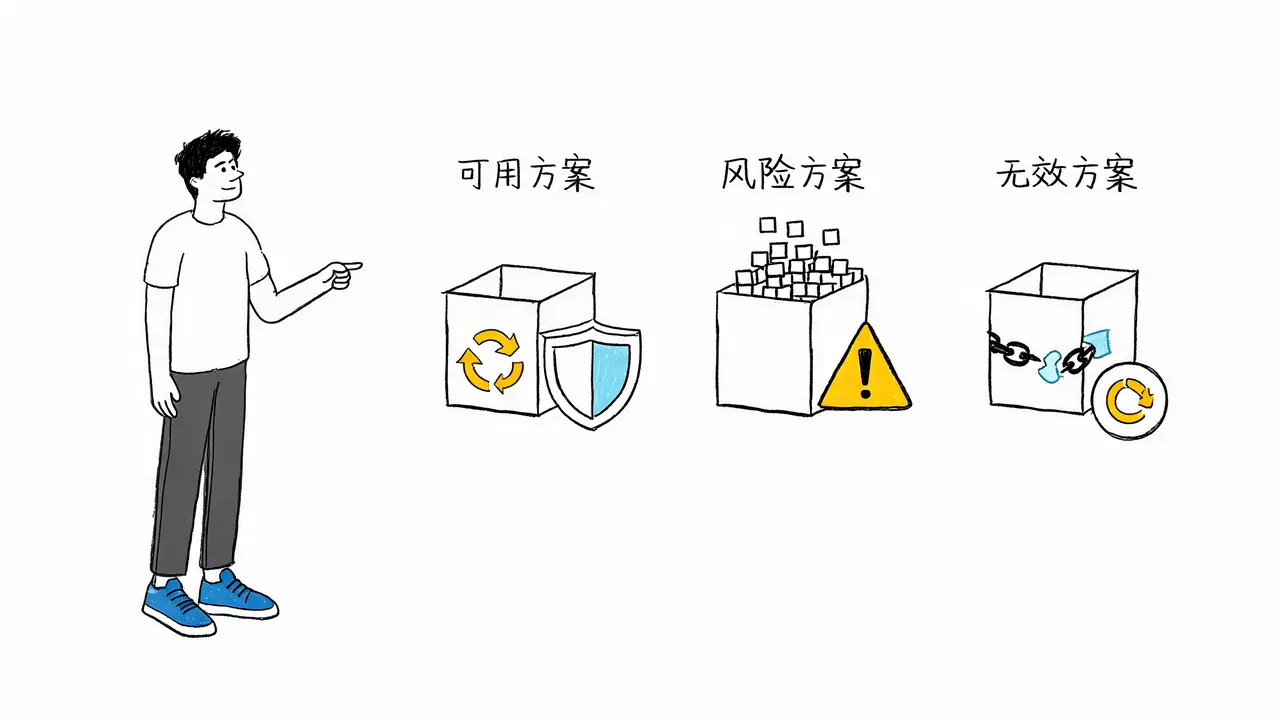
三类典型方案的风险评估
| 方案类型 | 特征描述 | 风险等级 |
|---|---|---|
| 可用方案 | 低风险稳定运行,依靠泄漏检测加超时回收兜底,并持续优化。 | 低 |
| 风险方案 | 只靠调大连接数,不治理慢事务。长事务一出现直接打满池,拖垮数据库。 | 高 |
| 无效方案 | 无监控、无隔离,连接泄漏全靠重启,业务完全裸奔。 | 极高 |
连接池架构的落地规范
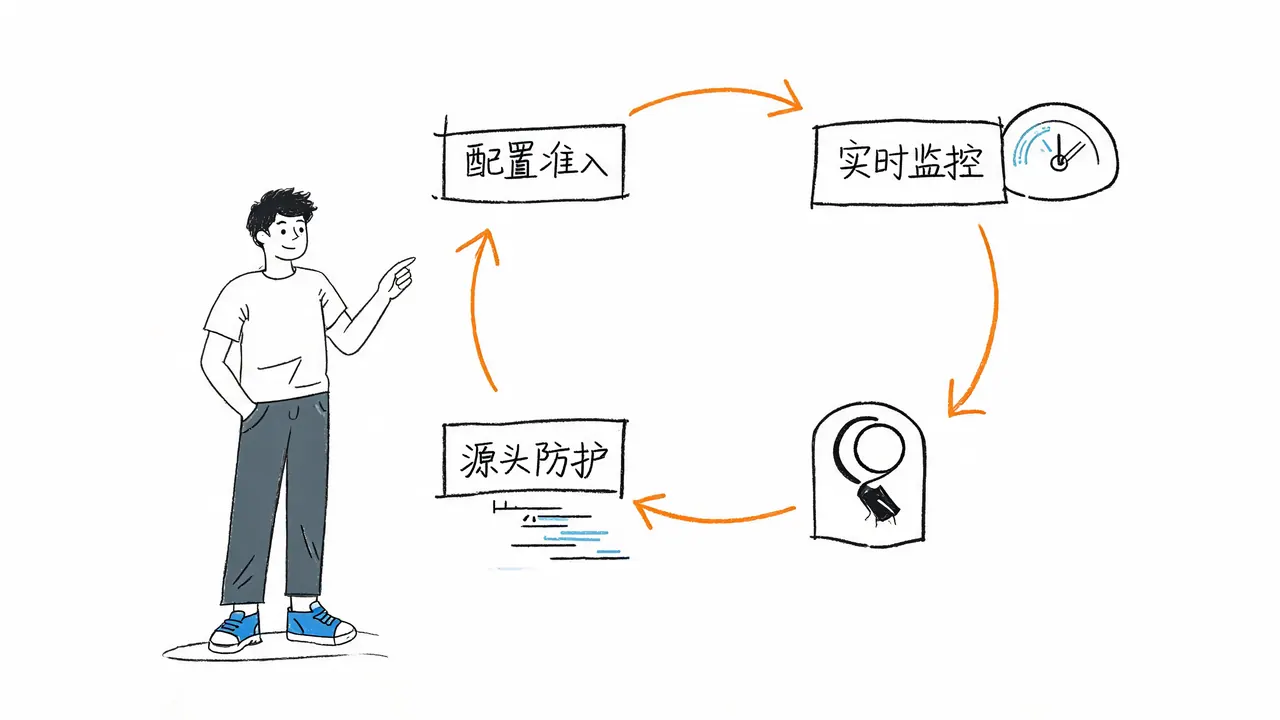
建立专业的连接池架构落地规范,需要从配置准入、监控告警到应急预案形成闭环:
- 建立配置准入标准:制定严禁的高危配置列表,划定单服务连接数占比、单连接池持有时长、事务执行时长的红线。
- 实时监控与告警:实现连接池水位与泄漏的实时监控告警,借助 APM 工具批量排查慢连接与长事务。
- 熔断与降级预案:建立高峰期连接池熔断与分级降级预案。针对订单支付、库存扣减、用户资产等金融级核心链路,沉淀团队的连接池事故复盘知识点与防御性编码约束。
- 源头防护:形成代码规范约束,让生成的代码从源头上内嵌连接池风险防护。禁止将任何无泄漏检测、无超时配置、无资源隔离的连接池代码直接上线。
总结
这道面试题的核心,是从“会配置连接池参数”升级为“能守护数据库连接资源的高可用底线”。
- 普通后端:认为连接数够大、能连上数据库就行。
- 高级后端:会从耗尽预警、泄漏风险、业务容忍度、极端故障下的降级保护等维度,做全链路设计。
通过建立完善的监控、隔离与降级机制,才能有效应对连接池耗尽引发的全链路雪崩事故,确保系统在高并发下的稳定性。